

Python 单线程爬虫实战:抓取课程列表与基础正则解析

本文以抓取公开课程列表为例,详解 Python 单线程爬虫的实现流程。通过观察网址翻页规律构造请求队列,利用 requests 获取 HTML 源码,并结合 re 模块的正则表达式精准剥离课程标题与参与人数,最后将结构化数据写入本地文本。该方法适用于静态页面的基础数据采集学习。
抓取目标与环境准备
本实战的目标是编写一个单线程网络爬虫,自动遍历目标网站的多个分页,提取课程名称与当前参与人数,并将结果保存为本地文本文件。在编写代码前,需要确保终端已安装 Python 3.x 环境,并通过包管理工具安装核心依赖。
# 进入虚拟环境或系统终端
pip install requests
requests 是 Python 生态中最常用的 HTTP 客户端库,无需额外安装 lxml 或 BeautifulSoup 即可完成基础的网页内容拉取。安装完成后即可进入下一步的结构分析。
第1步:分析网页结构与分页规律
打开目标站点课程列表页,观察多页浏览时的 URL 变化。首页地址通常包含固定的分类参数,而翻页时末尾的数字会按页码递增。例如,第一页为 /0-1/,第二页变为 /0-2/,第三页变为 /0-3/。掌握了这一递增规律后,我们便可以通过字符串替换自动生成连续页的请求地址。
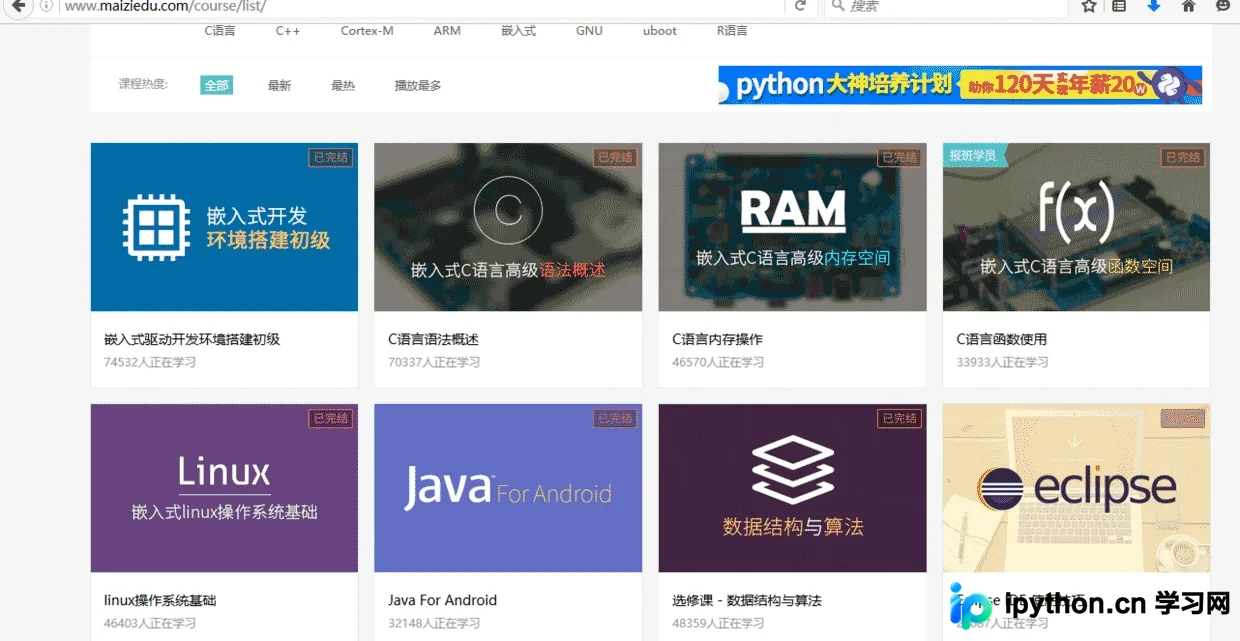
接着使用浏览器开发者工具(审查元素)检查页面源码,定位包含课程数据的容器节点。通常课程列表会被包裹在具有特定 class 名的无序列表 <ul> 中,内部再由 <li> 标签划分每个独立条目。明确节点层级是编写正则表达式的核心依据。
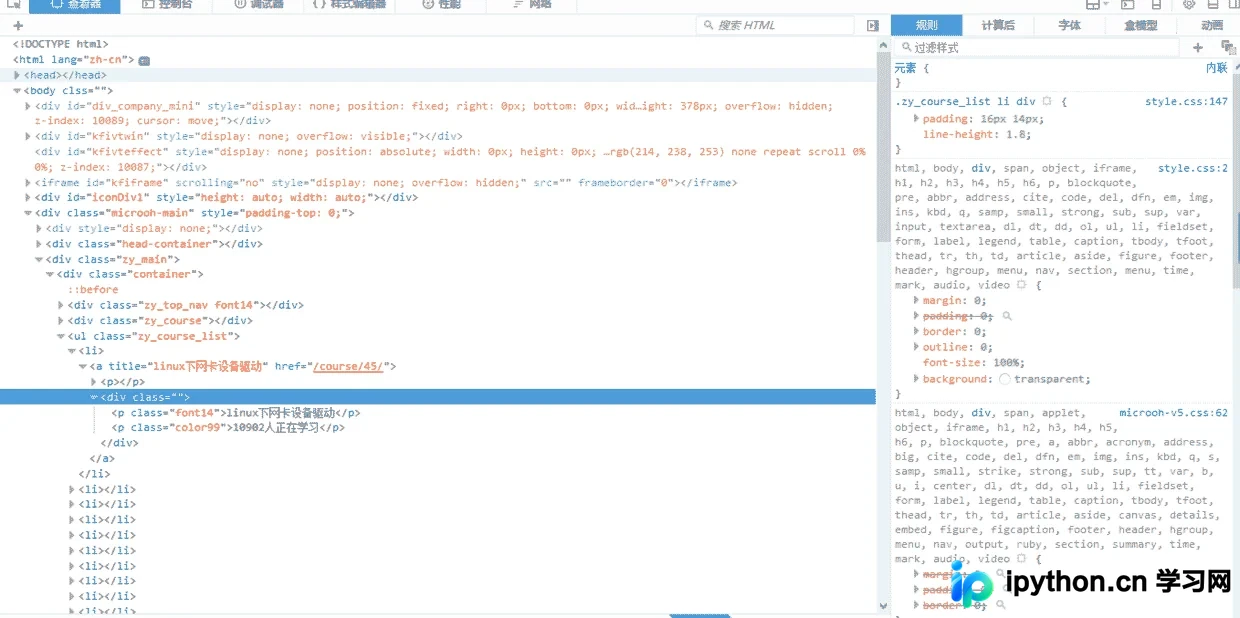
第2步:编写解析逻辑与数据存储模块
结合分页生成规则与 DOM 节点位置,将核心逻辑封装为独立的类结构。代码主要包含四个部分:分页 URL 生成、页面源码获取、正则提取字段、以及数据持久化写入。以下为完整可运行的参考实现:
import re
import requests

class Spider:
    def __init__(self):
        print("开始爬取内容...")

    def change_page(self, url, total_page):
        """根据当前页码生成后续所有分页的完整 URL 列表"""
        nowpage = int(re.search(r'/0-(\d+)/', url).group(1))
        return [re.sub(r'/0-\d+/', f'/0-{i}/', url) for i in range(nowpage, total_page + 1)]

    def get_source(self, url):
        """发送 HTTP GET 请求并返回解码后的网页文本"""
        response = requests.get(url)
        response.raise_for_status()
        response.encoding = 'utf-8'
        return response.text

    def get_classes(self, html):
        """提取课程列表容器内部的 HTML 片段"""
        match = re.search(r'<ul class="zy_course_list">(.*?)</ul>', html, re.DOTALL)
        return match.group(1) if match else ""

    def get_each(self, container):
        """分割出每个课程的独立标签块"""
        return re.findall(r'<li>(.*?)</li>', container, re.DOTALL)

    def get_info(self, item_html):
        """从单个标签块中正则匹配标题与人数"""
        info = {}
        title_match = re.search(r'<a title="(.*?)"', item_html)
        people_match = re.search(r'<p class="color99">(.*?)</p>', item_html)
        info['title'] = title_match.group(1) if title_match else ""
        info['people'] = people_match.group(1) if people_match else ""
        return info

    def save_info(self, data_list):
        """将提取结果逐行追加写入 info.txt 文件"""
        with open('info.txt', 'w', encoding='utf-8') as f:
            for item in data_list:
                f.write(f"title : {item['title']}\n")
                f.write(f"people : {item['people']}\n\n")
        print("数据已保存至 info.txt")

if __name__ == '__main__':
    base_url = 'http://www.maiziedu.com/course/list/all-all/0-1/'
    spider = Spider()
    urls = spider.change_page(base_url, 30)

    all_data = []
    for link in urls:
        html = spider.get_source(link)
        container = spider.get_classes(html)
        items = spider.get_each(container)
        for item in items:
            info = spider.get_info(item)
            all_data.append(info)

    spider.save_info(all_data)
第3步:执行脚本并确认输出文件
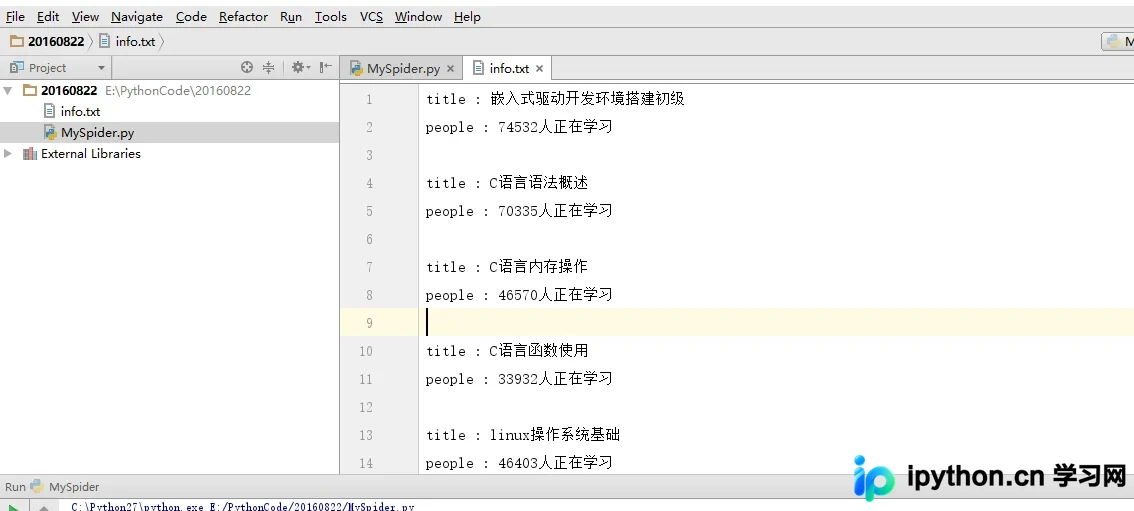
保存上述代码为 spider.py 后,在终端执行 python spider.py 即可启动单次单线程抓取。脚本会依次访问预设的 30 页 URL,完成解析后在当前目录生成 info.txt。执行完毕后可直接打开该文件核对采集到的课程名与学生数。
排错指南与简要总结
在实际运行过程中,若发现提取结果为空或数量异常,可按以下思路排查:
- 正则匹配失效:网站前端框架升级导致 Class 名称或标签结构变更。请使用开发者工具重新复制目标元素的完整选择器,注意转义特殊字符。
- 编码乱码:部分老版本服务器未声明正确 charset。务必在请求后显式指定
response.encoding = 'utf-8'。 - 频率限制:单线程虽不会瞬间压垮服务器,但连续请求仍可能触发 IP 封禁。生产环境中建议加入时间间隔控制或代理池轮换。
以上就是 Python 单线程爬虫基础实战的详细内容,更多关于网页数据抓取与 Python 编程的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









