

Python 实现 URL 重定向并获取真实地址及重试机制
本文介绍在 Python 项目中处理 URL 重定向以获取真实地址的方法。通过 requests 库发送请求并提取最终 URL,同时补充了包含最大重试次数限制和状态码检查的完善代码,确保在网络异常时能自动重试,提高获取真实链接的稳定性。
2026-10-13
6

本文介绍在 Python 项目中处理 URL 重定向以获取真实地址的方法。通过 requests 库发送请求并提取最终 URL,同时补充了包含最大重试次数限制和状态码检查的完善代码,确保在网络异常时能自动重试,提高获取真实链接的稳定性。
本文详解Python Requests库中代理服务器的配置方法。通过安装requests[socksv5]包,利用Heroku搭建代理服务,并在本地1080端口启动Socks服务。文章提供了完整的代码示例,展示如何定义http和https代理字典,解决直接访问受限网站时的报错问题,实现通过代理服务器获取资源的目标。
本文介绍如何在Python3中利用requests库结合IP代理池实现随机IP生成。通过从预设代理列表随机选择IP,配置请求头信息,并访问测试网站验证当前IP。该方法适用于需要隐藏真实IP或进行网络爬虫开发的场景,代码简洁实用,可直接参考使用。
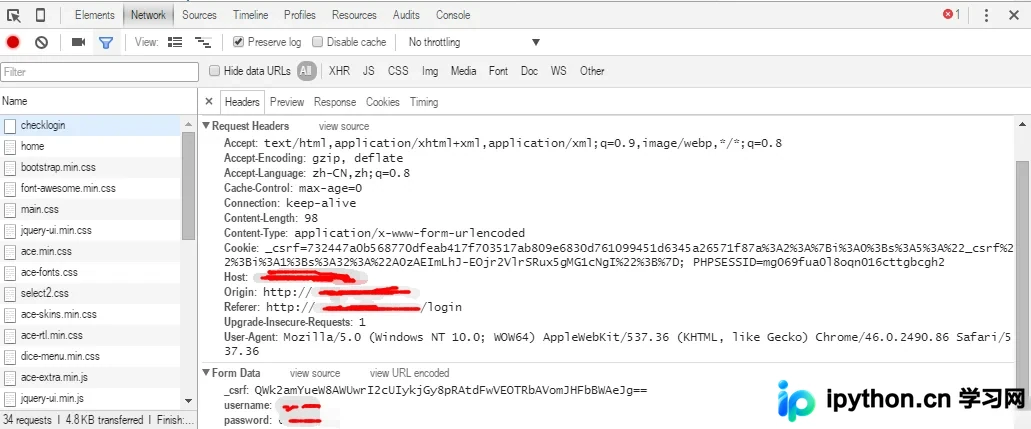
本文详解如何使用Python的Requests库实现网站模拟登录。通过抓取登录请求头与参数,解析CSRF Token机制,并重点解决HTTP无状态导致的身份识别问题。核心方案是利用requests.Session()维持会话状态,自动传递Session ID,从而成功通过服务器验证并获取登录后的页面内容。
本文介绍使用Python Requests库模拟登录图书馆预约系统,通过获取Cookie和隐藏表单字段构造POST请求实现自动预约。结合Crontab定时任务与邮件模块,实现每日自动抢座并发送结果提醒,适用于高校图书馆座位管理系统。
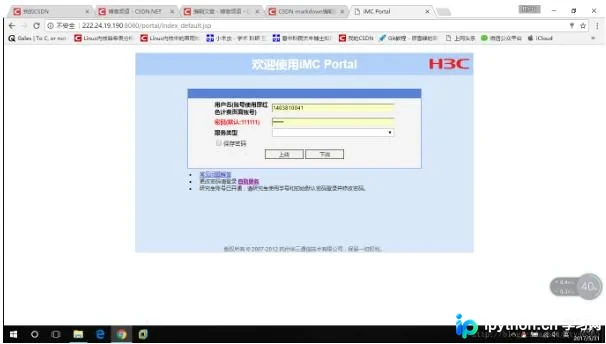
本文介绍如何利用Python爬虫技术解决校园网频繁掉线问题。通过Firefox浏览器抓包获取登录接口、参数及Header信息,结合requests库编写自动登录脚本。脚本包含死循环检测网络状态,断网时自动重新提交POST请求,并可打包为exe实现开机自启,无需手动操作。
本文详细介绍如何利用Python的requests库发起接口请求,并结合unittest框架搭建自动化测试体系。通过封装测试用例、使用TestSuite管理测试集,以及自定义统计逻辑,实现对接口返回码、通过/失败数量的自动化统计与报告生成,为接口测试提供完整的解决方案。
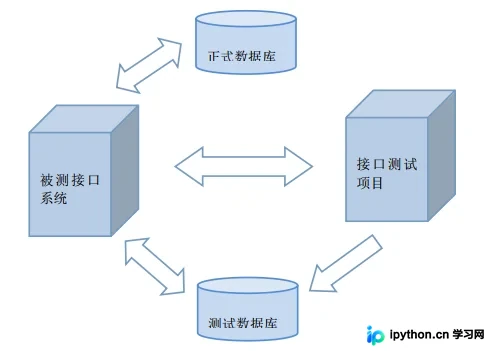
本文详解如何使用Python的Requests库与Unittest框架搭建接口自动化测试系统。针对传统工具在数据控制、加密接口及扩展性上的不足,提出通过独立测试数据库保证数据可控性的设计方案。结合Django后端示例,展示从环境配置、数据库封装到测试用例编写及HTML报告生成的完整流程,实现高效、可扩展的接口自动化测试。
本文介绍如何利用 Python3 结合 requests 库破解服务器端的 Referer 防盗链机制。通过构造包含正确 Referer 字段的 HTTP 请求,并借助 Wireshark 抓包分析获取关键信息,实现指定网站图片的批量下载与保存。
本文详细介绍如何利用Python的Requests库获取网页源码,并结合BeautifulSoup解析HTML结构以提取表格数据。通过定义检查链接、获取内容及保存文件三个核心函数,实现将网页中的表格信息清洗后写入本地CSV文件的完整流程,适合初学者参考学习。
本文详细介绍在Python爬虫开发中应对反爬机制的代理IP设置方法。通过安装requests、bs4和lxml库,构建从免费代理网站抓取IP并随机选取的完整流程。代码演示如何利用random模块生成符合requests格式的代理字典,有效规避真实IP被封风险,提升爬虫稳定性。
本文介绍使用Python进行淘宝商品价格定向爬取的完整流程。通过requests库获取HTML源码,利用正则表达式提取价格和商品标题,并格式化输出结果。代码包含异常处理机制,适合初学者学习网络爬虫基础与数据解析技巧。