

Python实现大学排名数据抓取与展示
本文介绍使用Python爬取最好大学网大学排名的具体代码。通过requests获取HTML,利用BeautifulSoup解析表格数据,并将排名、学校名称及总分等信息格式化输出,供学习者参考。
2026-10-13
6

本文介绍使用Python爬取最好大学网大学排名的具体代码。通过requests获取HTML,利用BeautifulSoup解析表格数据,并将排名、学校名称及总分等信息格式化输出,供学习者参考。
本文解析Python中使用Requests库配置HTTPS代理时遇到的证书验证问题。通过设置verify=False关闭SSL证书校验,并介绍如何禁用urllib3的InsecureRequestWarning警告,确保代理流程稳定运行且无冗余报错输出。
本文详细解析使用Python3爬取淘宝商品信息的完整代码流程。通过requests获取网页源码,利用正则表达式精准提取价格、名称、地址及图片链接,并展示如何遍历多页数据并格式化输出结果。代码包含异常处理机制,适合初学者理解网络爬虫的基本逻辑与实现细节。
本文提供一段Python实现12306登录功能的示例代码。通过requests库发起会话,获取验证码图片并保存,用户手动输入坐标后提交登录请求。代码包含必要的库导入、会话管理及简单的验证码坐标映射逻辑,供参考学习。
本文详解Python爬虫中GET与POST请求的区别及适用场景,重点解析Cookie在维持会话状态中的作用。通过163邮箱实例,演示如何利用Requests库发送请求,并解决SSL证书过期导致的SSLError问题,提供verify=False的解决方案及完整代码示例。
本文详细介绍Python中requests库发送POST请求的三种常见方式:以form表单形式提交数据、以json字符串提交数据以及通过multipart形式上传文件。通过具体代码示例和响应结果分析,帮助开发者掌握不同Content-Type下的POST请求实现方法。
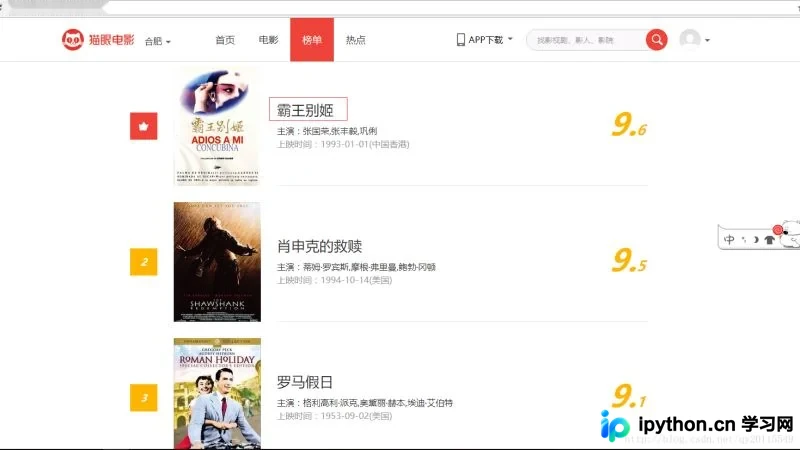
本文详细介绍如何使用Python的requests模块发起HTTP请求获取HTML源码,并结合BeautifulSoup库解析网页结构。通过抓取猫眼电影Top100榜单的具体案例,演示安装依赖、构造请求及提取电影标题与链接的完整流程,提供可直接运行的代码示例。
本文介绍在Python中使用requests库访问HTTPS接口时遇到的SSL证书验证问题。通过配置cert参数尝试使用非标准密钥文件(如server.key.unsecure)验证失败,改用标准密钥需手动输入密码。最终采用将verify设为False跳过验证的临时方案解决交互问题,适用于开发测试环境。
本文提供基于Python的股票信息爬取示例,涵盖基础抓取逻辑及加入进度条优化的完整代码。通过requests和BeautifulSoup解析网页,提取股票列表及详细信息并保存至文件。示例展示了如何处理编码、异常捕获及实时进度反馈,供开发者参考学习网络数据采集技巧。
本文详细介绍如何使用Python编写HTTP接口自动化测试脚本。通过读取Excel中的测试用例,利用requests库发送POST或GET请求,并将返回结果与预期值对比。若不一致,自动将Bug提交至BugFree系统,同时更新Excel中的测试结果与报文信息。

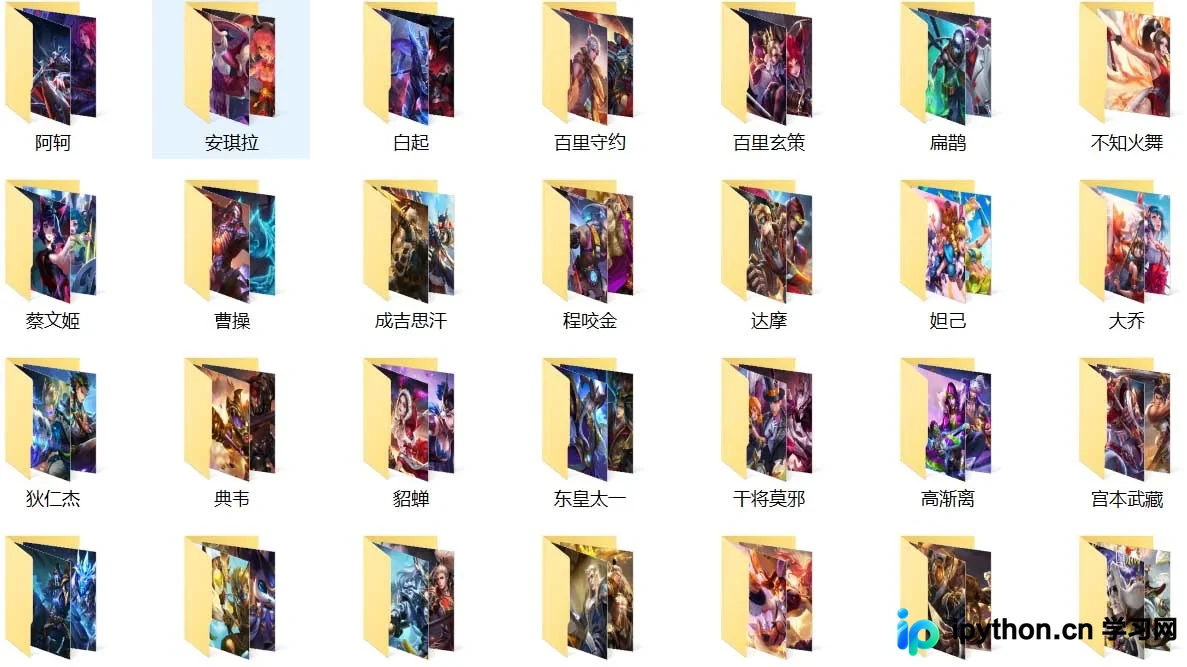
本文介绍如何使用Python的requests库爬取王者荣耀官网数据,批量获取所有英雄的皮肤图片。通过将图片按英雄分类存入本地文件夹,方便用户制作桌面壁纸。代码基于Python3.6测试通过,虽未使用多线程导致耗时数分钟,但逻辑清晰,后续可优化为多线程执行。
本文介绍使用Python抓取亚马逊书籍基本信息的完整流程。通过构造包含node参数的GET请求获取搜索结果页,利用正则表达式解析书名、作者、封面等字段,并将结果写入MySQL数据库。代码展示了从请求构造到数据入库的核心逻辑,适用于需要批量采集书籍元数据的场景。