

Python Requests实现模拟登录:解决CSRF与Session会话保持

本文详解如何使用Python的Requests库实现网站模拟登录。通过抓取登录请求头与参数,解析CSRF Token机制,并重点解决HTTP无状态导致的身份识别问题。核心方案是利用requests.Session()维持会话状态,自动传递Session ID,从而成功通过服务器验证并获取登录后的页面内容。
此前在利用Python抓取网页数据时,主要采用GET请求方式获取页面,随后借助正则表达式进行内容过滤。
本次尝试模拟登录个人网站,发现操作流程相对简便。阅读并理解本文内容,要求读者具备HTTP协议及HTTP会话相关的基础知识。
特别说明:由于演示对象为作者的个人网站,下文代码中涉及的网站地址及账号密码信息已做脱敏处理。
网站分析
开展爬虫工作的首要步骤是深入分析目标网站。此处借助谷歌浏览器的开发者工具进行抓包分析。
通过执行登录操作并抓取网络请求,观察到如下请求结构。
请求部分包含请求头与请求体参数。从截图中可见,页面通过表单提交了三个关键参数,分别为_csrf、username和password。
其中_csrf参数旨在防御跨站请求伪造攻击。其原理较为直观:服务器在每次响应中生成一串加密字符串,并将其嵌入隐藏的input表单中。当用户发起后续请求时,需将该字符串一并提交,以此验证请求是否源自同一用户。
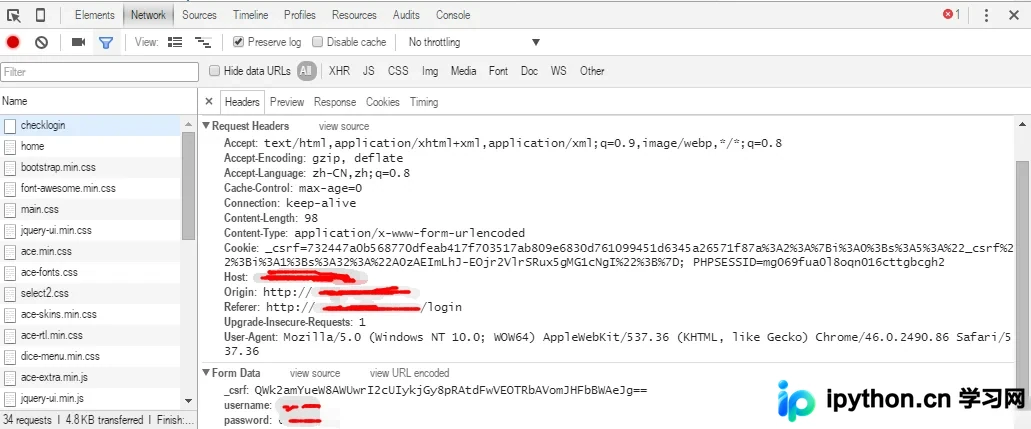
基于上述分析,代码逻辑应遵循以下步骤:首先请求登录页面,接着解析页面以提取_csrf字符串,最后将该字符串与账号密码组合发送至服务器以完成登录。
第一份代码
#!/usr/bin/env python2.7
# -*- coding: utf-8 -*-

import requests
import re

# 头部信息
headers = {
 'Host':"localhost",
 'Accept-Language':"zh-CN,zh;q=0.8",
 'Accept-Encoding':"gzip, deflate",
 'Content-Type':"application/x-www-form-urlencoded",
 'Connection':"keep-alive",
 'Referer':"http://localhost/login",
 'User-Agent':"Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/46.0.2490.86 Safari/537.36"
}

# 登陆方法
def login(url,csrf):
 data = {
 "_csrf" : csrf,
 "username": "xiedj",
 "password": "***"
 }

 response = requests.post(url, data=data, headers=headers)
 return response.content


# 第一次访问获取csrf值
def get_login_web(url):
 page = requests.get('http://localhost/login')
 reg = r'<meta name="csrf-token" content="(.+)">'
 csrf = re.findall(reg,page.content)[0]
 login_page = login(url,csrf)
 print login_page


if __name__ == "__main__":
 url = "http://localhost/login/checklogin"
 get_login_web(url)
代码逻辑看似无误,但执行时却报错。经核查,错误根源在于_csrf验证失败。
在反复确认获取的_csrf值与登录请求中的_csrf字符串均无误后,引发思考: 若读者尚未发现错误原因,此处可暂停思考一个问题:“服务器如何判定获取_csrf的第一次请求与执行POST登录的第二次请求来自同一用户?”
至此,问题已明晰:若要登录成功,必须解决如何让服务器信任两次请求来自同一用户的问题。这涉及到HTTP会话机制(若不了解可自行查阅,此处仅作简要介绍)。
HTTP协议本质上是一种无状态协议。为使无状态交互具备状态感知,引入了会话机制。简而言之,系统通过session来记录状态。当用户首次请求Web服务时,服务器生成一个session以保存用户信息,并在返回响应时将sessionID存入cookies。当用户再次发起请求时,浏览器会自动携带该cookies,从而使服务器能够识别多次请求是否属于同一用户。
因此,代码逻辑需调整为:在第一次请求时获取sessionID,并在第二次请求时将其一同发送。Requests库的强大之处在于,仅需一行简单的requests.Session()即可创建会话对象,自动处理这一过程。
第二份代码
#!/usr/bin/env python2.7
# -*- coding: utf-8 -*-

import requests
import re

# 头部信息
headers = {
 'Host':"localhost",
 'Accept-Language':"zh-CN,zh;q=0.8",
 'Accept-Encoding':"gzip, deflate",
 'Content-Type':"application/x-www-form-urlencoded",
 'Connection':"keep-alive",
 'Referer':"http://localhost/login",
 'User-Agent':"Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/46.0.2490.86 Safari/537.36"
}

# 登陆方法
def login(url,csrf,r_session):
 data = {
 "_csrf" : csrf,
 "username": "xiedj",
 "password": "***"
 }

 response = r_session.post(url, data=data, headers=headers)
 return response.content


# 第一次访问获取csrf值
def get_login_web(url):
 r_session = requests.Session()
 page = r_session.get('http://localhost/login')
 reg = r'<meta name="csrf-token" content="(.+)">'
 csrf = re.findall(reg,page.content)[0]


 login_page = login(url,csrf,r_session)
 print login_page


if __name__ == "__main__":
 url = "http://localhost/login/checklogin"
 get_login_web(url)
成功获取登录后的页面内容
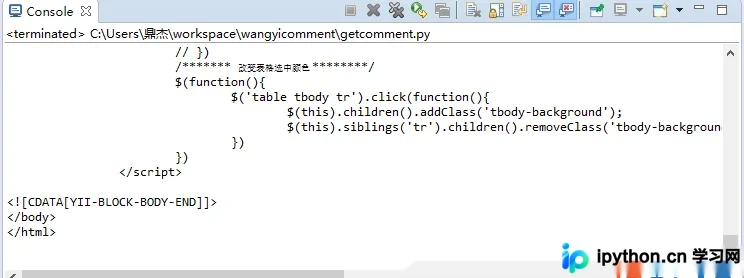
从代码可见,使用requests.Session()启动会话对象后,后续的第二次请求会自动携带上一次的sessionID,无需手动传递。
以上即为本文的全部内容,希望对各位的学习有所帮助,也欢迎大家继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









