

Python(PyS60)实现简单语音整点报时
本文介绍了在PyS60环境下使用Python实现整点语音报时的具体代码。重点解析了PyS60定时器最大2147秒的限制及处理逻辑,通过分段定时确保整点准确触发。代码包含时间解析、语音合成及配置加载功能,适用于S60平台手机开发参考。
2026-10-13
11

本文介绍了在PyS60环境下使用Python实现整点语音报时的具体代码。重点解析了PyS60定时器最大2147秒的限制及处理逻辑,通过分段定时确保整点准确触发。代码包含时间解析、语音合成及配置加载功能,适用于S60平台手机开发参考。
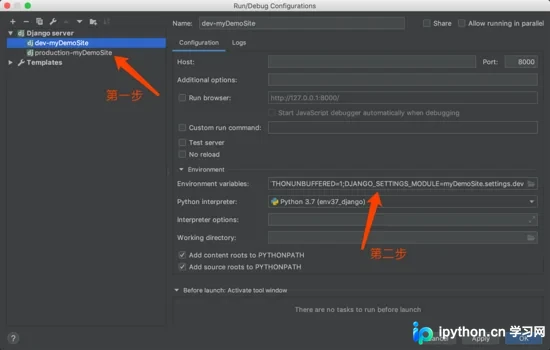
本文详解Django项目的配置优化策略,重点介绍如何通过拆分多个setting文件来区分开发与生产环境,解决配置冲突问题。同时,结合django-environ库,演示如何利用.env文件安全存储数据库连接等敏感信息,并提供命令行与IDE指定配置文件的实操步骤,帮助开发者提升项目可维护性与安全性。
本文介绍如何使用wxPython结合PyAudio库实现整点报时应用。通过创建图形界面显示当前时间,利用wx.Timer每秒刷新,并在整点时刻读取本地WAV文件进行音频播报。代码涵盖界面布局、计时器绑定及音频流处理,适合Python GUI开发初学者参考。
本文详解Python中filter函数的两种用法。当第一个参数为None时,自动剔除None、False、0及空序列等假值;若需进一步处理含空格字符串或进行特定替换,可传入自定义函数或lambda表达式,实现更灵活的列表过滤与数据清洗。
本文深入解析Python中处理XML文件的三种主流方式:基于DOM树的xml.dom.minidom、轻量高效的ElementTree以及事件驱动的SAX。通过对比内存占用、执行速度及调试便利性,结合movie.xml实例代码,帮助开发者根据文件规模与需求选择最优解析方案,涵盖从基础遍历到高级回调函数的完整应用指南。
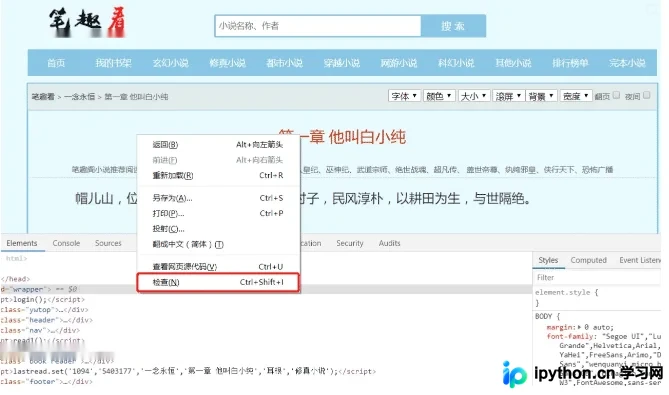
本文详细介绍如何使用Python编写爬虫程序,从笔趣网爬取小说《一念永恒》。重点讲解BeautifulSoup库的安装与使用,包括通过开发者工具定位HTML元素、构造带User-Agent的HTTP请求以及解析响应数据的具体步骤。旨在帮助初学者掌握基础的网络数据采集技巧,同时强调支持正版阅读的重要性。
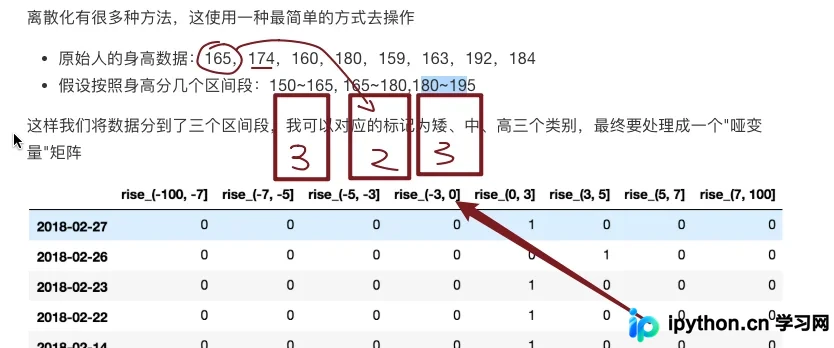
本文详解Pandas中数据离散化的原理与实现,通过股票涨跌幅数据案例,演示如何利用pd.cut进行等宽分箱和pd.qcut进行等深分箱。内容涵盖自定义区间设置、分组统计及代码实现,帮助开发者简化连续数据结构,提升模型泛化能力。
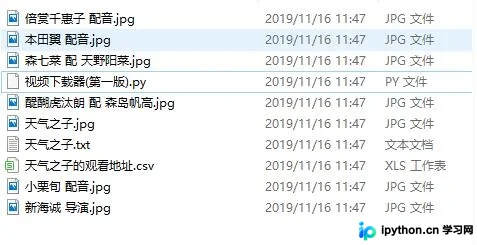
本文详细介绍如何使用Python的pyquery库爬取豆瓣电影信息。通过示例代码展示如何获取电影源代码、解析链接并提取观看地址。文章包含完整代码逻辑及输入“天气之子”、“独立日”等电影名的运行结果截图,强调仅上映电影可获取观看链接,为Python学习者提供实用的爬虫参考。
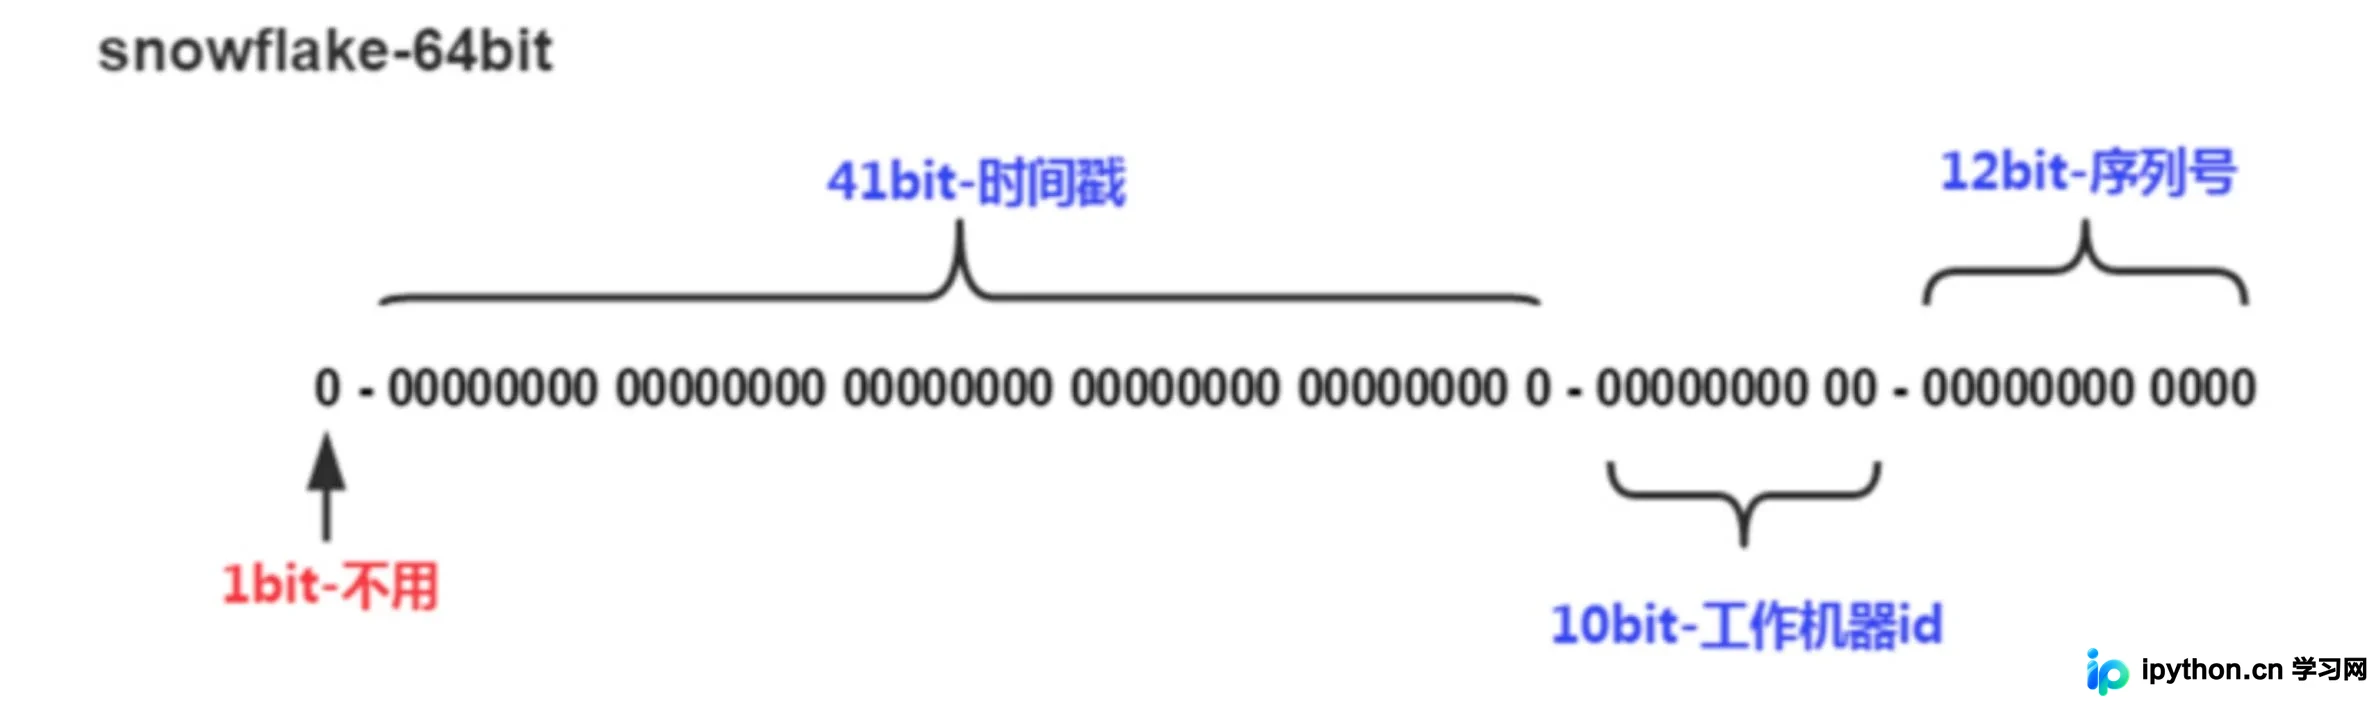
本文详解基于Python实现Twitter Snowflake雪花算法的过程。文章解析了64位ID中符号位、时间戳、机器ID及序列号的划分标准,并结合高QPS场景演示如何自定义位分配以优化扩展性。重点介绍了通过抛出InvalidSystemClock异常来处理时钟回拨问题,确保ID生成的唯一性与系统稳定性。
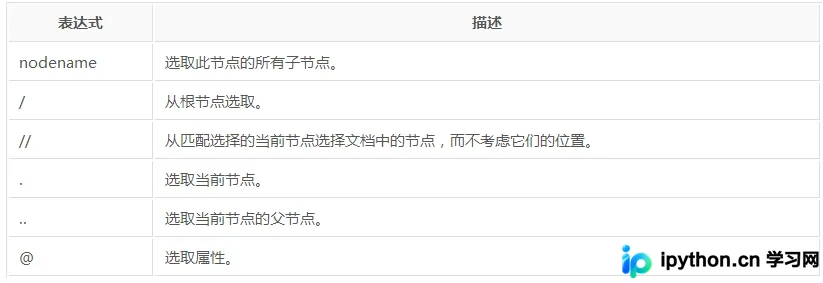
本文详细介绍Python中lxml库解析HTML文件的方法。涵盖DOM节点创建与属性获取、XPath绝对与相对路径筛选、文本提取及Scrapy爬虫实战示例。重点强调UTF-8解码必要性及常见解析错误处理,帮助开发者高效处理网页数据。
本文通过Python 2.7环境下的具体代码示例,详细解析了网络爬虫中POST请求与GET请求的区别。文章介绍了如何在PyCharm中设置编码,并分别展示了使用urllib和urllib2库构造POST表单数据提交以及通过URL参数传递GET请求的完整实现过程,帮助开发者理解两种请求方式在数据封装和传输上的差异。
本文详解Pandas中缺失值(NaN)的检测与处理方法。涵盖使用pd.isnull判断空值、dropna删除含缺失值的行、fillna填充指定值(如均值)以及replace转换特定标记为NaN的操作。同时提供解决SSL证书验证失败的实用技巧,帮助开发者高效完成数据清洗工作。