

Python实现Twitter Snowflake雪花算法详解与自定义位划分

本文详解基于Python实现Twitter Snowflake雪花算法的过程。文章解析了64位ID中符号位、时间戳、机器ID及序列号的划分标准,并结合高QPS场景演示如何自定义位分配以优化扩展性。重点介绍了通过抛出InvalidSystemClock异常来处理时钟回拨问题,确保ID生成的唯一性与系统稳定性。
本文详细解析了如何使用Python实现Twitter Snowflake雪花算法,通过具体代码示例展示了核心逻辑,为开发者在项目中应用该算法提供实用的参考。
Snowflake算法64位ID结构解析
Snowflake算法由Twitter提出,旨在生成一个64位的整数ID,其结构由多个字段拼接而成。
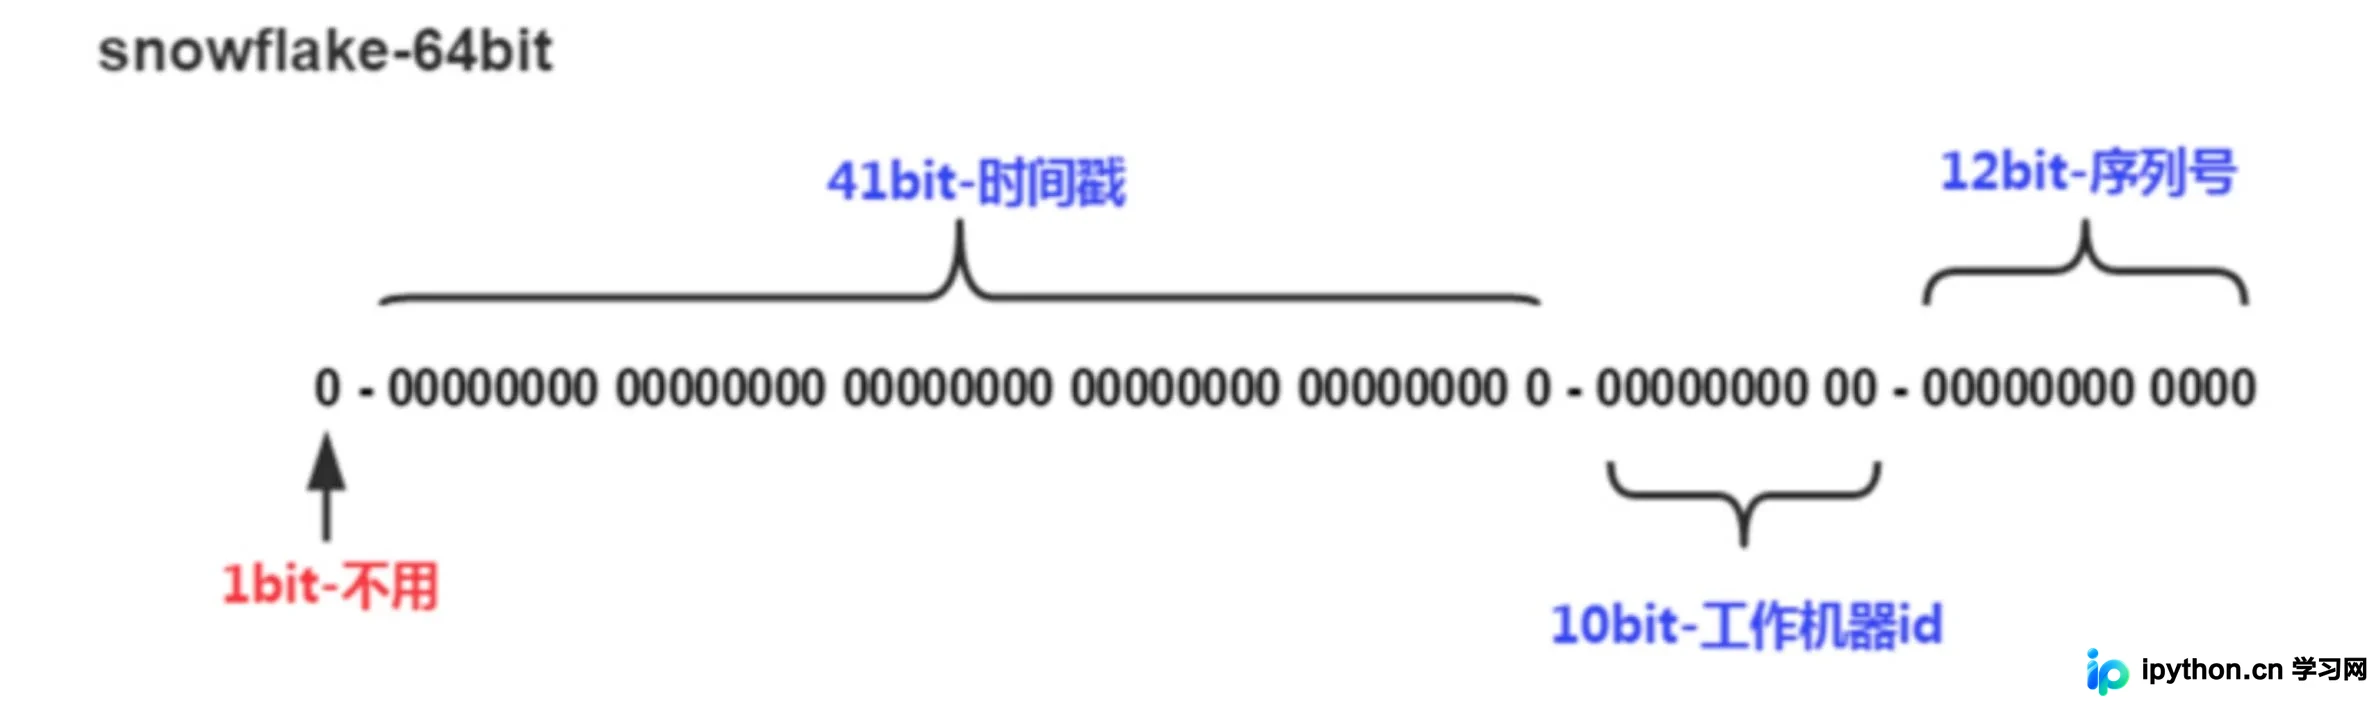
- 最高位为1个bit,通常作为符号位,在实际生成中不做处理,保持为0。
- 接下来的41个bit用于存储时间戳,可支持约69年的跨度。若设定起始时间为2018年,则该方案可使用至2089年;考虑到系统在此周期内通常会经历多次重构,这一时间窗口通常足够。
- 随后的10个bit用于标识机器ID,理论上可支持1024台机器。一般实践中,前5位代表数据中心ID,后5位代表该数据中心内的机器ID。
- 最后的12个bit为序列号位,用于在同一毫秒内生成不同的ID。12位最多支持4095个ID,即单台机器在同一毫秒内最多生成4095个ID;若超出此限制,则需等待至下一毫秒继续生成。
基于业务场景的自定义位划分策略
上述64位划分仅为一种标准模式,实际应用中可根据具体业务场景灵活调整各字段的位数分配。以下结合一个具体业务场景进行说明。
- 当前服务QPS约为10万,预计未来几年内将增长至百万级别。
- 机器部署于三个地域:上海、北京和深圳。
- 当前服务器数量约为10台,预计未来将扩展至百台规模。
- 基于上述场景,可对62位有效ID进行重新划分。鉴于QPS未来可能达到百万,每毫秒请求量约为千级。当前10台机器每台承担百级请求,为保证扩展性,可将序列号位限制为1024(即2的10次方),因此10位序列号已足够。
针对三地部署,可用3bit表示机房位置(共8种状态);当前10台机器并预留至百台扩展,可用7bit表示机器ID(共128种状态)。时间位仍保持41bit。计算剩余位数:64 - 10(序列号)- 3(机房)- 7(机器ID)- 41(时间)- 1(符号位)= 2bit,剩余2bit可用于未来扩展。

时钟回拨问题的处理机制
时钟回拨是雪花算法需要处理的关键问题之一。
由于机器系统时间调整可能导致时间回拨,而雪花算法强依赖单调递增的时间戳。若发生回拨,可能生成重复ID。在上述nextId实现中,通过比较当前时间与上一次时间戳,若当前时间小于上次时间,则判定为回拨,并直接抛出异常以阻止错误ID生成。
# Twitter's Snowflake algorithm implementation which is used to generate distributed IDs.
# https://github.com/twitter-archive/snowflake/blob/snowflake-2010/src/main/scala/com/twitter/service/snowflake/IdWorker.scala

import time
import logging

from .exceptions import InvalidSystemClock


# 64位ID的划分
WORKER_ID_BITS = 5
DATACENTER_ID_BITS = 5
SEQUENCE_BITS = 12

# 最大取值计算
MAX_WORKER_ID = -1 ^ (-1 << WORKER_ID_BITS) # 2**5-1 0b11111
MAX_DATACENTER_ID = -1 ^ (-1 << DATACENTER_ID_BITS)

# 移位偏移计算
WOKER_ID_SHIFT = SEQUENCE_BITS
DATACENTER_ID_SHIFT = SEQUENCE_BITS + WORKER_ID_BITS
TIMESTAMP_LEFT_SHIFT = SEQUENCE_BITS + WORKER_ID_BITS + DATACENTER_ID_BITS

# 序号循环掩码
SEQUENCE_MASK = -1 ^ (-1 << SEQUENCE_BITS)

# Twitter元年时间戳
TWEPOCH = 1288834974657


logger = logging.getLogger('flask.app')


class IdWorker(object):
  """
  用于生成IDs
  """

  def __init__(self, datacenter_id, worker_id, sequence=0):
    """
    初始化
    :param datacenter_id: 数据中心(机器区域)ID
    :param worker_id: 机器ID
    :param sequence: 其实序号
    """
    # sanity check
    if worker_id > MAX_WORKER_ID or worker_id < 0:
      raise ValueError('worker_id值越界')

    if datacenter_id > MAX_DATACENTER_ID or datacenter_id < 0:
      raise ValueError('datacenter_id值越界')

    self.worker_id = worker_id
    self.datacenter_id = datacenter_id
    self.sequence = sequence

    self.last_timestamp = -1 # 上次计算的时间戳

  def _gen_timestamp(self):
    """
    生成整数时间戳
    :return:int timestamp
    """
    return int(time.time() * 1000)

  def get_id(self):
    """
    获取新ID
    :return:
    """
    timestamp = self._gen_timestamp()

    # 时钟回拨
    if timestamp < self.last_timestamp:
      logging.error('clock is moving backwards. Rejecting requests until {}'.format(self.last_timestamp))
      raise InvalidSystemClock

    if timestamp == self.last_timestamp:
      self.sequence = (self.sequence + 1) & SEQUENCE_MASK
      if self.sequence == 0:
        timestamp = self._til_next_millis(self.last_timestamp)
    else:
      self.sequence = 0

    self.last_timestamp = timestamp

    new_id = ((timestamp - TWEPOCH) << TIMESTAMP_LEFT_SHIFT) | (self.datacenter_id << DATACENTER_ID_SHIFT) | \
         (self.worker_id << WOKER_ID_SHIFT) | self.sequence
    return new_id

  def _til_next_millis(self, last_timestamp):
    """
    等到下一毫秒
    """
    timestamp = self._gen_timestamp()
    while timestamp <= last_timestamp:
      timestamp = self._gen_timestamp()
    return timestamp

if __name__ == '__main__':
  worker = IdWorker(1, 2, 0)
  print(worker.get_id())
Python代码实现与配置
在同级目录下创建exceptions.py文件,用于定义相关异常类。
class InvalidSystemClock(Exception):
  """
  时钟回拨异常
  """
  pass
在配置文件中设置机器ID和序列号初始值,具体配置如下。
  # Snowflake ID Worker 参数
  DATACENTER_ID = 0
  WORKER_ID = 0
  SEQUENCE = 0
以上即为基于Python实现雪花算法的完整过程与关键细节,希望能为相关学习与实践提供帮助。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









