

Pandas数据离散化原理及实战:等宽与等深分箱详解

发布时间:2026-10-13| 5人浏览过
本文详解Pandas中数据离散化的原理与实现,通过股票涨跌幅数据案例,演示如何利用pd.cut进行等宽分箱和pd.qcut进行等深分箱。内容涵盖自定义区间设置、分组统计及代码实现,帮助开发者简化连续数据结构,提升模型泛化能力。
Pandas数据离散化概述
本文深入解析Pandas中数据离散化的核心原理,并通过具体代码示例展示其实际应用。内容详实,旨在为从事数据分析或机器学习工作的读者提供具有参考价值的学习材料,帮助读者掌握相关技术要点。
离散化的目的与优势
离散化的必要性
- 对连续属性进行离散化处理,主要目的是简化数据结构。通过离散化技术,可以有效减少连续属性值的数量,这一方法在数据挖掘领域常被用作重要的预处理工具。
- 虽然离散化过程会丢弃部分原始信息,但它能增强模型的健壮性,从而提升模型的泛化能力,使其在面对新数据时表现更稳定。
离散化基本概念
离散化的定义
数据离散化是指将连续属性的值域划分为若干个离散的区间,随后使用不同的符号或整数值来代表落在每个子区间内的属性值,从而将连续数据转换为分类数据。
分箱技术与案例解析
分箱技术
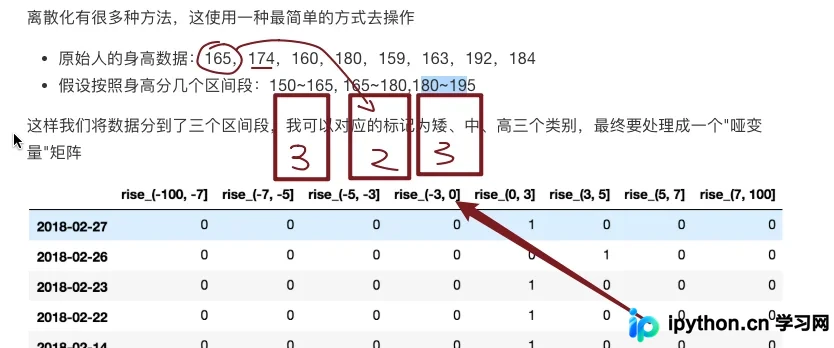
股票数据离散化实战
实战案例演示
首先,读取股票历史数据文件,并从中筛选出关键的涨跌幅(p_change)数据列,作为后续离散化的处理对象。
data = pd.read_csv("./data/stock_day.csv")
p_change= data['p_change']
接下来,对获取的股票涨跌幅数据进行分组处理,以便观察不同区间内的数据分布情况。
核心工具与自定义分组
主要使用的工具及方法如下:
- pd.qcut(data, bins)——等深分箱:
- 数据分组通常与value_counts()函数配合使用,用于统计每个分组中包含的数据样本数量。
- series.value_counts():该函数用于统计每个分组出现的频次,即计算分到每个组的数据个数。
# 自行分组
qcut = pd.qcut(p_change, 10)
# 计算分到每个组数据个数
qcut.value_counts()
自定义区间分组实现
- pd.cut(data, bins)——等宽分箱:
- 当bins参数为整数时,Pandas默认执行等宽分箱,即将数据范围均匀划分为指定数量的区间。
- 当bins参数为列表时,允许用户自定义具体的分箱边界,实现非均匀的自定义分箱操作。
# 自己指定分组区间
bins = [-100, -7, -5, -3, 0, 3, 5, 7, 100]
p_counts = pd.cut(p_change, bins)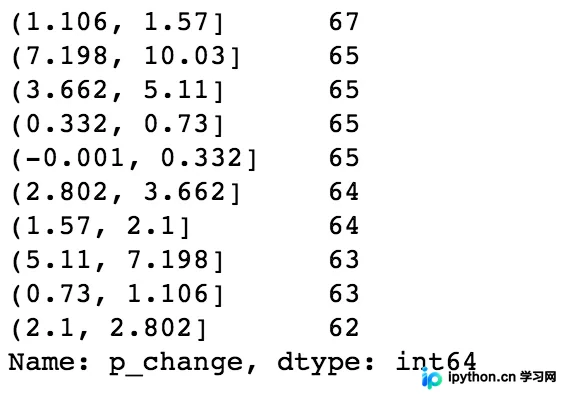
总结
以上即为Pandas数据离散化的主要内容与操作示例,希望能为读者的学习和工作提供有益帮助。欢迎持续关注本站以获取更多技术分享。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









