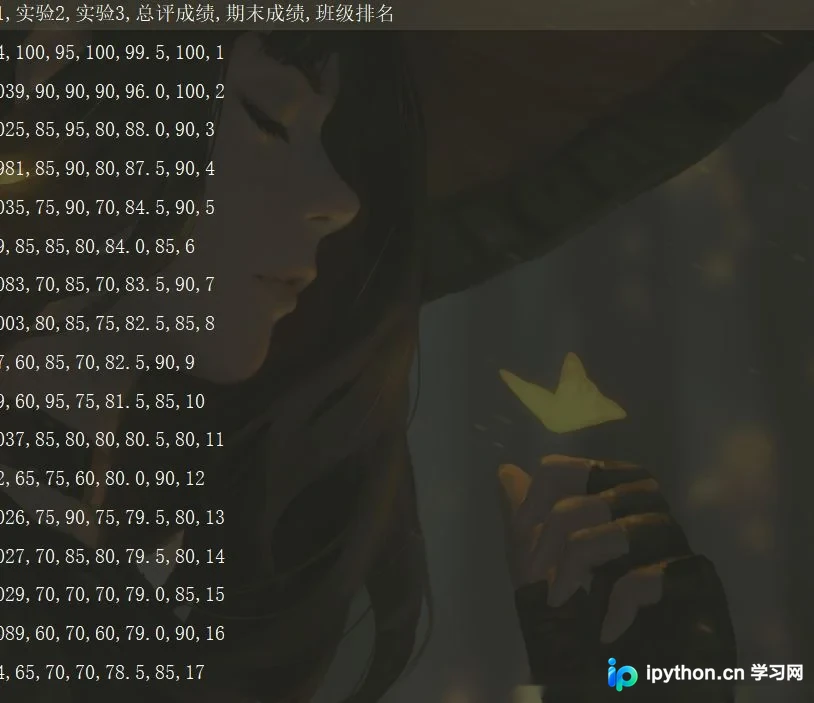
Python将字典数据写入CSV文件的完整指南
本文详细介绍如何使用Python将字典列表写入CSV文件。通过解析csv模块的open参数(如'a'追加模式、newline和encoding),结合writeheader与writerows方法,实现自动化处理大量数据。示例展示了如何动态提取表头并保存为UTF-8编码的CSV,避免Excel打开时的乱码问题,适用于数据分析归档场景。
2026-10-14
10

本文详细介绍如何使用Python将字典列表写入CSV文件。通过解析csv模块的open参数(如'a'追加模式、newline和encoding),结合writeheader与writerows方法,实现自动化处理大量数据。示例展示了如何动态提取表头并保存为UTF-8编码的CSV,避免Excel打开时的乱码问题,适用于数据分析归档场景。
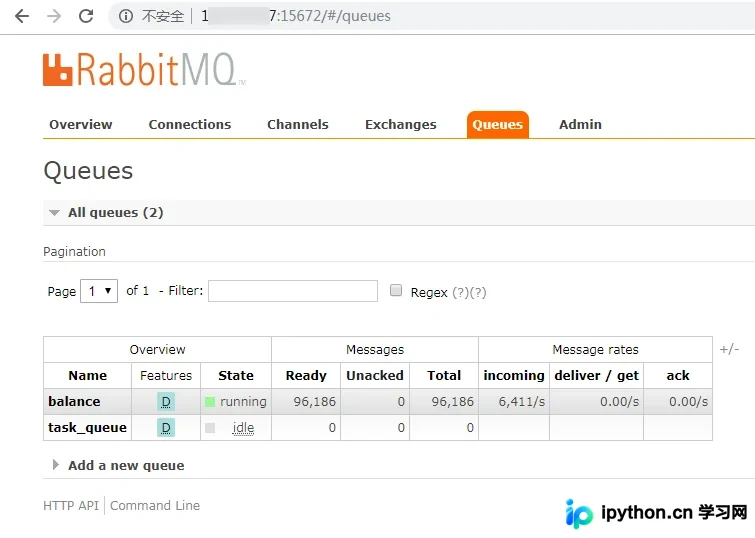
本文介绍如何使用Python的Pika库实现RabbitMQ的生产者与消费者模式。通过配置连接参数、声明持久化队列、发送消息及设置回调函数接收消息,完整演示了消息队列的基本交互流程。包含代码示例及通过管理界面或命令行验证消息数量的方法,帮助开发者快速掌握RabbitMQ在Python中的应用。
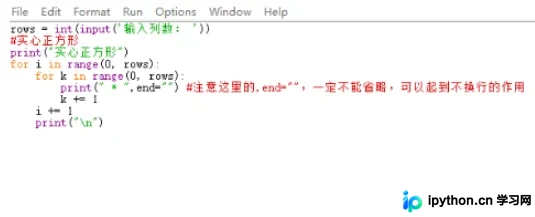
本文介绍Python 3中如何让print函数输出不换行。核心方法是使用end参数,默认值为换行符\n,将其修改为空字符串或其他字符即可实现不换行或自定义分隔。通过具体代码示例展示end参数的灵活用法,帮助开发者控制控制台输出的格式。
本文深入解析 Python 面向对象编程核心概念,涵盖类的定义、实例化、属性与方法引用。详细讲解封装、继承(含多重继承限制)、多态及方法覆盖机制,并介绍 __init__ 魔法方法的使用。最后梳理 issubclass、isinstance 和 hasattr 等常用内置函数的判定规则与注意事项,帮助开发者掌握 Python 类的高级特性。
本文详解Django视图函数中通过全局变量结合locals()函数优化数据查询的方法。针对多个视图存在重复查询语句的问题,将通用数据提取为全局变量,利用locals()自动获取局部与全局变量,简化context传递,提升代码复用性与执行效率。
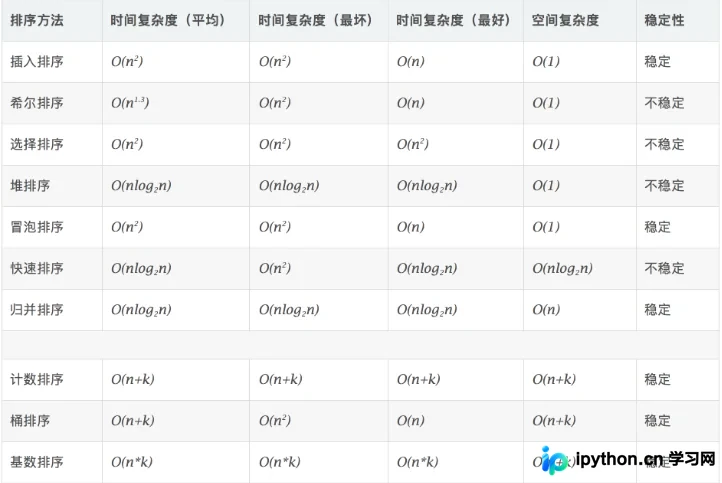
本文汇总了 Python 中常见的八大排序算法,包括冒泡、选择、插入、希尔、快速、归并及堆排序。详细解析了各算法的核心思想、时间复杂度、空间复杂度及稳定性,并提供了完整的 Python 代码实现,重点涵盖时间复杂度为 O(nlogn) 的快速、归并和堆排序。
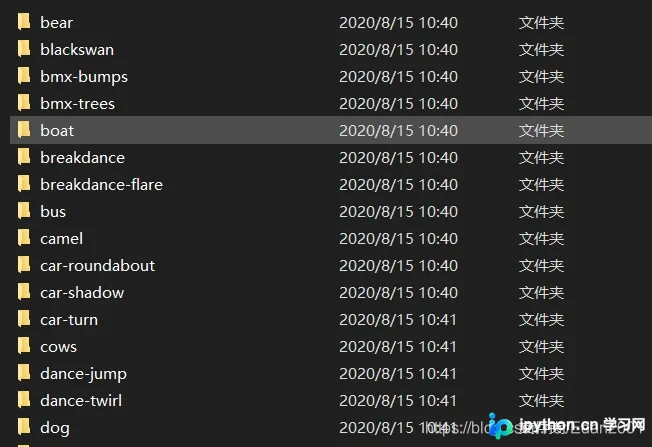
本文介绍如何利用Python批量处理嵌套文件夹中的图像数据。通过结合自定义的zisan库getFiles函数与系统os模块,实现了对深层目录结构的遍历、子文件夹创建及图像格式转换。文章提供了完整的代码示例,展示如何将Annotations下的多层级图片按原规则重命名并存储至新目录,解决批量预处理中的路径与存储难题。
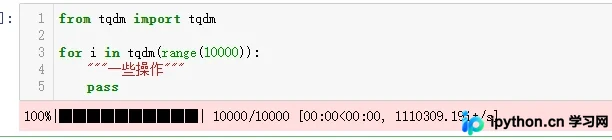
本文详细介绍Python中tqdm库的安装方法及核心参数配置。涵盖iterable、desc、total等关键参数的用法,并通过三个完整代码示例展示如何在循环、字典遍历及自定义描述中实现高效进度条显示,帮助开发者提升代码可读性与用户体验。
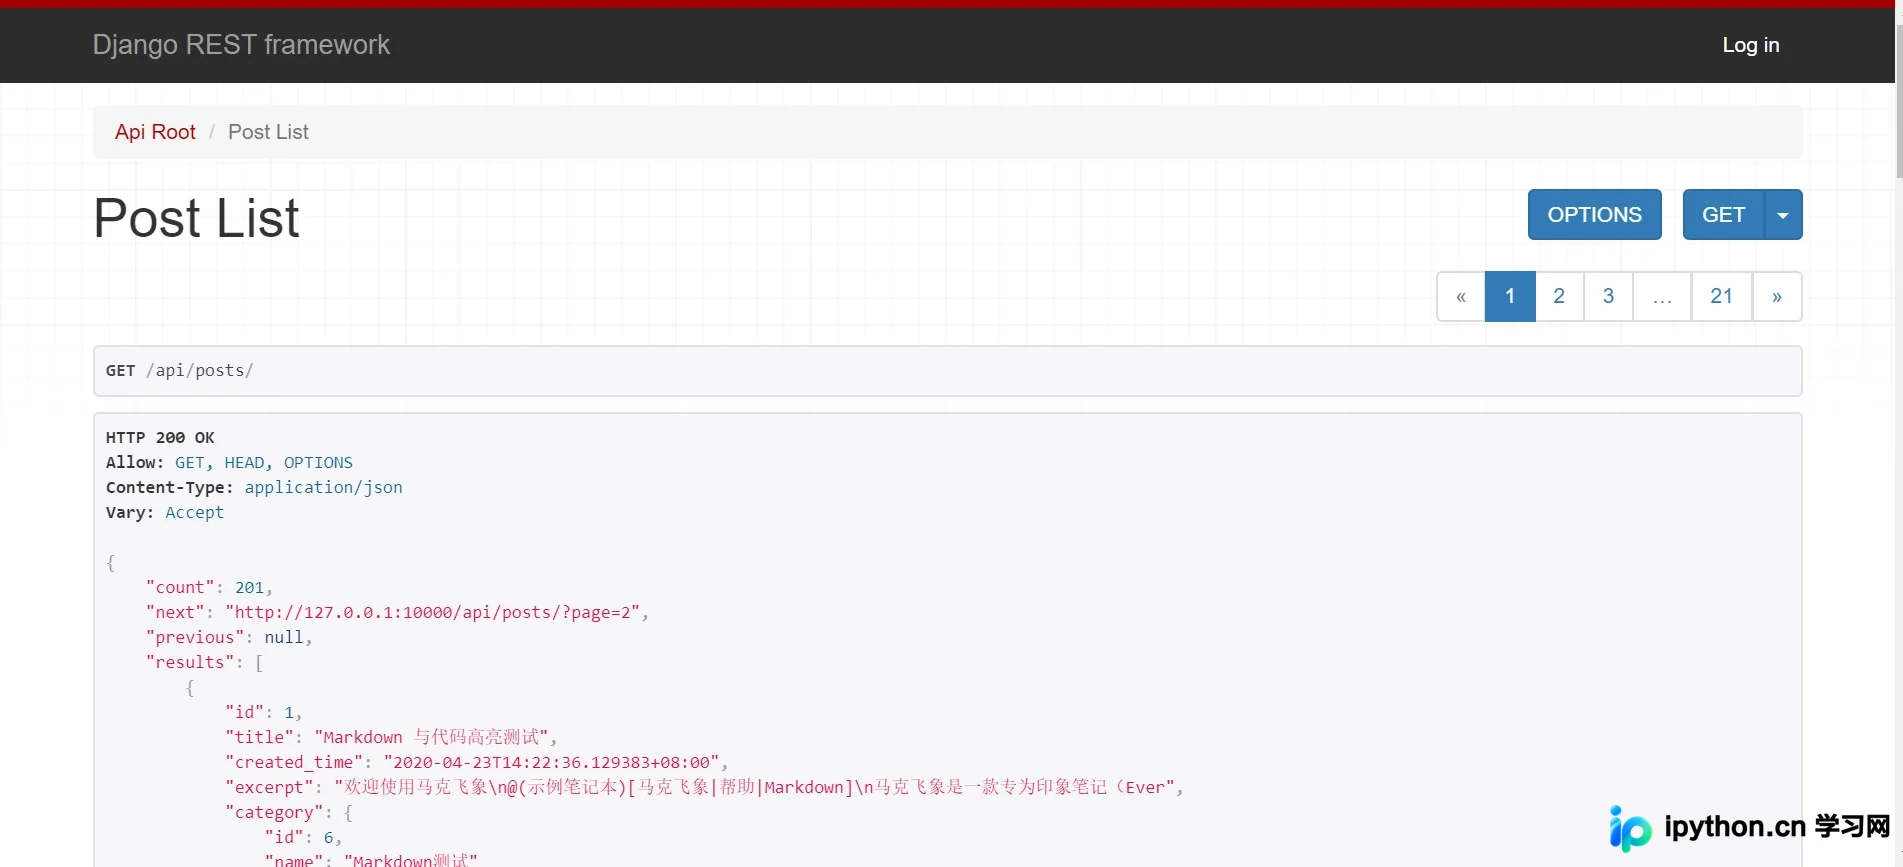
本文深入解析 Django REST Framework 的分页功能,旨在解决大数据量返回导致的性能问题。详细对比 PageNumberPagination 与 LimitOffsetPagination 两种常用策略,并演示如何通过全局配置文件统一启用分页,以及在特定视图集中通过 pagination_class 属性进行局部覆盖,实现灵活的资源列表控制。
本文深入解析Pytest测试执行的六个核心阶段:配置初始化、会话启动、用例收集、测试运行、会话结束及配置卸载。重点剖析pytest_collection、pytest_runtestloop等关键钩子的调用时机与参数,结合代码实例说明测试项生成、筛选及报告生成的内部机制,帮助开发者掌握Pytest底层逻辑以优化测试框架。
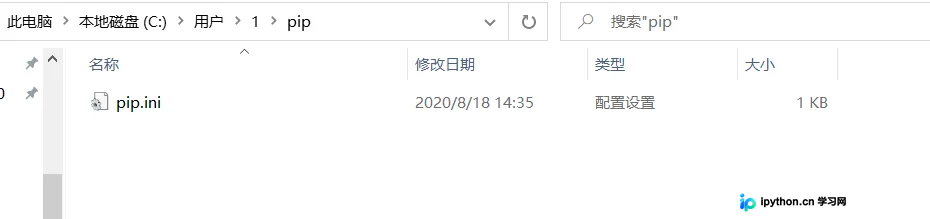
本文详细介绍如何在Windows和Linux系统中配置Python pip国内镜像源,以解决Sublime Text3中导入numpy等包时的报错问题。通过创建pip.ini或pip.conf文件,指定清华大学、阿里云或豆瓣镜像地址,可显著提升下载速度并避免超时失败。文章包含具体配置步骤、代码示例及升级pip的操作指南,帮助用户快速完成环境搭建。
本文介绍如何利用Python编写爬虫程序,结合Fiddler工具分析网络请求,实现特定素材网站的自动登录与每日签到功能。通过抓取登录接口和签到接口的参数及Cookie,程序可模拟用户操作自动获取积分,并可通过Windows任务计划实现定时运行,解决手动签到繁琐的问题。