Python爬虫实战:使用requests模块抓取百度翻译与搜狗首页
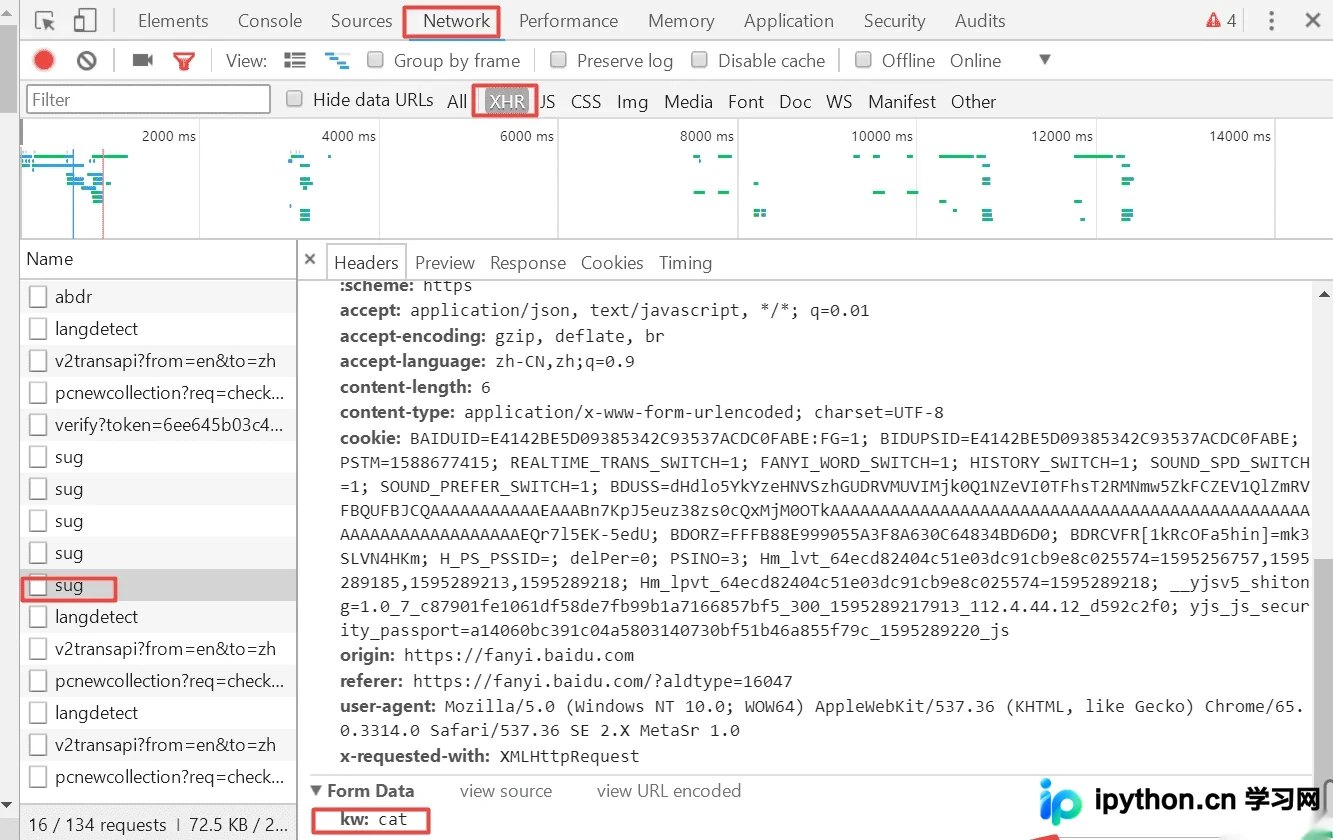
本文详细介绍Python中requests模块的安装与基础用法,涵盖指定URL、参数处理、发起请求及数据持久化存储的完整流程。通过百度翻译POST请求案例演示UA伪装技巧,并结合搜狗首页GET请求案例,讲解如何获取网页源码并保存为本地文件,帮助开发者快速掌握网络爬虫核心技能。
2026-10-14
8

本文详细介绍Python中requests模块的安装与基础用法,涵盖指定URL、参数处理、发起请求及数据持久化存储的完整流程。通过百度翻译POST请求案例演示UA伪装技巧,并结合搜狗首页GET请求案例,讲解如何获取网页源码并保存为本地文件,帮助开发者快速掌握网络爬虫核心技能。
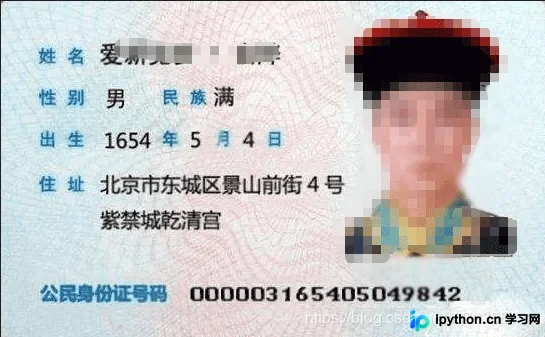
本文介绍使用Python和OpenCV库进行中华人民共和国公民身份证号码提取与识别的实现过程。通过图像预处理、区域分割及模板匹配技术,将提取的身份证号码与标准OCR-B 10 BT字体模板进行相似度比对,最终输出识别结果。
本文以51CTO博客为例,详细介绍如何使用Python进行网页数据爬取。通过安装Python 3.7及requests、bs4模块,结合清华镜像加速下载,编写代码抓取博客标题与阅读量,并将结果保存至本地文本文件,为初学者提供完整的实战案例。
本文详细介绍如何使用Python和pygame库开发经典贪吃蛇游戏,并进一步实现AI自动游玩功能。教程涵盖环境配置、模块安装、普通版代码结构及AI版核心算法逻辑,提供完整可运行代码,适合Python初学者与游戏开发者参考。
本文详解如何在 Python 中使用 Selenium 配置无头模式(Headless)以隐藏运行过程,并介绍通过 ChromeOptions 添加实验性参数来规避自动化检测的方法。包含完整代码示例及运行效果说明,帮助开发者实现高效且隐蔽的网页数据抓取。
本文介绍如何使用Python自动清理指定文件夹下的重复文件。通过结合[[wp:a0]]、[[wp:a1]]和[[wp:a2]]模块,遍历获取文件路径并两两比较内容。文章详细讲解了利用[[wp:a3]]模块判断文件是否相同的方法,包括[[wp:a4]]与[[wp:a5]]返回值及[[wp:a6]]参数对[[wp:a7]]签名比较的影响。代码实现了路径获取、列表过滤及去重删除逻辑,并处理了文件被提前删除时的[[wp:a21]]存在性检查,确保脚本稳定运行。
本文详细介绍如何利用Python获取百度首页热榜关键词,并通过构造特定URL参数生成对应的搜索链接。同时,文章扩展讲解了使用requests和lxml库抓取百度搜索结果标题、摘要及链接的完整代码实现,涵盖请求头设置、参数解析及数据提取技巧,帮助开发者掌握基础的网络数据采集方法。
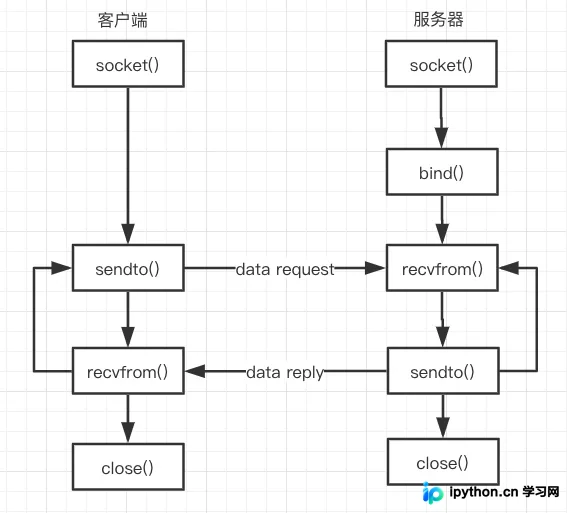
本文深入解析 Python 中的 UDP 编程,对比 TCP 与 UDP 的差异,阐述 UDP 无连接、不可靠但高速的特点。详细讲解 UDP 服务器与客户端的创建步骤,包括 Socket 初始化、绑定端口、发送与接收数据报及关闭连接。通过完整的 Python 代码示例,演示如何构建简易聊天程序,帮助开发者掌握 UDP 通信的核心流程与实战应用。
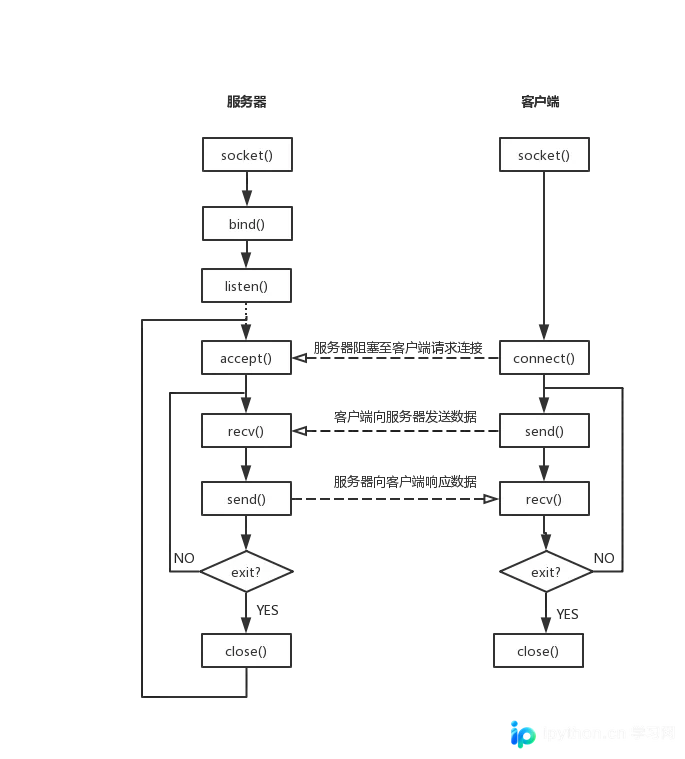
本文详解Python中TCP网络编程的核心原理与实现方法。通过快递寄送的通俗比喻解释Socket、IP与端口概念,梳理TCP连接建立与关闭的标准流程。提供完整的Python代码示例,展示如何创建Socket、绑定端口、监听连接以及使用多线程处理并发请求,帮助开发者快速掌握基于Python的TCP通信开发技巧。
本文介绍pandas中常用的参数设置方法,包括通过pd.set_option()控制最大显示行数、列数及列宽,利用chop_threshold隐藏小数值,以及浮点数格式化和精度调整。同时讲解如何使用option_context进行临时参数修改,帮助开发者灵活优化数据展示效果。
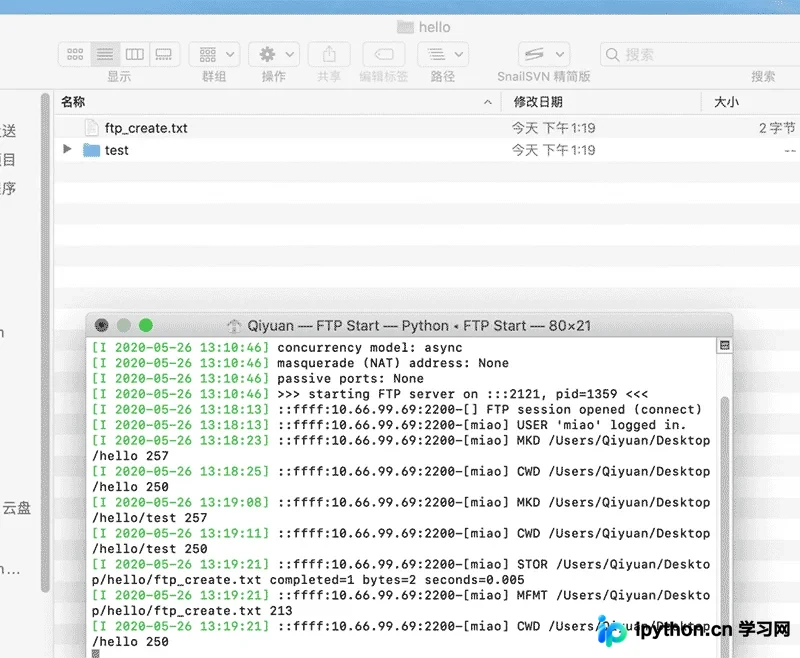
本文介绍如何使用Python内置库pyftpdlib快速搭建局域网FTP服务器,实现Windows与macOS/Linux间的文件互传。通过一行命令或批处理脚本,无需安装复杂软件即可解决大文件传输问题,支持自定义目录、用户名及密码,操作简单高效。
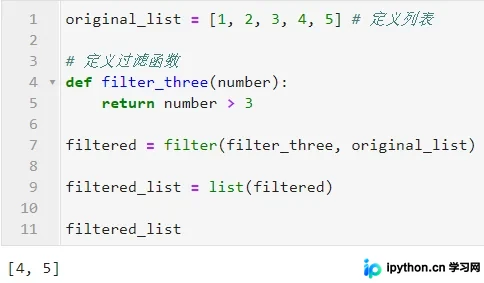
本文深入解析Python中列表的8个核心技巧。涵盖使用filter和列表推导式进行元素过滤,利用map和推导式修改元素,通过zip组合列表,使用切片[::-1]反转列表。此外,还演示了检查元素存在性、统计最高频元素、处理任意层级嵌套列表展平以及验证列表唯一性的实用方法,帮助开发者写出更简洁高效的Python代码。