Python网页数据抓取实战:以Nameberry名字评论为例
本文以Nameberry网站为例,详细演示使用Python抓取网页评论数据的完整流程。内容涵盖从分析网页结构、自动生成A-Z链接、处理分页逻辑,到解析HTML提取姓名、用户名、时间及评论内容的全过程。文中提供了基于requests和BeautifulSoup的核心代码片段,并强调了遵守爬虫协议及异常处理的重要性,帮助开发者掌握基础爬虫技巧。
2026-10-14
7

本文以Nameberry网站为例,详细演示使用Python抓取网页评论数据的完整流程。内容涵盖从分析网页结构、自动生成A-Z链接、处理分页逻辑,到解析HTML提取姓名、用户名、时间及评论内容的全过程。文中提供了基于requests和BeautifulSoup的核心代码片段,并强调了遵守爬虫协议及异常处理的重要性,帮助开发者掌握基础爬虫技巧。
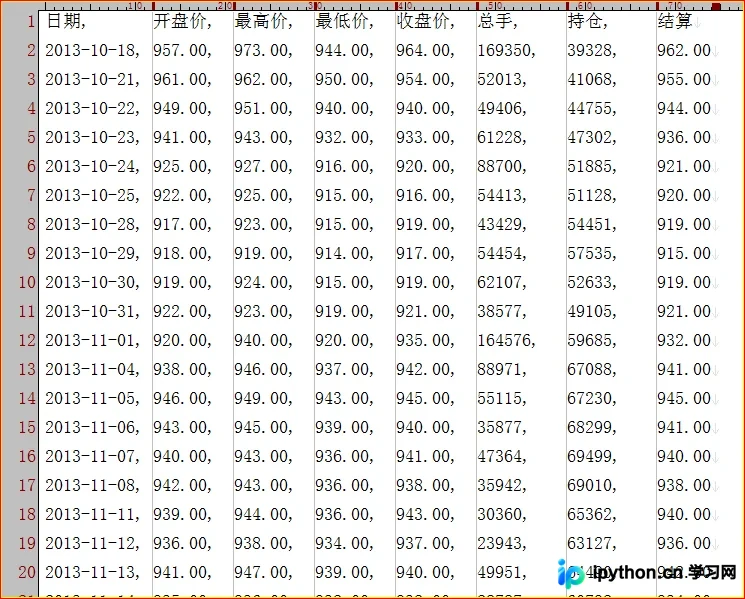
本文介绍如何使用Python的pandas库读取CSV文件并合并两个股票数据集。通过示例代码展示如何将螺纹钢与铁矿石数据按日期关联,实现类似SQL left-join的效果,为后续使用matplotlib绘制历史相关性图表奠定基础。
本文详解Python中金额数字的人性化显示方法,解决浮点数精度及整数无小数位问题。介绍两种实现方案:基础代码处理与xToolkit库调用,并附带将数字转换为中文大写金额的完整脚本,帮助开发者实现符合阅读习惯的金额展示。
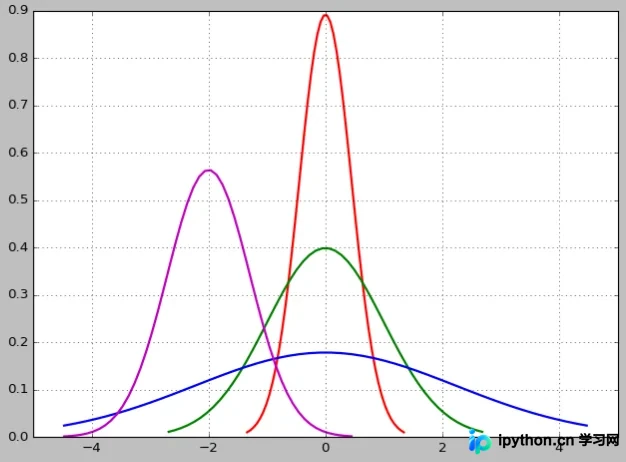
本文介绍如何利用Python的Matplotlib和NumPy库绘制正态分布的概率密度函数。通过设定不同的均值和标准差参数,代码展示了多条正态曲线的对比效果,帮助理解正态分布中参数对曲线形态的影响。
本文介绍在Python中通过telnetlib模块调用Java Dubbo接口的具体实现。通过封装Telnet类,利用invoke命令发送请求并解析返回结果,仅需少量代码即可完成跨语言服务调用,适用于后端重构后的接口测试与集成场景。
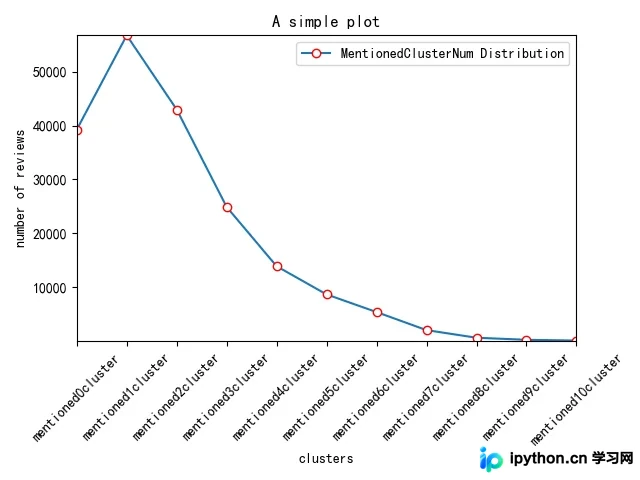
本文介绍如何使用Python的Matplotlib库绘制分布折线图。通过plot()函数设置数据点、标记样式及标签,展示如何生成包含特定数据分布的折线图,并解决中文显示与坐标轴调整问题,提供完整可运行代码示例。
本文详细解析Python中实现单例模式的五种常见方式,包括classmethod装饰器、类装饰器、元类、模块导入以及重写__new__()方法。通过代码示例对比各方法的运行结果,重点指出前四种方法在特定条件下可能创建新对象,并非绝对单例,而重写__new__()方法能确保全局仅创建一次实例,适用于需要严格单例控制的场景。
本文提供 Python 中使用 PyCryptodome 库进行 RSA-OAEP 加密与解密的完整代码示例。内容涵盖如何生成 1024 位 RSA 密钥对、导出公钥与私钥,以及如何利用 PKCS1_OAEP 方案对字符串进行加密并还原。代码包含详细的注释,适用于需要实现非对称加密功能的 Python 开发者参考。
本文介绍了一个基于Python xlwt库封装的Excel处理工具类JarExcelUtil。该类支持自定义表头与列宽,并提供设置行高、列宽、冻结窗格、单元格对齐方式及背景色的常用功能。通过示例代码展示了如何快速生成格式化的Excel文件,适用于需要批量生成标准化报表的场景。
本文深入解析 Python 字符编码机制,对比 Python2 与 Python3 在默认编码及内存处理上的差异,重点阐述 .py 文件头编码声明的作用。同时详细介绍文件处理的两种模式:字符方式(t)与二进制方式(b),强调 encoding 参数的使用场景及资源释放规范,帮助开发者避免乱码并高效管理文件资源。
本文探讨Python多线程环境下全局变量的共享机制。通过代码示例验证子线程间可共享全局变量及列表参数,并分析其优势在于多任务数据交互便捷,但需警惕因随意修改导致的线程非安全问题。
本文介绍Python中处理文件编码与类型识别的两个核心模块。针对ConfigParser读取非UTF-8配置文件时的UnicodeDecodeError,演示如何使用chardet模块自动检测文件编码并正确读取。同时讲解mimetypes模块通过文件名或URL获取MIME类型及对应文件扩展名的方法,涵盖guess_type与guess_all_extensions函数的具体用法与参数说明。