Python xlwt封装类实现Excel创建与格式设置
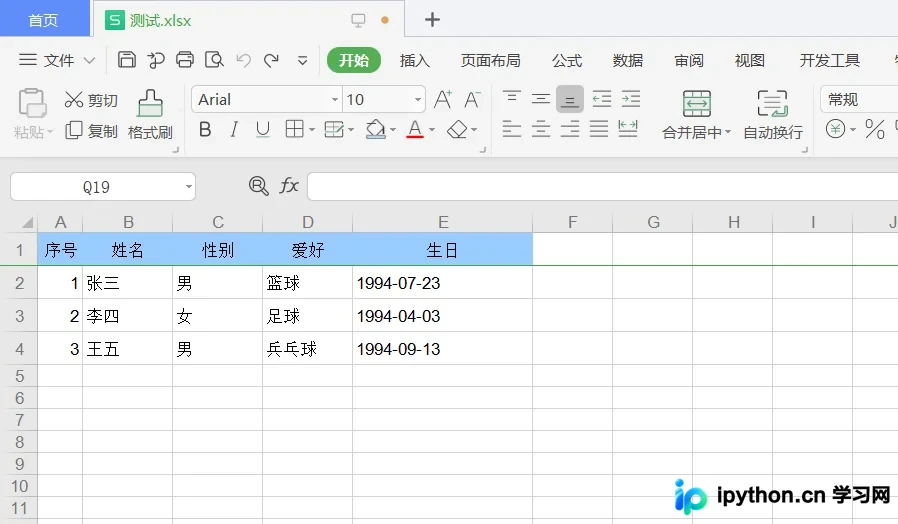
本文介绍了一个基于Python xlwt库封装的Excel处理工具类JarExcelUtil。该类支持自定义表头与列宽,并提供设置行高、列宽、冻结窗格、单元格对齐方式及背景色的常用功能。通过示例代码展示了如何快速生成格式化的Excel文件,适用于需要批量生成标准化报表的场景。
2026-10-14
8

本文介绍了一个基于Python xlwt库封装的Excel处理工具类JarExcelUtil。该类支持自定义表头与列宽,并提供设置行高、列宽、冻结窗格、单元格对齐方式及背景色的常用功能。通过示例代码展示了如何快速生成格式化的Excel文件,适用于需要批量生成标准化报表的场景。
本文深入解析 Python 字符编码机制,对比 Python2 与 Python3 在默认编码及内存处理上的差异,重点阐述 .py 文件头编码声明的作用。同时详细介绍文件处理的两种模式:字符方式(t)与二进制方式(b),强调 encoding 参数的使用场景及资源释放规范,帮助开发者避免乱码并高效管理文件资源。
本文探讨Python多线程环境下全局变量的共享机制。通过代码示例验证子线程间可共享全局变量及列表参数,并分析其优势在于多任务数据交互便捷,但需警惕因随意修改导致的线程非安全问题。
本文介绍Python中处理文件编码与类型识别的两个核心模块。针对ConfigParser读取非UTF-8配置文件时的UnicodeDecodeError,演示如何使用chardet模块自动检测文件编码并正确读取。同时讲解mimetypes模块通过文件名或URL获取MIME类型及对应文件扩展名的方法,涵盖guess_type与guess_all_extensions函数的具体用法与参数说明。
本文介绍Python中判断元素是否存在于序列的两种主要方法。首先讲解in和not in运算符的用法,通过示例展示其返回布尔值的特性;其次演示如何通过for循环遍历列表来查找特定元素,对比两种方式的代码实现与输出结果,帮助开发者根据场景选择合适方案。
本文详细介绍Python中zip()函数的核心用法。通过实例演示如何将多个可迭代对象打包为元组,处理长度不一致的情况,并利用*操作符解压。此外,还涵盖利用zip()将列表转换为字典、同时遍历多个字典键值对的高级技巧,帮助开发者高效处理数据聚合与迭代任务。
本文介绍如何在Python中利用行人检测得到的中心坐标绘制场景热力图。通过获取Bounding Box中心点并传入HeatMap库,可生成热力层。代码演示了如何将热力图以指定透明度加权叠加至原图,并通过调整半径参数控制可视化效果,适用于人群密集度等场景分析。
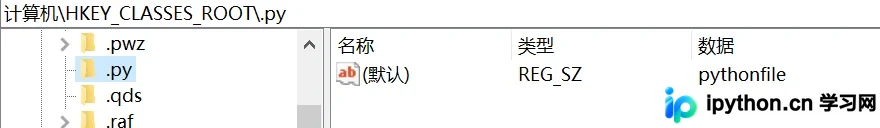
本文介绍在Anaconda环境中如何恢复IDLE对Python文件的默认关联。通过修改注册表将.py文件打开方式指向Anaconda目录下的pythonw.exe及idle.pyw,并配置文件图标。此外,还演示了如何创建桌面快捷方式以便快速启动IDLE,解决安装Anaconda后无法直接使用IDLE的问题。
本文详细介绍Python中删除文件和清空目录的多种实现方式。涵盖os.remove、os.unlink删除单个文件,os.rmdir删除空目录,以及os.removedirs递归删除目录的方法。针对非空文件夹清空,推荐使用shutil.rmtree结合重新创建目录的策略,并附带Windows与Unix系统的差异说明及代码示例。
本文介绍利用Python和Pandas库批量合并多个Excel文件(包括xls和CSV格式)的方法。通过遍历目录获取文件列表,逐行读取为DataFrame并加入列表,最后使用pd.concat进行拼接,最终导出为单个CSV文件,解决手工复制效率低下的问题。
本文介绍在Python Web开发中调用第三方接口时,如何获取10位秒级和13位毫秒级Unix时间戳。通过time模块,演示了强制转换获取10位时间戳,以及利用round函数将秒转换为毫秒得到13位时间戳的方法,并包含将13位时间戳还原为可读时间的示例。
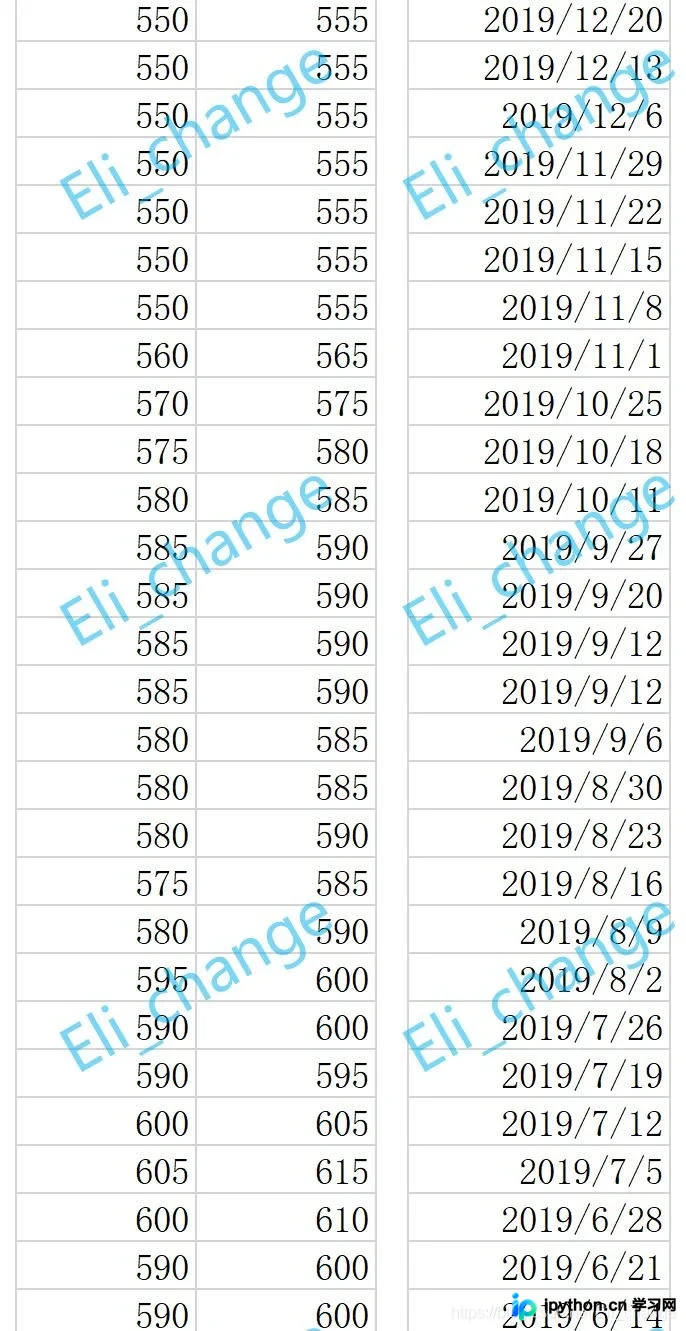
本文介绍如何使用Python读取包含日期和价格的CSV文件,通过字符串处理将多列数据分离为最高价、最低价和均价列表。利用matplotlib库绘制折线图,并使用reversed()函数调整时间轴顺序,最终生成清晰的周价格波动图表。