

Scrapy结合Selenium实现动态网页数据抓取详解
本文详解如何利用Scrapy框架结合Selenium解决动态网站数据抓取问题。通过自定义下载中间件,在Request阶段使用Selenium渲染JS并获取源码,直接返回Response对象,从而跳过默认Downloader。文章提供了middlewares.py和taobao.py的完整代码示例,并针对单爬虫与多爬虫场景下的Driver初始化策略进行了对比分析,帮助开发者高效实现动态内容抓取。
2026-10-14
7

本文详解如何利用Scrapy框架结合Selenium解决动态网站数据抓取问题。通过自定义下载中间件,在Request阶段使用Selenium渲染JS并获取源码,直接返回Response对象,从而跳过默认Downloader。文章提供了middlewares.py和taobao.py的完整代码示例,并针对单爬虫与多爬虫场景下的Driver初始化策略进行了对比分析,帮助开发者高效实现动态内容抓取。
本文详细介绍如何使用 Python 编写爬虫程序,从指定网站批量抓取免费简历模板。通过 requests 获取页面源码,利用 lxml 解析 HTML 结构提取下载链接,并结合 os 模块实现文件的自动创建与本地保存。代码包含分页处理、请求头伪装及异常处理逻辑,适用于学习网络爬虫基础及文件自动化操作。
本文详细解析Python中提升爬虫效率的两种主流方案:基于aiohttp的单线程多任务异步协程,以及结合requests模块的线程池技术。通过Flask模拟服务端与具体代码示例,对比两者在并发请求下的耗时表现,并介绍异步回调与数据解析的最佳实践,帮助开发者根据场景选择最优加速策略。
本文深入解析Python的垃圾回收机制,涵盖以引用计数为主、分代收集为辅的核心策略。详细阐述引用计数的原理及其循环引用缺陷,介绍标记-清除算法如何解决循环引用问题,并解释分代回收如何通过对象存活时间优化垃圾收集频率,帮助开发者理解内存管理原理。
本文提供Python单向链表的完整代码示例,涵盖节点类Node与链表类SLinkList的定义。详细解析了头插、尾插、中间插入及节点删除等核心操作方法,并包含遍历输出功能。通过具体实例演示链表的构建与基本操作,帮助开发者掌握Python中链表数据结构的实现细节。
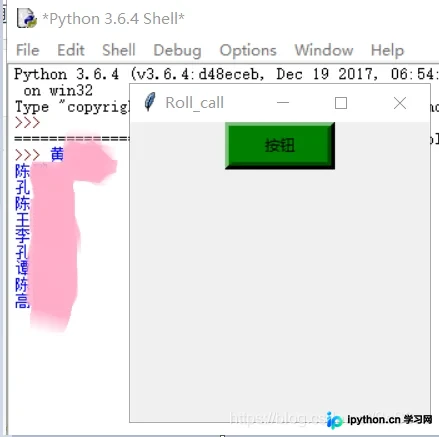
本文介绍如何使用Python的random模块读取文本文件中的学生名单,并结合Tkinter库构建一个简易的图形用户界面。通过点击按钮触发随机抽取逻辑,实现课堂随机点名功能,适合Python初学者学习基础GUI编程与文件处理。
本文提供了基于何凯明博士理论的Python暗通道去雾算法完整实现,代码仅60余行且含详细注释。重点解析了计算密集的最小值滤波环节,指出纯Python实现的性能瓶颈,并建议通过C语言扩展或调用OpenCV的erode函数进行优化。文章附带运行效果对比,展示了从原图到去雾后图像的显著改善,适合希望快速掌握该算法原理及工程落地的开发者参考。
本文详细介绍如何在Python中利用yaml库读取和处理配置文件。通过一个具体的HandleYaml类封装示例,演示如何加载YAML文件并提取指定键值对数据,帮助开发者高效管理项目配置参数。
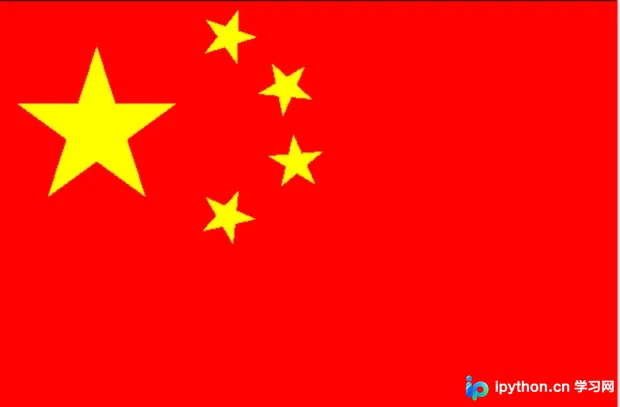
本文介绍如何使用Python内置的turtle库绘制包括中国、瑞士、美国及民国时期的多国国旗。通过具体的代码示例,详细解析了五星红旗、青天白日旗、瑞士红底白十字旗及美国星条旗的绘制逻辑与实现步骤,帮助开发者掌握图形编程技巧。
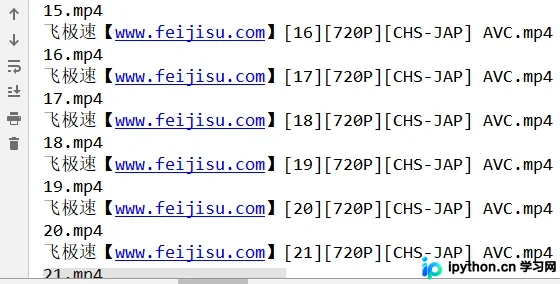
本文介绍如何利用Python批量修改动漫视频文件名。通过导入os和re模块,结合正则表达式提取文件名中的集数信息,实现自动重命名。主要涉及os.listdir获取文件列表、os.chdir切换目录、os.path.abspath获取绝对路径以及os.rename执行重命名操作,适用于需要整理大量文件命名的场景。
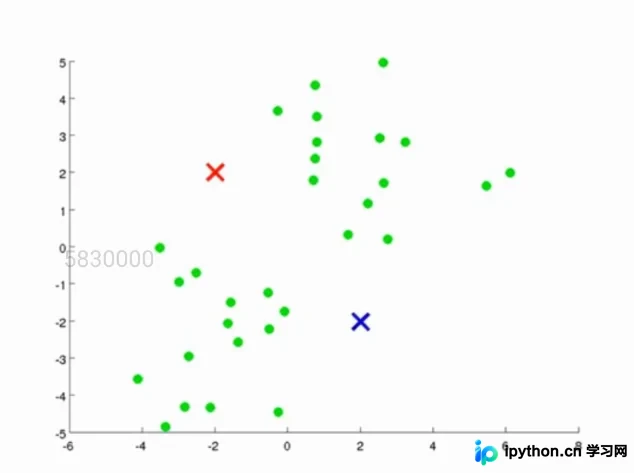
本文详细解析K-Means均值聚类算法的核心原理,包括质心初始化、距离计算、类别分配及质心更新迭代过程。通过Python代码结合make_blobs数据集,演示如何利用scikit-learn进行聚类建模与可视化,帮助读者理解无监督学习中的特征分组逻辑。
本文详细介绍Python中split()函数的使用方法,包括指定分隔符和分割次数的参数设置。通过代码示例展示如何按特定字符切割字符串,并探讨将字符串视为列表进行逐个字符遍历的技巧,帮助开发者掌握字符串处理的核心操作。