Python快速安装OpenCV:使用清华镜像源解决下载慢问题
本文介绍如何在Python中快速安装OpenCV库。针对传统安装方式耗时过长的问题,推荐使用清华PyPI镜像源进行加速。通过管理员权限运行CMD,执行指定pip命令即可快速完成安装,并通过import cv2验证安装结果。
2026-10-14
7

本文介绍如何在Python中快速安装OpenCV库。针对传统安装方式耗时过长的问题,推荐使用清华PyPI镜像源进行加速。通过管理员权限运行CMD,执行指定pip命令即可快速完成安装,并通过import cv2验证安装结果。
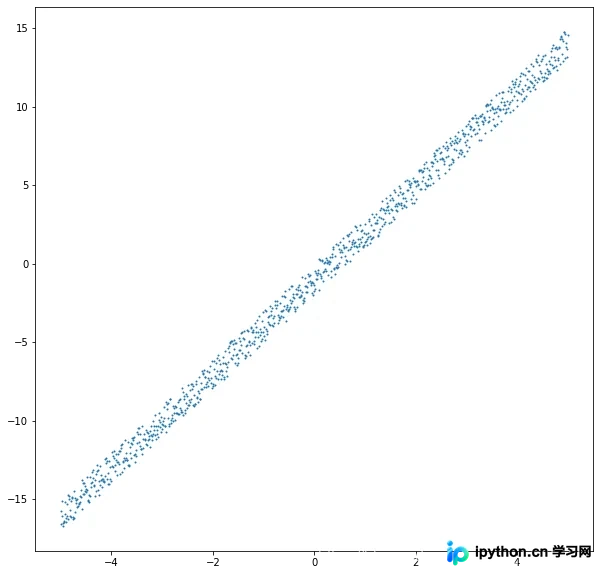
本文详细讲解如何利用Python实现最小二乘法和梯度下降算法。通过生成模拟数据,分别使用sympy求解偏导方程组和迭代优化方法计算参数a和b。对比两种方法的计算过程与结果,展示其在线性回归中的应用及代码实现细节。
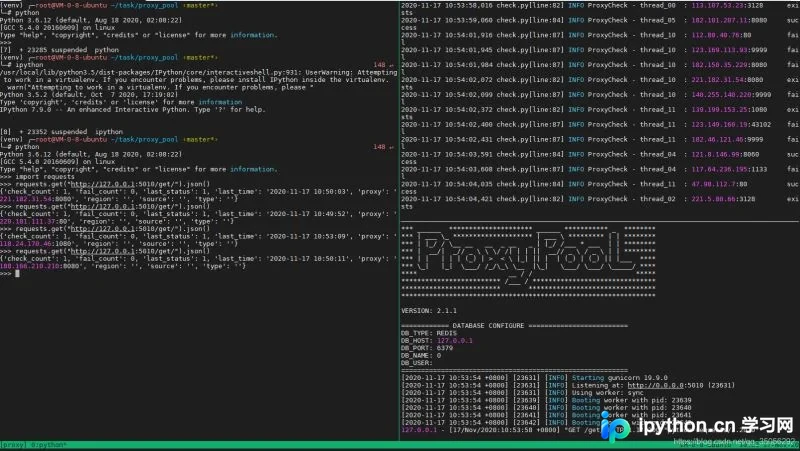
本文介绍在Python爬虫开发中,针对高并发请求导致IP被封禁的问题,使用开源项目proxy_pool搭建代理池的完整流程。涵盖从Python虚拟环境搭建、Redis依赖安装,到配置文件修改、服务启动及代码测试的具体步骤,帮助开发者实现IP自动轮换与异常处理。
本文详解Scrapy实现模拟登录的两种核心方式:一是直接携带Cookie发起请求,适用于Cookie有效期较长的场景;二是通过发送Post请求获取Cookie,分别介绍scrapy.FormRequest手动构造表单与scrapy.FormRequest.from_response()自动填充表单的方法。结合GitHub登录示例代码,解析如何验证登录状态及处理动态表单字段,帮助开发者高效解决需要登录才能访问的页面爬取问题。
本文详解Python使用requests库爬取网页时返回空内容的常见原因及解决方法。通过修改User-Agent和Cookie模拟浏览器请求,成功绕过360搜索的反爬限制,并结合BeautifulSoup库提取表格数据,完整展示从请求到数据提取的全过程。
本文详细解析pandas中DataFrame的条件筛选方法。重点介绍使用布尔型DataFrame进行单条件与多条件筛选的正确写法,指出使用and/or运算符导致的ValueError错误及解决方案。深入对比loc、iloc及已弃用的ix方法的索引机制,说明标签索引与位置索引的区别,并演示如何结合逻辑表达式进行行列筛选。

本文详细介绍在Scrapy框架中实现模拟登录的三种核心方式:直接携带Cookies、使用FormRequest发送POST请求以及利用from_response自动解析表单。通过GitHub登录示例,解析代码逻辑与配置要点,帮助开发者掌握不同场景下的最佳实践。
本文详解Python爬虫中利用Requests库处理Cookie的两种核心方法。通过对比urllib,展示如何使用get方法直接传递Cookie,以及利用Session对象在多次请求间自动保持Cookie状态。包含具体代码示例及运行结果分析,帮助开发者更高效地实现登录态维持与数据抓取。
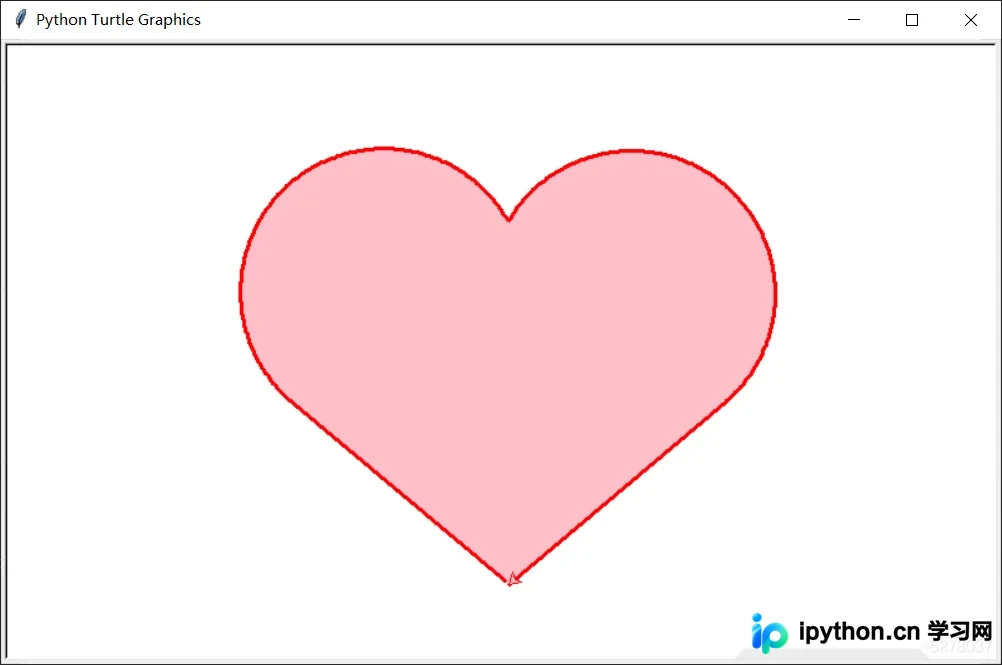
本文详细介绍如何使用Python的Turtle库绘制静态爱心及动态发射爱心的小人。通过解析两段完整源码,涵盖窗口设置、路径规划、圆弧绘制及文字输出等关键步骤,帮助开发者快速掌握基础图形绘制技巧与动画实现逻辑。
本文详细介绍如何使用Python和Pygame库开发一款猴子摘桃小游戏。内容涵盖项目文件目录结构、图片资源(monkey.png、background.jpg、apple.png)的配置方法,以及在PyCharm中修改代码路径的具体步骤。附带完整源代码及运行截图,适合Python初学者进行实战练习。
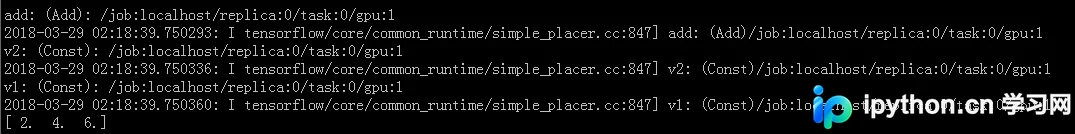
本文详细介绍如何在TensorFlow中使用tf.device()指定模型运行的具体设备,包括GPU和CPU的选择。通过示例代码展示如何指定特定GPU运行Session,以及如何配置ConfigProto打印设备放置信息。同时解释了默认情况下Session在GPU:0上运行的机制,以及如何将计算指定到CPU。
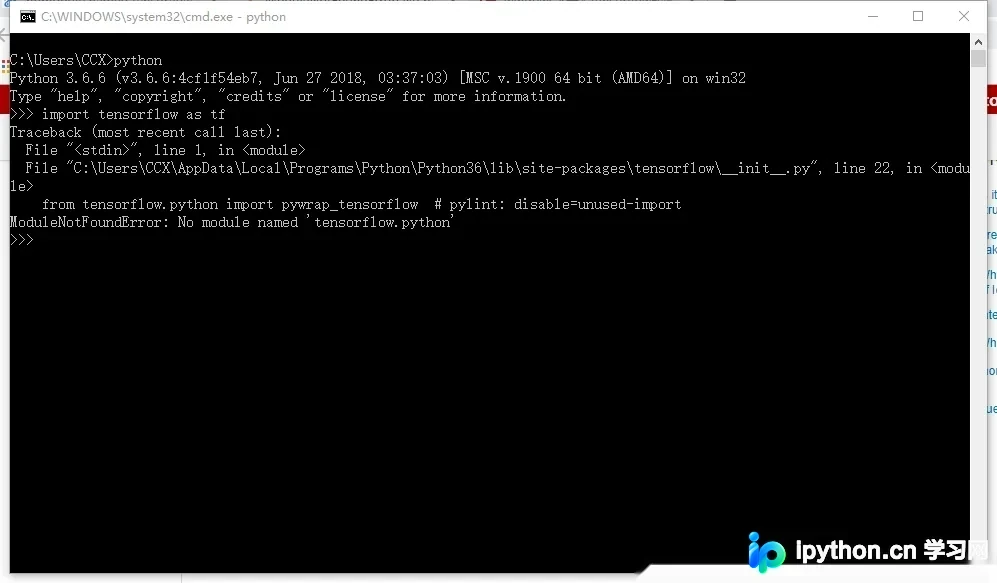
本文针对使用pip安装TensorFlow后运行Python报错“no module named tensorflow.python”的问题提供解决方案。该错误通常因pip未将库安装至Python 3目录所致,建议改用pip3命令重新安装以匹配Python版本,确保模块路径正确。