

pandas DataFrame groupby分组聚合与reset_index重置索引详解
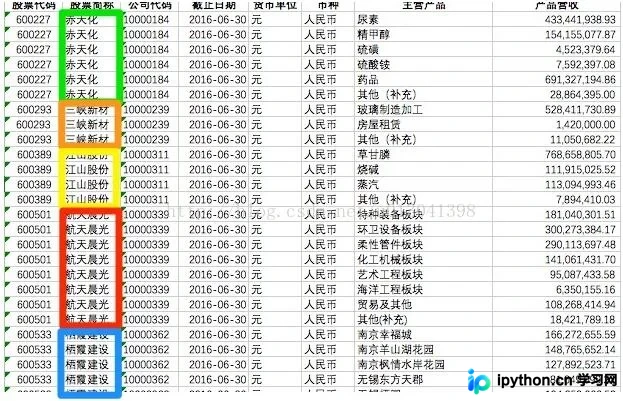
本文详解pandas中DataFrame的groupby分组聚合操作,涵盖Splitting、Applying、Combining三步流程。通过代码示例展示按单列或多列分组求和、求最值的方法,并重点解析reset_index()对输出结果索引结构的影响及列名提取差异,帮助开发者掌握数据预处理中的分组运算技巧。
2026-10-13
30

本文详解pandas中DataFrame的groupby分组聚合操作,涵盖Splitting、Applying、Combining三步流程。通过代码示例展示按单列或多列分组求和、求最值的方法,并重点解析reset_index()对输出结果索引结构的影响及列名提取差异,帮助开发者掌握数据预处理中的分组运算技巧。
本文深入对比Java与Python在速度、历史遗留、敏捷性、市场普及度及架构五大维度的表现。Java凭借JIT编译和多核支持在性能上占优,且在企业级应用和测试生态中更为成熟;Python则在脚本简洁性和DevOps集成上具备敏捷优势。尽管两者各有千秋,但Java在企业招聘和大型系统稳定性方面仍具传统优势,适合不同场景的开发者参考。
本文详细解析Python原生list与NumPy数组之间的相互转换方法。通过示例展示如何将list转换为np.array,以及利用tolist()方法将数组还原为list,帮助开发者高效处理数据结构转换需求。
本文介绍在Python中使用Pandas处理数据时,将DataFrame对象转换为NumPy数组的具体方法。通过调用DataFrame的values属性,可以高效获取底层数组数据,适用于需要高性能数值计算的场景。
本文提供了一段Python脚本,用于每日将MySQL数据库中的历史数据迁移至归档库。脚本通过命令行参数配置源与目标数据库连接、表名及迁移策略,支持按时间区间自动清理旧数据,适用于需要定期归档历史记录的数据库维护场景。
本文详解Python读取中文TXT文本的方法,重点区分Python2与Python3的实现差异。针对Python2,需以unicode为中间编码进行转换,并特别注意处理UTF-8文件头部的BOM字符;Python3则可通过open函数的encoding参数直接指定编码。文章提供了具体的代码示例及decode方法的错误处理策略,帮助开发者避免乱码问题。
本文介绍使用Python 2.7实现MySQL数据库跨服务器迁移的方法。通过分页查询与提交机制,每5000条数据进行一次处理,确保迁移过程的稳定性和效率。代码支持自定义每次查询提交的数量,适用于需要大规模数据迁移的场景。
本文针对Python3爬虫抓取网页时出现的中文乱码问题,提供基于urllib库的编码处理方案。通过获取系统默认编码并手动解码响应内容,可有效解决数据展示异常,确保抓取结果正确显示中文。
本文深入解析Python pandas库中数据合并的核心方法。详细讲解merge函数的多对一、多对多连接及索引合并机制,涵盖inner、outer、left、right四种连接方式;同时剖析concat函数的轴向连接、索引处理及重叠数据填补策略,助力高效完成数据清洗与整合任务。
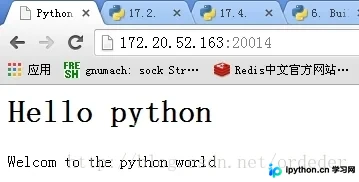
本文介绍如何使用Python标准库socket模块编写一个简易的HTTP服务器。通过server.py脚本监听指定IP和端口,接收浏览器请求并返回本地HTML文件内容。文章包含完整代码示例、index.html配置及测试步骤,帮助开发者快速理解HTTP通信基础。
本文介绍在Python中实现两个任意字符串表示的数字相乘的方法。利用Python整数无限精度的特性,无需处理溢出问题,直接转换字符串为整数进行计算。代码包含符号处理逻辑,并提供了多组测试用例验证结果,适合需要处理超大数值字符串乘积的场景。
本文系统介绍Pandas中DataFrame的核心操作方法。涵盖loc、iloc等索引机制,详解行与列的增删改查技巧,包括条件筛选、isin、where及sample抽样。通过具体代码示例演示如何高效处理数据框,适用于Python数据分析初学者与进阶用户。