

Python实现文件夹内文件批量排序与重编号
本文介绍利用Python脚本对指定文件夹内的文件进行批量排序和重编号的方法。通过遍历目录并修改文件扩展名,可实现有序命名。若需保持格式一致,建议分两次运行脚本以转换格式,确保最终结果符合预期。
2026-10-13
23

本文介绍利用Python脚本对指定文件夹内的文件进行批量排序和重编号的方法。通过遍历目录并修改文件扩展名,可实现有序命名。若需保持格式一致,建议分两次运行脚本以转换格式,确保最终结果符合预期。
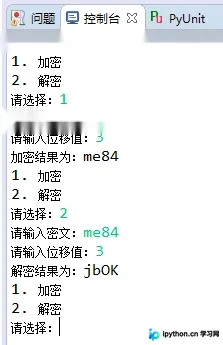
本文介绍Python实现的凯撒密码算法,通过字母位移进行加密解密。凯撒密码原理简单,将字母按顺序后移指定位数。文章提供完整Python代码示例及运行结果,并推荐多种在线加密解密工具,包括AES、DES、MD5及SHA系列算法,供开发者参考使用。
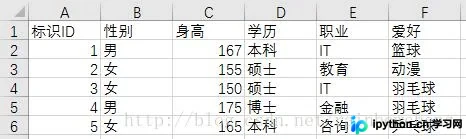
在使用Pandas处理数据时,isnull()生成的布尔矩阵难以直观识别缺失位置。本文介绍通过df.isnull().any()筛选含缺失值的列,并结合df[df.isnull().values==True]直接过滤出包含NaN的行,从而精准定位缺失数据的具体行列位置并辅助统计数量,提升数据清洗效率。
本文深入解析Pandas中DataFrame的行列数据筛选方法。通过对比df[]、df.loc、df.iloc及已弃用的df.ix,详细阐述基于标签与位置的索引逻辑。重点说明列选取时行索引不能为空的操作规范,以及混合索引类型的注意事项,帮助开发者高效处理表格数据。
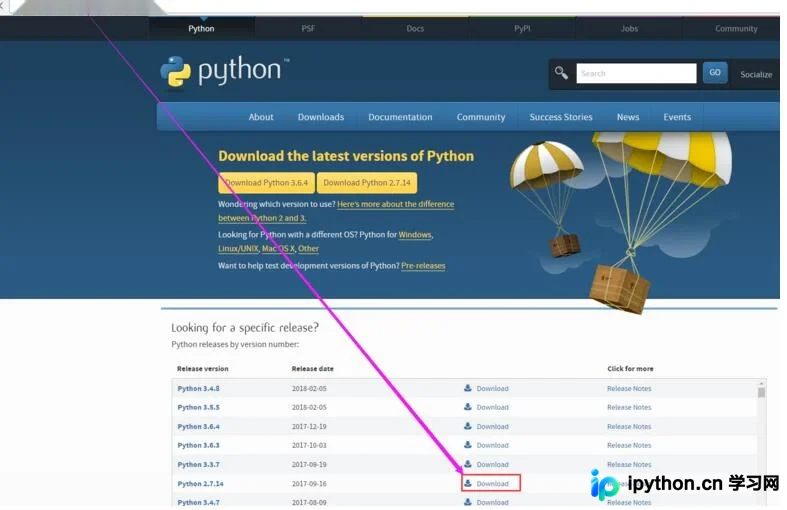
本文详细讲解如何在Eclipse中配置Python开发环境。内容包括安装Python 2.7、配置系统环境变量、在Eclipse Mars.2中安装指定版本的PyDev插件、创建PyDev工程以及编写并运行Python脚本的完整操作流程,帮助开发者快速搭建本地Python IDE。
本文介绍在pandas DataFrame中查找特定值所在行列的方法。通过遍历索引和列索引,或使用列表推导式,可以定位目标值的位置。示例展示了如何遍历demo_df数据框,查找值为'fox'的元素,并输出其行索引和列索引。
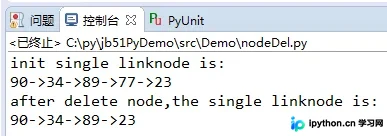
本文介绍在Python中实现单链表指定节点删除的具体方法。通过定义节点类与删除逻辑,演示如何覆盖目标节点数据以完成删除操作,并提供完整的初始化、删除及打印链表的代码示例,帮助开发者理解链表节点处理的核心机制。
本文提供了一段使用Python编写的TCP监听端完整代码。通过socket模块建立连接,利用struct处理数据头,实现了持续接收数据并解析线程ID与错误码的功能。代码包含异常处理机制,支持通过命令行参数指定监听端口,适用于需要稳定监听服务端口的Python开发场景。
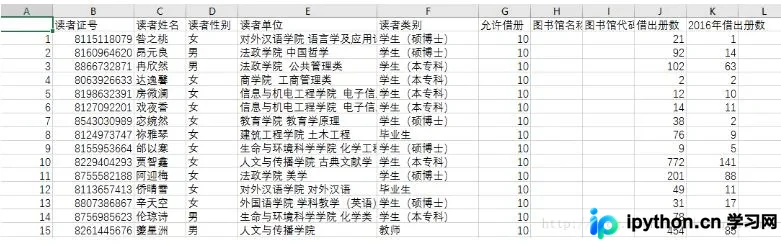
本文介绍如何利用Python的Pandas库合并两个CSV文件,实现图书数据集成。通过读取ReaderInformation.csv和ReaderRentRecode.csv,使用merge函数进行左连接,最终生成包含读者与借阅详情的data.csv文件,便于整体数据分析。
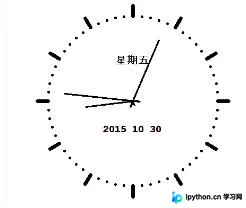
本文详细介绍两种在Python中实现动态时钟的方法。第一种利用Turtle图形库,通过建立5个Turtle对象分别绘制表盘、三根指针及文字输出,实现图形化动态更新。第二种基于控制台环境,通过导入time、sys和os模块,利用无限循环、字符串格式化及清屏刷新技术,在命令行实时显示当前时间。
本文介绍使用Python标准库计算文件MD5值的具体方法。通过读取二进制文件内容并调用hashlib模块生成摘要,示例展示了完整的CheckMD5OfFile.py脚本及命令行执行结果,适用于需要验证文件完整性的场景。
本文介绍在Python中利用NumPy库快速合并多个矩阵或数组的方法。内容涵盖纵向合并(vstack、r_)与横向合并(hstack、c_)两种核心操作,通过具体代码示例展示如何高效实现数组的行与列拼接,适用于数据处理与科学计算场景。