

Python实现用户登录注册验证功能详解
本文通过Python基础语法实现登录注册验证功能,涵盖函数定义、条件判断、循环结构及文件IO操作。详细解析登录与注册的业务流程,重点讲解try-except异常处理在文件读取中的应用,并展示完整代码实现,帮助初学者掌握用户信息存储与校验的核心技术。
2026-10-13
26

本文通过Python基础语法实现登录注册验证功能,涵盖函数定义、条件判断、循环结构及文件IO操作。详细解析登录与注册的业务流程,重点讲解try-except异常处理在文件读取中的应用,并展示完整代码实现,帮助初学者掌握用户信息存储与校验的核心技术。
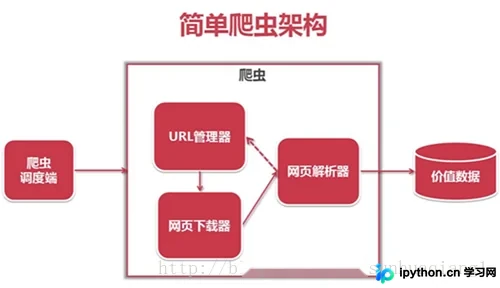
本文深入解析Python爬虫的核心架构,详细阐述URL管理器、HTML下载器及HTML解析器的功能与实现。通过完整代码示例,展示如何构建爬虫调度程序,实现网页数据的抓取、解析与输出。适合希望掌握Python爬虫基础原理与实战开发的开发者参考。
本文基于Python3重构了个性签名生成工具,利用Tkinter构建GUI界面,结合requests获取网页数据,并通过PIL处理图像。代码针对特定网站接口进行了适配,展示了如何从输入文字到生成个性化签名图片的完整流程,适合Python初学者参考学习。
本文详细解析Django中处理跨域请求的三种主流方法。首先介绍通过安装django-cors-headers库进行全局配置,其次讲解利用JSONP实现GET请求跨域的原理与代码示例,最后演示如何在views.py中手动设置响应头以控制单个接口。内容涵盖配置步骤、代码实现及注意事项,帮助开发者快速解决前后端分离时的跨域限制问题。
本文详解Python爬虫中BeautifulSoup的异常处理机制,涵盖HTTPError捕获404/500错误、空网页判断及AttributeError处理缺失标签。通过完整代码示例,展示如何编写健壮的爬虫程序,避免程序崩溃,提升代码健壮性。
本文深入解析Python中自定义函数的5种常见定义形式。涵盖标准函数、无参函数、带默认值参数函数、接收不定数量参数的函数以及Lambda匿名函数。通过具体代码示例展示各形式的语法结构与适用场景,帮助开发者掌握Python函数的灵活用法,提升代码编写效率。
本文介绍使用Python爬取个性签名的具体代码实现。通过tkinter构建图形界面,结合requests和re库获取网页数据,并处理编码转换问题,最终生成并展示个性签名图片。
本文详细介绍如何使用Python的poplib和email模块通过POP3协议获取邮件内容并解析。示例代码演示了连接服务器、下载邮件、处理编码及提取关键信息(发件人、主题、正文)的完整流程,适用于Python开发者进行邮件自动化处理或内容抓取。
本文解析Python中利用for循环结合列表推导式创建列表的语法。通过机器学习实战中的featList与classList生成示例,详细说明了如何从数据集中提取特定元素(如第i列或最后一列)并构建新列表。同时提供了基础的平方数生成案例,展示该语法在简化代码、提升效率方面的实际应用价值。
本文介绍NumPy中fromstring函数的使用方法,通过创建长度为16的字符串示例,演示如何将其转换为int8、int16、int32、int64、float32及float64等不同数据类型的矩阵。文章详细解析了ASCII码转换原理及默认数据宽度设置,为处理字符串到数值矩阵的转换提供实用参考。
在使用pandas的read_csv()函数读取CSV文件时,若未指定数据类型,数值列可能被默认读取为object类型,导致后续比较运算抛出TypeError。本文通过示例展示如何查看列类型,并利用dtype参数在读取时显式指定数值类型,从而解决字符串与整数比较的错误。
本文介绍如何使用Python将CSV文件中的数据读取并转换为List和Dictionary类型的变量。通过示例代码展示了从文件读取到数据格式化的完整过程,适用于需要将CSV数据用于JSON处理或进一步分析的场景。