

利用NumPy与pandas将数组数据写入CSV文件的完整指南
本文详细演示如何使用NumPy的savetxt函数和pandas的to_csv方法将数组数据保存为CSV文件。内容涵盖设置随机种子、生成含NaN值的3x4数组、指定格式与分隔符,以及处理DataFrame列名和缺失值字符串,提供完整的代码示例与参数说明。
2026-10-13
22

本文详细演示如何使用NumPy的savetxt函数和pandas的to_csv方法将数组数据保存为CSV文件。内容涵盖设置随机种子、生成含NaN值的3x4数组、指定格式与分隔符,以及处理DataFrame列名和缺失值字符串,提供完整的代码示例与参数说明。
本文详解利用Numpy和Pandas库将CSV文件数据读取为数组或矩阵的方法。重点解决路径转义字符导致的SyntaxError,并演示使用Pandas处理缺失值及结合Sklearn的Imputer进行数据清洗的完整流程。
本文深入解析TensorFlow中两种核心权值更新机制。首先介绍通过tf.train.ExponentialMovingAverage实现的目标网络权值滑动平均更新,涵盖apply与average方法的使用及TAU参数设置。其次阐述tf.train.Optimizer的自动与手动梯度更新流程,包括compute_gradients、自定义处理及apply_gradients步骤,并补充tf.gradients与tf.stop_gradient在特定算法如DQN中的应用场景。
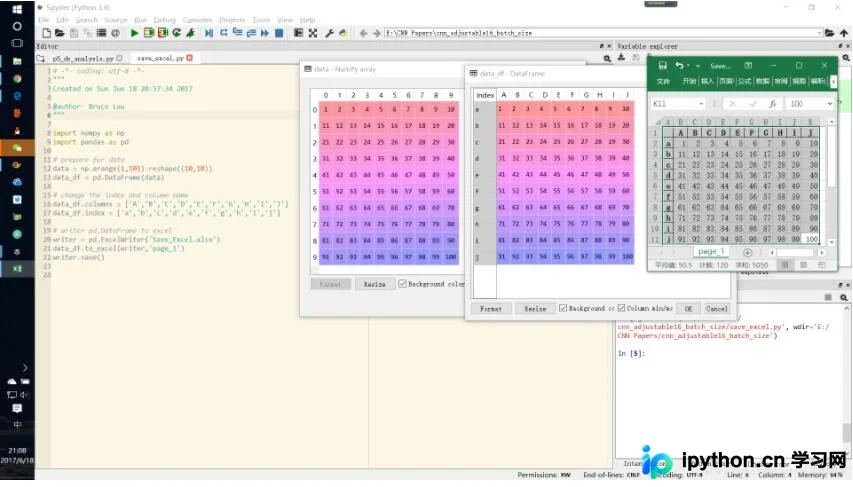
本文介绍如何使用pandas库将numpy数组转换为DataFrame并导出为Excel文件。通过设置列名、索引及浮点数精度,实现数据的高效保存。示例代码展示了从数据准备到文件写入的完整流程,适用于需要批量处理数值数据的场景。
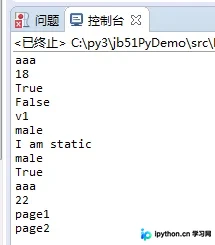
本文系统介绍Python中常用的字符串处理方法,涵盖isalnum、isalpha、isdigit等判断方法,lower、upper、strip等转换与清理方法,以及replace、split、join、format等高级操作。通过具体示例解析各方法的参数与返回值,帮助开发者高效处理文本数据。
本文详解Python3.6中的反射操作,通过具体代码示例展示如何利用getattr、hasattr和setattr动态获取对象属性、检查成员存在性及添加成员。内容涵盖类实例与模块级别的反射应用,帮助开发者掌握Python动态特性在实际编程中的技巧。
本文介绍如何利用Python的openpyxl库与正则表达式,解决Excel中非规律性数据的提取难题。通过定义日期和邮箱的正则模式,遍历指定单元格范围提取关键信息,并将结果写入新建的工作表中,最终实现自动化数据整理与保存,适用于需要统计特定时间段项目用时的场景。
在 TensorFlow 中直接输出变量仅显示属性而非具体数值。本文介绍通过 InteractiveSession 结合 initializer.run() 初始化及 sess.run() 方法,正确获取并打印变量实际值的操作流程。
本文介绍如何利用Python的scipy库进行最小二乘法曲线拟合。通过定义包含四个参数的逻辑函数,生成含噪声的测试数据,并使用optimize.leastsq函数优化参数。文章包含完整的代码示例及可视化结果,展示如何对比真实值与估计值,适合需要处理非线性数据拟合的开发者参考。
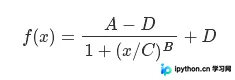
本文总结了TensorFlow在版本升级过程中常见的几类错误及其解决方案,包括rnn_cell属性缺失、concat参数顺序调整、pack函数替换为stack、softmax_cross_entropy_with_logits命名参数规范以及变量作用域复用问题。通过具体代码修正示例,帮助开发者快速定位并修复因API变更导致的程序异常,确保模型训练与部署的稳定性。
在TensorFlow中直接打印Tensor对象仅能获取其形状和类型信息,无法看到具体数值。本文介绍了通过tf.Session或tf.InteractiveSession执行会话来提取Tensor实际值的方法,帮助开发者在模型调试时准确获取数据结果。
本文介绍如何在Python中使用Pandas库筛选数据集中特定列字符串长度大于20的记录。核心步骤包括将目标列强制转换为字符串类型,利用str.len()方法计算长度,并通过布尔索引过滤出满足条件的数据行。该方法简洁高效,适用于处理包含长文本字段的数据集。