

Python中使用sklearn划分训练集与测试集的方法
本文介绍如何使用Python的sklearn库中的train_test_split函数,将数据集按比例随机划分为训练集和测试集。文章详细解析了该函数的参数用法、返回值含义,并对比了直接传入特征标签与传入含标签数据框的不同处理方式,最后提供了一个自定义划分函数的实现示例,帮助开发者掌握数据预处理的核心技巧。
2026-10-13
34

本文介绍如何使用Python的sklearn库中的train_test_split函数,将数据集按比例随机划分为训练集和测试集。文章详细解析了该函数的参数用法、返回值含义,并对比了直接传入特征标签与传入含标签数据框的不同处理方式,最后提供了一个自定义划分函数的实现示例,帮助开发者掌握数据预处理的核心技巧。
本文介绍了如何在Python环境中利用KNN算法对Iris数据集进行分类。通过加载数据集、划分训练测试集、标准化处理以及模型训练与评估,展示了完整的分类流程。代码示例涵盖了从数据加载到结果输出的关键步骤,帮助读者快速掌握KNN在分类任务中的应用。
本文深入解析Python中StratifiedShuffleSplit函数的使用方法。该函数通过分层洗牌策略,在保持类别比例一致的前提下进行多次随机分割,适用于不平衡数据集的模型训练。文章详细说明了n_splits、test_size、train_size及random_state等关键参数的配置逻辑,并结合具体代码示例展示了如何生成满足特定比例的多组训练与测试集,帮助开发者优化模型评估流程。
本文针对Python3环境提供爬虫入门指南,对比Python2差异,推荐边学边做。通过抓取知乎首页源码演示urllib.request.urlopen()用法,解析HTML并处理编码,介绍爬虫流程及数据提取存储方法,帮助初学者快速上手。
本文精选5本适合不同基础的Python入门书籍,涵盖从零基础到项目实战的完整学习路径。推荐《Python基础教程》《与孩子一起学编程》《笨办法学Python》《Python编程入门》及《计算机编程导论》,帮助读者高效掌握字符串、列表等核心概念,并通过小项目巩固技能,是Python初学者不可错过的学习资源。
本文介绍如何利用Python sklearn库中的KFold方法生成交叉验证数据集,并保存为CSV文件。文章指出直接使用KFold可能无法满足样本分布比例一致的需求,需分别对正负样本进行KFold处理后再合并。同时澄清了train和test是原始数据集的索引而非子数据集索引,并提供了相关代码示例。
本文介绍如何使用pandas将多个DataFrame写入Excel的不同Sheet。重点指出常见错误:误用ExcelFile导致文件保存路径问题,并解析源码揭示其基于xlrd的实现机制。通过正确使用ExcelWriter可避免文件丢失,确保数据持久化。
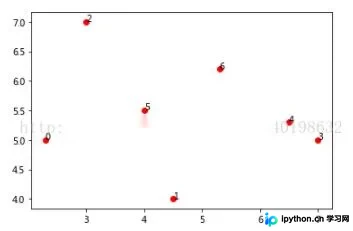
本文介绍如何在Python中利用Matplotlib库绘制二维散点图,并通过enumerate函数遍历数据索引,使用annotate方法为每个数据点添加序号或名称标注,实现数据的直观可视化展示。
本文介绍利用Python进行文件读写、正则表达式提取及集合去重的完整流程。通过示例代码展示如何遍历源文件,使用re模块匹配特定字段,并借助set数据结构实现高效去重,最终将唯一结果写入目标文件。
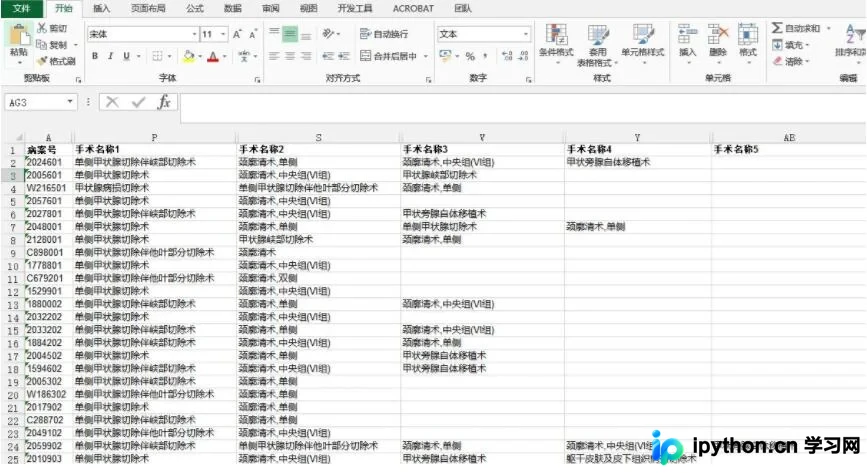
本文介绍如何使用Python从包含近2000行的数据表中提取含特定关键字的整行数据。针对Excel单列筛选导致顺序混乱的问题,通过Python脚本实现多列(P, S, V, Y, AB列)关键字‘颈廓清术,中央组(VI组)’的匹配,并完整保留原始数据顺序。最后提供利用Excel定位空值删除空白行的后续处理技巧,确保输出表格整洁且逻辑一致。
本文介绍利用Python将网页新闻转换为语音文件的完整方案。通过readability或goose3库提取网页正文,调用百度REST API进行文本转语音,并使用playsound库实现音频播放。文章详细讲解了API调用限制、文本切割合并及环境配置等关键步骤,帮助开发者快速实现网页朗读功能。
本文介绍Python处理Excel时插入和删除行的两种方案。openpyxl虽常用但中间操作性能差,需转换列表或修改源码;推荐xlwings,支持调用VBA接口,在Windows和macOS下运行高效且兼容WPS,适合需要动态调整行数的场景。