

Python实现网页正文转语音的完整流程

本文介绍利用Python将网页新闻转换为语音文件的完整方案。通过readability或goose3库提取网页正文,调用百度REST API进行文本转语音,并使用playsound库实现音频播放。文章详细讲解了API调用限制、文本切割合并及环境配置等关键步骤,帮助开发者快速实现网页朗读功能。
随着气温逐渐降低,有时我们只想浏览网页新闻,却不愿伸手移动鼠标。此时,若能像听故事一样让电脑朗读内容便十分惬意。既然人生苦短,不妨尝试使用Python来实现这一功能。
将网页内容转换为语音主要包含以下步骤:
首先识别并提取网页正文,获取纯文本内容;
接着利用接口将文本转换为语音文件;
最后播放生成的语音文件。
1 网页正文识别
Python拥有丰富的第三方库,处理网页正文提取并非难事。本文主要介绍以下两个工具:
readability、goose3
1.1 readability
readability支持Python3,可通过命令pip install readability-lxml进行安装。
该库的使用方式十分简便:
import requests
from readability import Document
response = requests.get('http://news.china.com/socialgd/10000169/20180616/32537640_all.html')
doc = Document(response.text)
print(doc.title())
需要注意的是,readability提取出的正文仍包含HTML标签,并非纯文本。
若需进一步处理,可结合html2text等组件清洗HTML,此处不再展开,读者可自行尝试。
1.2 goose3
Goose原为Java编写的文章提取器,随后出现了Python实现版本:goose3。
其使用同样便捷,且对中文支持良好,通过pip install goose3即可安装。
>>> from goose3 import Goose
>>> from goose3.text import StopWordsChinese
>>> url = 'http://news.china.com/socialgd/10000169/20180616/32537640_all.html'
>>> g = Goose({'stopwords_class': StopWordsChinese})
>>> article = g.extract(url=url)
>>> print(article.cleaned_text[:150])
以北京时间6月15日23:00(圣彼得堡当地时间18:00)为例,2018年世界杯B组一场比赛在圣彼得堡球场进行,伊朗1比0险胜摩洛哥,伊朗前锋阿兹蒙在半场结束前错失单刀机会,鲍哈杜兹在第95分钟自摆乌龙。
这是伊朗20年来首次在世界杯决赛圈取得胜利。
本届世界杯中,还相继出现了替补球员进球、替补球员梅开二度以及东道主表现等精彩瞬间。
由此可见,网页正文提取效果良好,基本满足需求,可以使用。
注意:goose还有一个Python2版本名为Python-Goose,其使用方法与goose3基本一致。
2 文本转语音
百度、阿里、腾讯、讯飞等厂商均提供REST API接口用于文本转语音。其中,阿里和腾讯的申请周期较长,阿里服务似乎还需付费,而百度和讯飞在线申请后即可使用。
优质资源往往获取不易。其中,百度接口没有明确的调用量限制(默认上限为200000次/天),而讯飞接口每天限制500次。
本文选用百度REST API中的语言合成接口,原因有二:一是百度调用次数无限制;二是讯飞接口文档显示其限制较多。此外,百度提供了Python封装库,使用更为便捷。
2.1 baidu-aip 的使用
百度提供了Python SDK,可通过pip install baidu-aip直接安装。接口使用详情可参考官方文档:http://ai.baidu.com/docs#/TTS-Online-Python-SDK/top。
使用示例如下:
from aip import AipSpeech
"""
你的 APPID AK SK
这些信息均可在服务控制台的应用列表中查看。
"""
APP_ID = '你的 App ID'
API_KEY = '你的 Api Key'
SECRET_KEY = '你的 Secret Key'
client = AipSpeech(APP_ID, API_KEY, SECRET_KEY)
result = client.synthesis('你好,你在做什么', 'zh', 3, {
'vol': 5,
})
# 识别正确返回语音二进制 错误则返回dict 参照下面错误码
if not isinstance(result, dict):
with open('auido.mp3', 'wb') as f:
f.write(result)
接口参数说明:
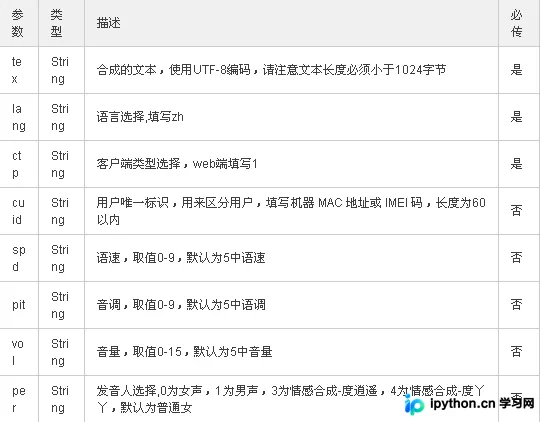
接口对单次传入文本长度有限制,合成文本必须小于1024字节。若文本过长,需进行切割处理,通过多次请求分别生成语音文件,最后将多个语音文件合并为一个。
2.2 文本切割
可使用如下代码将文本分割为多个长度为500的文本列表:
# 将文本按 500 的长度分割成多个文本
text_list = [text[i:i+500] for i in range(0, len(text), 500)]
我们使用pydub库处理生成的音频文件,通过pip install pydub安装即可。
此外,在Ubuntu环境下需安装依赖,使用sudo apt-get install libav-tools命令安装;在Windows环境下,需从https://ffmpeg.zeranoe.com/builds/下载FFmpeg并将其配置到环境变量中。
若遇到问题,可参考官网配置指南:https://github.com/jiaaro/pydub。
# 合并音频文件
def merge_voice(file_list):
voice_dict = {}
song = None
for i,f in enumerate(file_list):
if i == 0:
song = AudioSegment.from_file(f,"mp3")
else:
# 拼接音频文件
song += AudioSegment.from_file(f,"mp3")
# 删除临时音频
os.unlink(f)
# 导出合并后的音频文件,格式为MP3格式
file_name = str(uuid.uuid1()) + ".mp3"
song.export(file_name, format="mp3")
return file_name
通过百度接口可将文字转化为音频文件,接下来的问题是如何播放该音频。
3 音频文件播放
网上介绍Python播放wav文件的方法有多种,包括pyaudio、pygame、winsound、playsound等。经测试,仅playsound成功。其他方法有兴趣者可自行尝试,如有问题欢迎留言交流。
通过pip install playsound安装后即可使用。
使用方法十分简单:
>>> from playsound import playsound
>>> playsound('/path/to/a/sound/file/you/want/to/play.mp3')
说明:音频播放需在图形化界面下运行,因为命令行模式下缺乏声音输出出口。
python page2voice.py -u https://so.gushiwen.org/shiwenv_c244fc77f6fb.aspx
运行代码后,程序将自动解析网页并进行朗读。
至此,网页到音频的转换流程结束。当然,该程序并非完美,例如中英文混合网页的解析和转换效果不佳,但纯中文新闻页面的效果尚可。
总结
以上介绍了Python网页正文转换语音文件的操作方法,希望对大家有所帮助。如有任何疑问,请留言,小编会及时回复。在此感谢大家对本站网站的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









