

Python实现图片转Excel:基于像素RGB值生成彩色表格
本文介绍如何使用Python将图片转换为Excel文档。通过PIL读取图像像素RGB值,利用xlsxwriter设置单元格背景色,并根据坐标写入Excel文件。代码示例展示了从读取图像、获取RGB数据到生成带颜色表格的完整流程,供开发者参考学习。
2026-10-13
9

本文介绍如何使用Python将图片转换为Excel文档。通过PIL读取图像像素RGB值,利用xlsxwriter设置单元格背景色,并根据坐标写入Excel文件。代码示例展示了从读取图像、获取RGB数据到生成带颜色表格的完整流程,供开发者参考学习。
本文详解Python中getopt模块的使用方法,通过解析sys.argv获取命令行参数。介绍短选项(shortopts)和长选项(longopts)的定义规则,包括参数标识符、冒号及等号的作用。通过示例展示如何区分需参与不需参选项,并解析返回值中的选项元组与剩余参数,帮助开发者构建灵活的脚本逻辑。
本文全面解析Python中列表(list)的核心操作。涵盖列表定义、索引与切片、增删改查(append, del, remove)、组合与迭代、排序及列表推导式等常用方法。重点深入剖析Python中列表复制的常见误区,通过对比直接赋值与list()构造函数的区别,揭示引用传递机制,帮助开发者避免项目中的隐蔽Bug,提供从入门到进阶的实用代码示例。
本文介绍在Python中读取CSV文件并剔除指定列后写入新文件的两种实现方式:原生文件IO循环处理与Pandas DataFrame操作。通过对比27万至110万条数据的处理耗时,结果显示Pandas方案在大数据量下效率提升约30%,逻辑更清晰且性能更优。
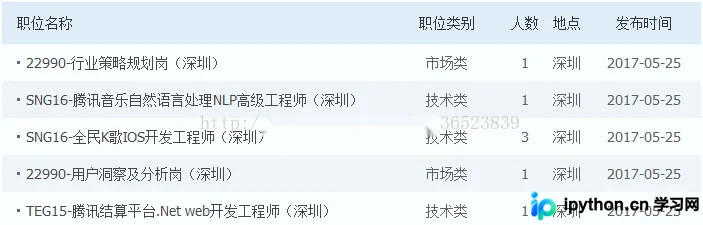
本文介绍如何使用Python3和Scrapy框架爬取腾讯招聘网信息并生成CSV文件。通过调用cmdline命令而非导入csv模块,实现高效数据导出。示例包含items定义、Spider编写及yield用法解析,适合新手参考学习。
本文详解Scrapy框架应对常见反爬机制的策略。涵盖通过中间件随机User-Agent、处理Referer与Cookies、利用X-Forwarded-For伪装代理,以及配置带认证的代理IP。针对动态加载内容,介绍通过Ajax接口分析或结合Selenium与PhantomJS模拟浏览器渲染的方法,并提供相关代码实现与注意事项。
本文详细解析Python解决N阶台阶走法问题的两种核心思路。针对兔子每次可跳1、2或3阶的场景,文章指出该问题属于排列而非组合,并分别提供了递归与非递归(递推)的代码实现。通过对比两种方法的逻辑与执行效率,帮助开发者深入理解基础算法在Python中的应用。
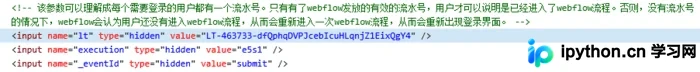
本文详解使用Python登录CSDN并抓取博客文章列表的完整流程。通过Fiddler分析登录接口,解决参数错误、JS跳转及正则匹配等常见问题,提供可直接运行的代码实例,帮助开发者掌握Web自动登录与数据抓取技巧。
本文深入解析Python中K最近邻(KNN)算法的实现。从基础分类原理出发,详细讲解欧几里得距离计算、K值选择及加权平均策略(反函数、减法、高斯函数)。通过白酒价格预测案例,演示数据预处理、交叉验证评估、属性缩放优化及概率分布分析,帮助开发者掌握KNN在实际项目中的应用与调优技巧。
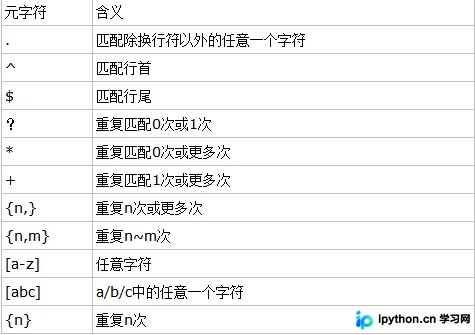
本文详细解析Java与Python中正则表达式的核心语法,涵盖元字符、转义处理及常用匹配模式(如邮箱、身份证、强密码验证)。重点介绍Python re模块的compile、search、match、findall等方法,深入讲解match对象的使用及子模式扩展语法,通过代码示例展示高级匹配技巧,帮助开发者高效处理复杂字符串任务。
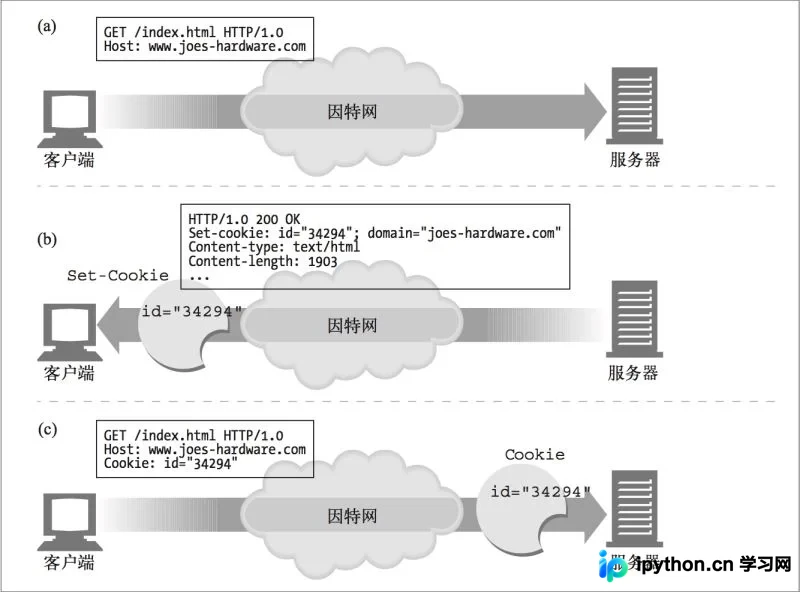
本文深入解析Python爬虫中Cookie与Session的核心机制。详细阐述Cookie作为客户端存储的身份标识,涵盖Version0与Version1的属性差异及过期策略;解析Session如何通过唯一ID减少数据传输并保障服务器性能。对比两者在安全性、存储位置及适用场景上的区别,帮助开发者优化爬虫策略与Web交互逻辑。
本文详细解析Python中两种主要的字符串格式化方式:%操作符与.format()方法。通过具体代码示例,介绍%d、%f、%s等常见占位符的用法,讲解整数补零、小数位数控制及特殊字符转义技巧,并对比.format()方法中位置参数与命名参数的使用场景,帮助开发者掌握高效的文本格式化技巧。