

Python解析HTML提取数据并生成Word文档的完整实现
本文详细介绍如何利用Python解析HTML网页内容并生成Word文档。通过安装setuptools和python-docx组件,结合sgmllib与urllib获取数据,实现了从网页抓取到文档生成的自动化流程。文中提供了完整的代码示例及安装步骤,适用于需要批量处理网页数据并导出为Word格式的场景。
2026-10-13
9

本文详细介绍如何利用Python解析HTML网页内容并生成Word文档。通过安装setuptools和python-docx组件,结合sgmllib与urllib获取数据,实现了从网页抓取到文档生成的自动化流程。文中提供了完整的代码示例及安装步骤,适用于需要批量处理网页数据并导出为Word格式的场景。
本文介绍如何使用Python脚本自动导出Hive数据表的字段及类型信息。通过连接Hive并遍历所有表,获取每表的列名与数据类型,最终生成包含表结构详情的Excel文件,旨在为运营团队提供清晰的HUE查询支持。
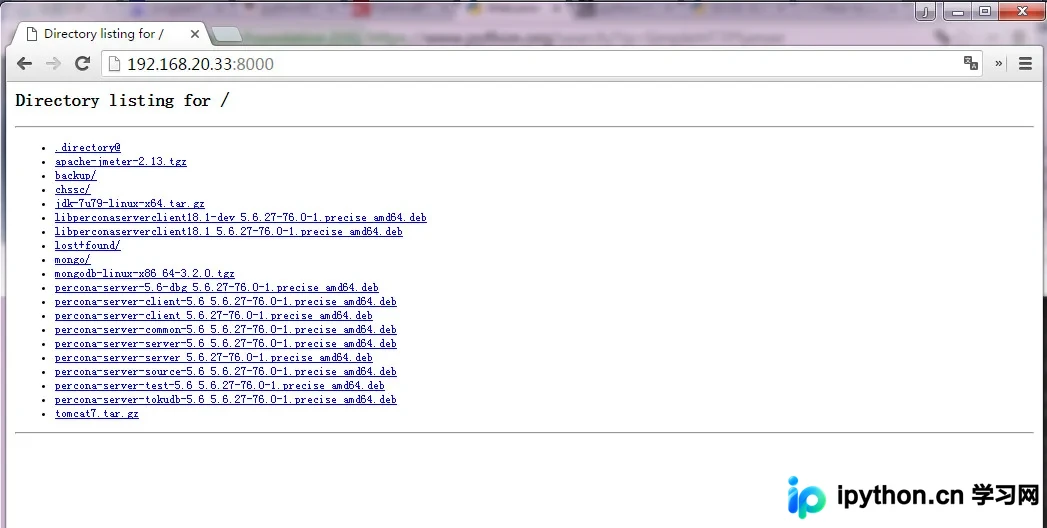
本文介绍如何使用Python内置的SimpleHTTPServer模块快速共享Linux目录。相比FTP或网络文件系统,该方法无需复杂配置,适用于项目团队内部快速文件共享。文章详细说明了Python 2与Python 3的使用差异、具体命令行操作步骤、默认端口设置以及防火墙注意事项,帮助开发者高效实现本地目录的Web访问。
本文详解如何利用Python内置函数getattr实现动态分发模式。通过拼接字符串动态获取模块函数,实现灵活的输出格式扩展。同时指出松耦合带来的潜在Bug,并介绍使用getattr第三个参数设置默认返回值以增强代码健壮性的最佳实践。
本文介绍Python中处理文本字符串的常用技巧。通过string.split()进行基础分割,利用正则表达式排除标点符号,过滤空字符串,并使用.lower()统一大小写。结合完整邮件示例,展示从原始文本到标准化词表的完整处理流程,适用于基础NLP数据清洗场景。
本文详解Python求解最长回文子串长度的两种核心方法。首先介绍基础的中心扩展法,通过插入特殊字符统一处理奇偶长度回文串。随后深入分析Manacher算法的优化思路,利用已知最大半径提前剪枝,避免无效计算。通过对比1000个字符的测试数据,展示优化后算法性能提升约10倍的实际效果,并提供完整代码实现与测试案例。
本文详细解析Python2与Python3在print语句、默认编码、用户交互及数据类型上的关键差异。重点说明Python3中print作为内置函数的特性、UTF-8默认编码优势,以及input与raw_input的行为变化,帮助开发者快速理解版本迭代带来的语法规范升级。
本文深入解析Python中threading模块的使用,涵盖通过Target参数和继承Thread类两种方式创建线程。重点探讨线程终止策略,对比setDaemon()与Event机制的差异,指出setDaemon可能导致资源未释放的风险,并推荐通过Event机制安全终止子线程,附带完整代码示例与执行结果分析。
本文介绍如何使用Python语言结合SQLite数据库与Excel文件进行高效的数据分析处理。内容涵盖Python环境配置、xlrd库的安装以及SQLite数据库的调用,并通过完整代码示例展示了从Excel读取数据写入数据库及查询的全过程,旨在为缺乏编程环境的用户提供一种快速处理大量Excel数据的解决方案。
本文详细介绍了Python中遍历文件目录的三种常用方法,包括使用os.listdir结合递归、os.path.walk以及os.walk。通过具体代码示例对比了各方法的实现逻辑与输出差异,帮助开发者根据实际需求选择高效的目录遍历方案。
本文详解Python内置logging模块的配置方法,通过结合logging.basicConfig与StreamHandler实现不同级别日志的打印与存储。示例展示了如何设置DEBUG至INFO级别的输出格式,并将错误及警告信息写入指定日志文件,帮助开发者高效管理日志输出。
本文详细介绍Python中实现文件复制的两种常用方法。第一种通过open()打开文件并使用read()和write()手动模拟拷贝过程;第二种利用内置的shutil模块,调用copyfile()实现快速复制。文章提供完整代码示例,帮助开发者掌握不同场景下的文件操作技巧。