Ubuntu下Python使用Tesseract进行OCR文字识别的完整指南
本文详细介绍在Ubuntu系统中配置Python环境以实现基于Tesseract的OCR文字识别功能。涵盖tesseract-ocr、pytesseract及Pillow库的安装步骤,提供完整的Python识别代码示例。针对中文识别缺失训练包的问题,给出chi_sim训练数据的安装方法,并说明中英文识别效果的差异。
2026-10-13
11

本文详细介绍在Ubuntu系统中配置Python环境以实现基于Tesseract的OCR文字识别功能。涵盖tesseract-ocr、pytesseract及Pillow库的安装步骤,提供完整的Python识别代码示例。针对中文识别缺失训练包的问题,给出chi_sim训练数据的安装方法,并说明中英文识别效果的差异。

本文详细介绍Python中的序列解包技术,涵盖元组、列表及字典的解包操作。通过具体代码示例,演示如何利用解包快速提取可迭代对象中的元素,包括字典的键值对获取与popitem方法的应用,帮助开发者提升代码简洁性与执行效率。
本文深入解析朴素贝叶斯算法原理,基于贝叶斯定理并通过条件独立性假设简化计算。文章详细推导了从特征向量到类别概率的转换过程,并提供Python完整实现代码,涵盖模型训练与分类预测,适合希望理解并应用该算法的开发者参考。
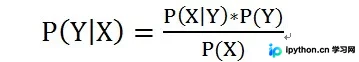
本文深入解析Python中类变量与实例变量的定义、访问方式及相互关系。通过代码示例验证,当使用self修改类变量时,实际是创建了同名的实例变量并屏蔽类变量。类变量由所有实例共享,建议通过类名访问;实例变量仅属于特定对象。理解这一机制有助于避免变量作用域混淆。
本文介绍利用Python进行图片二值化处理以提高OCR识别率的完整代码。通过PIL库将图像转为灰度,设定阈值200进行黑白分割,最终生成高对比度图像供Tesseract识别,有效提升文字提取准确率。

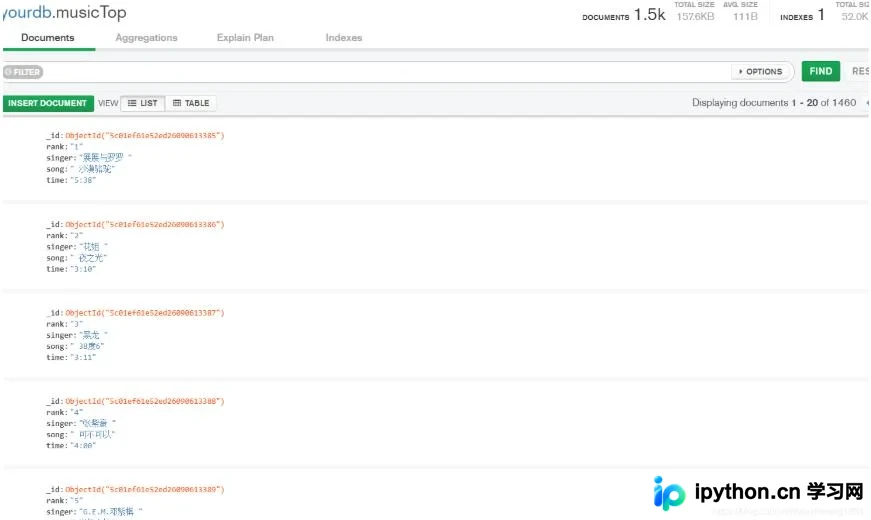
本文介绍如何使用Python3编写爬虫程序,自动抓取酷狗音乐TOP500榜单中的排名、歌曲名及时长信息。通过构造分页URL批量获取数据,并利用MongoDB数据库进行持久化存储,实现自动化数据采集与保存。
本文演示了如何使用Python将Excel数据高效导入SQL Server数据库。通过结合xlrd读取Excel文件与pymssql建立数据库连接,实现了批量插入操作。示例中处理一万多条数据耗时仅1秒左右,代码逻辑清晰,适合需要快速迁移数据的场景参考。
本文详解Flask框架中视图与模板的核心功能。涵盖Session基于Cookie的加密存储机制及Secret Key配置,解析请求与应用上下文的差异,深入讲解Jinja2模板的渲染、过滤器与自定义方法。同时介绍宏、继承、包含等模板特性,以及Web表单处理与CSRF保护的具体实现步骤。
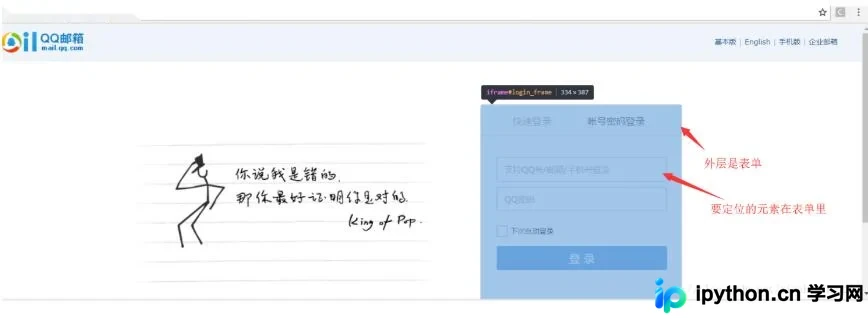
本文详解在Python3 Selenium自动化测试中处理Frame表单嵌套问题的方法。针对直接定位元素报错的情况,通过QQ邮箱登录实例,演示如何识别iframe结构并使用switch_to.frame()进行切换,从而成功定位并操作内部元素,提供完整可运行的代码参考。
本文深入解析Python Flask框架中的视图内容与模板实现。详细阐述Session基于Cookie的存储机制及Secret Key配置,区分请求与应用上下文。涵盖模板渲染、内置与自定义过滤器、宏继承包含等高级用法,以及Web表单处理与CSRF防护策略,提供完整代码示例。
本文介绍利用Python的docx库结合正则表达式,实现同时批量修改多个Word文档中特定内容的自动化方法。通过遍历段落并执行替换操作,可将指定关键词批量转换为不同目标文本,生成多个新文档,有效提升办公效率。
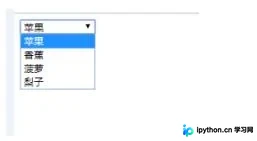
本文介绍在Python Selenium自动化测试中如何处理常见的下拉框元素。通过导入selenium.webdriver.support.select模块,利用Select类对指定下拉列表进行定位,并演示如何使用select_by_visible_text方法精确选择如“菠萝”等特定选项,帮助开发者解决Web UI自动化中的表单交互问题。