

Python矩阵运算避坑:解决矩阵乘向量与实数顺序导致的维度错误
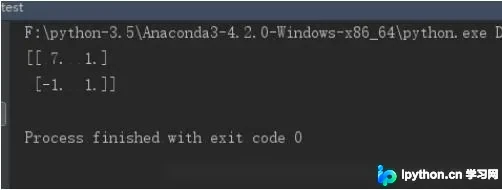
本文针对Python中使用NumPy进行矩阵运算时常见的维度错误进行解析。重点讨论矩阵乘向量及矩阵与实数相乘时,因操作顺序或数据类型(array与mat)混淆导致的报错问题。通过具体代码示例,展示如何正确调整运算顺序以解决维度不匹配错误,确保计算结果符合预期。
2026-10-13
14

本文针对Python中使用NumPy进行矩阵运算时常见的维度错误进行解析。重点讨论矩阵乘向量及矩阵与实数相乘时,因操作顺序或数据类型(array与mat)混淆导致的报错问题。通过具体代码示例,展示如何正确调整运算顺序以解决维度不匹配错误,确保计算结果符合预期。
本文介绍如何利用Python的itchat模块实现微信自动回复与群聊消息转发功能。通过注册TEXT和PICTURE消息类型,程序可自动回复好友发送的文本或图片。此外,脚本支持监控特定群聊中带有“+1”回复的消息,并将其转发至指定好友,适用于订餐统计等场景。
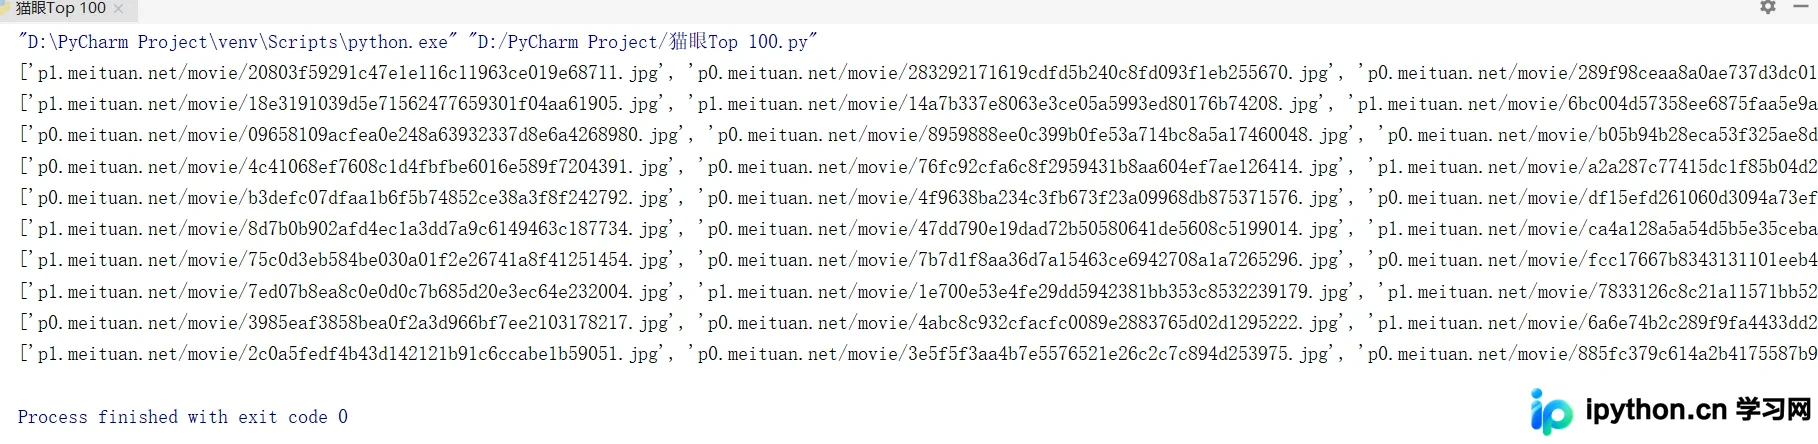
本文通过Python爬虫实战,演示如何使用正则表达式从猫眼电影Top100榜单批量下载电影封面图。文章详细解析了页面元素分析、URL规律观察及正则匹配策略,结合requests与re模块实现数据提取,并探讨该方法的优缺点及与其他爬虫技术的对比。
本文介绍Python3中实现进制间转换的方法。通过内置函数bin()、oct()和hex(),可将十进制数分别转换为二进制、八进制和十六进制格式。同时演示如何将非十进制数值还原为十进制,适用于基础编程学习。
本文介绍使用Python Selenium库实现自动化登录百度网盘,并批量读取包含分享链接和提取码的文本文件,自动打开链接、输入提取码并将资源保存至指定目录的完整流程与代码示例。
本文提供基于Python的电影下载链接爬虫实现方案。利用urllib2发起请求,结合BeautifulSoup解析HTML结构,提取电影标题及下载URL。代码包含分页处理、文件写入及编码转换逻辑,适用于学习Python网络爬虫基础与网页数据提取技术。
本文详细介绍如何使用Python3、百度AI开放平台语音识别API及图灵机器人API,从零搭建一个实时语音对话机器人。教程涵盖环境配置、录音模块实现、STT文字转换、图灵智能回复及TTS语音合成全流程,提供完整代码与常见问题解答,帮助开发者快速构建具备中文语义交互能力的本地语音助手。
本文详细介绍Python Selenium中处理Select下拉选择框的两种核心方法:通过XPath直接定位元素,以及利用Selenium内置的Select模块进行标准化操作。重点解析select_by_index、select_by_value和select_by_visible_text三种选择方式,以及取消选择和获取选项属性的相关方法,适用于标准HTML select标签及非标准伪下拉框的自动化测试场景。
本文通过具体代码示例,详细解析NumPy中求平均值时axis参数的作用。通过展示二维数组在不同axis取值下的计算结果,对比手动实现与内置函数的差异,帮助读者准确掌握按行或按列求平均值的设定方法。
本文详解Python3 numpy中mean和average函数的区别。两者在不指定权重时功能一致,均可计算均值及指定轴方向的平均值。主要差异在于average支持weights参数计算一维加权平均值,而mean不支持。文章通过代码示例展示具体用法与运行结果。
本文详细解析Python中*args和**kwargs的使用机制。*args用于接收未命名的位置参数并打包为元组,**kwargs用于接收命名参数并打包为字典。文章通过代码示例展示了装包与解包的具体行为,包括在函数定义及调用时的区别,并总结了参数传递时的顺序限制与注意事项,帮助开发者掌握灵活传参技巧。
本文深入解析Python中函数调用的形参打包与解包机制。通过对比C++的this指针,阐述如何利用*和**操作符统一静态函数与实例方法的调用接口。重点讲解元组参数的传递、单个参数打包为元组的语法细节(如尾随逗号的作用),以及在实际API调用中处理Process等场景时的注意事项,帮助开发者编写更灵活、统一的代码。