Python类中的__slots__原理解析
本文解析Python中__slots__魔法方法的原理。默认情况下,实例化对象会生成字典保存属性,导致内存浪费。通过定义__slots__,可禁止使用字典,仅分配固定集合属性的空间,从而节省内存并限制动态添加属性。
2026-10-13
12

本文解析Python中__slots__魔法方法的原理。默认情况下,实例化对象会生成字典保存属性,导致内存浪费。通过定义__slots__,可禁止使用字典,仅分配固定集合属性的空间,从而节省内存并限制动态添加属性。
本文介绍如何在 Python3 环境中使用 Pillow 库生成随机验证码。通过创建指定尺寸的图像,利用 ImageDraw 添加干扰线条与噪点,并结合 ImageFont 设置字体渲染随机字符。代码示例展示了从初始化画布、绘制干扰元素到保存文件的完整流程,帮助开发者快速掌握验证码生成技术。
本文提供基于Python3语法的简单网页图片抓取代码实例。针对Python2与Python3环境差异,详细展示了使用urllib和re模块获取网页源码并提取图片链接的方法。代码包含自动创建目录、遍历保存图片至本地指定路径的完整逻辑,适合Python3初学者参考学习。
本文详解YOLOv3模型在Python环境下的调用方法,重点解决libdarknet.so动态库加载失败问题。通过调整文件路径、使用绝对路径及修改darknet.py文件,实现批量图片的目标检测与结果可视化,包含代码逻辑解析与路径配置建议。
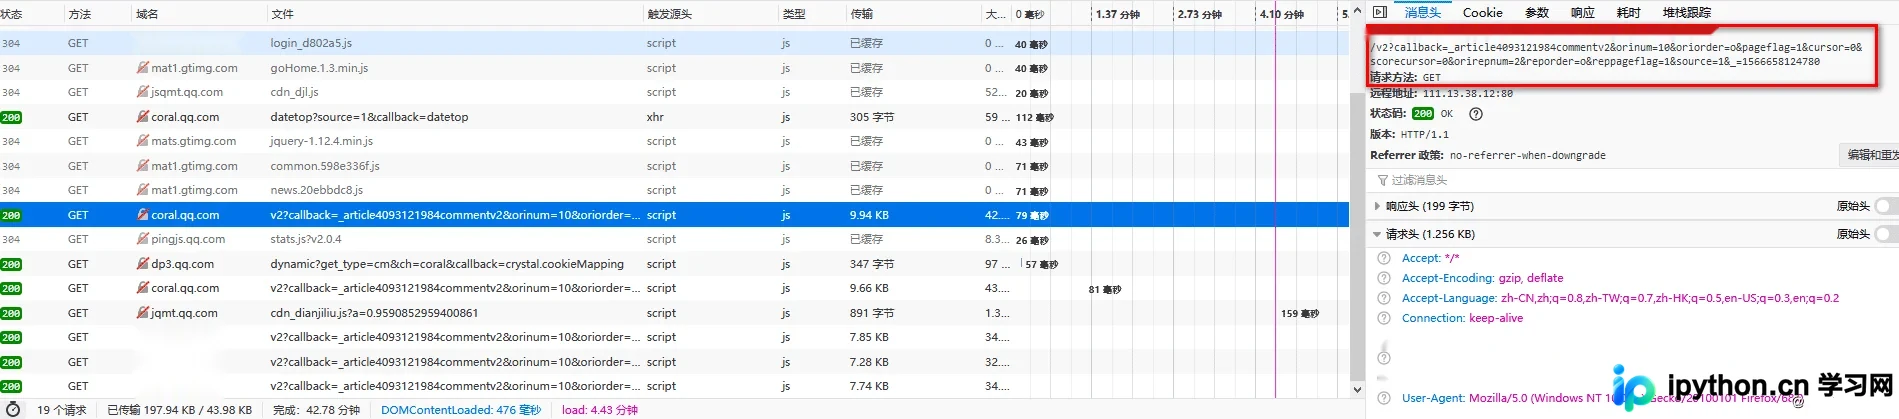
本文解析如何使用Python抓取2019年《中国好声音》第六期在腾讯视频的公开评论数据。通过逆向分析接口参数,实现分页评论、用户昵称及地区信息的自动化采集。随后利用jieba库进行中文分词,结合WordCloud生成主题词云,并通过Matplotlib绘制国内各地区参与用户分布直方图,完整展示从数据抓取到可视化分析的技术流程。
本文提供一段Python代码,用于批量将Excel文件中的多个Sheet页转换为CSV格式。通过xlrd和pandas库,自动处理包含空格字段的复杂表格,并按指定规则清洗数据。该脚本适用于需要高效处理大量Excel数据的场景,避免手工转换的低效与错误。
本文深入解析 Python3 中反射机制的四种基本方法。通过具体代码示例,详细讲解如何利用 getattr 动态获取模块或对象中的方法,使用 hasattr 判断属性或方法是否存在,通过 setattr 动态设置属性,以及利用 delattr 删除指定属性。掌握这四个函数有助于提升代码的灵活性与动态处理能力,适用于需要运行时动态调用或修改对象状态的开发场景。
本文通过两个Python爬虫实例详解XPath技术的应用。案例一演示如何从图片列表页提取内页链接,进而获取百度网盘地址与提取码,涉及函数传参、循环控制及异常跳过逻辑。案例二针对豆瓣读书评论,解析为何直接获取节点无效,并指出使用/text()提取文本内容的正确方法。文章涵盖requests与lxml库的基础用法及常见错误排查。
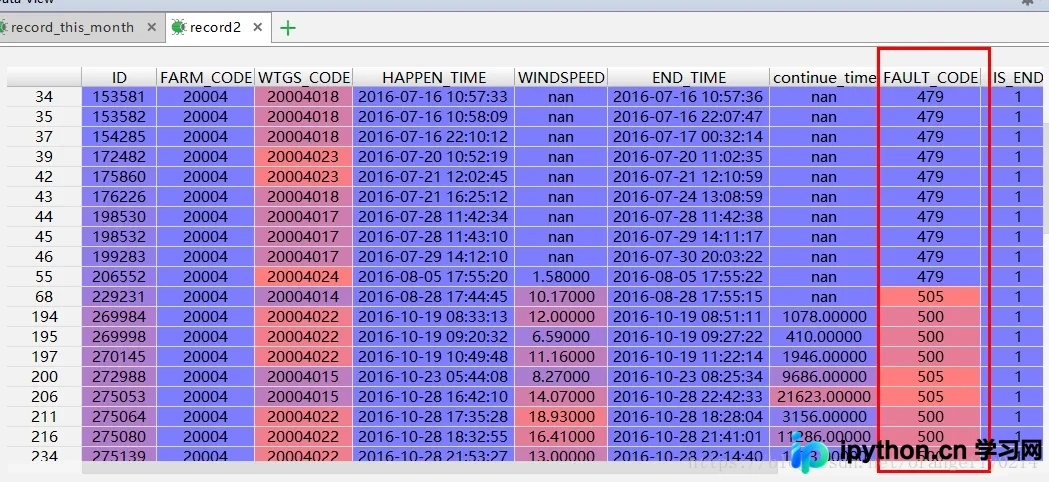
本文详解pandas中利用isin函数进行范围筛选的正确用法,避免使用in导致的逻辑错误。通过WTGS_CODE与FAULT_CODE的组合示例,演示多条件筛选时括号使用的必要性,提供完整代码片段供参考。
本文深入解析Python3中map和filter两个核心高阶函数的用法。map用于对序列元素执行统一转换或计算,filter用于筛选符合条件的元素。两者均可结合lambda匿名函数使用,实现简洁高效的序列处理。文章通过具体代码示例演示了数值转换、字符串映射及条件过滤等常见场景,帮助开发者掌握函数式编程技巧。
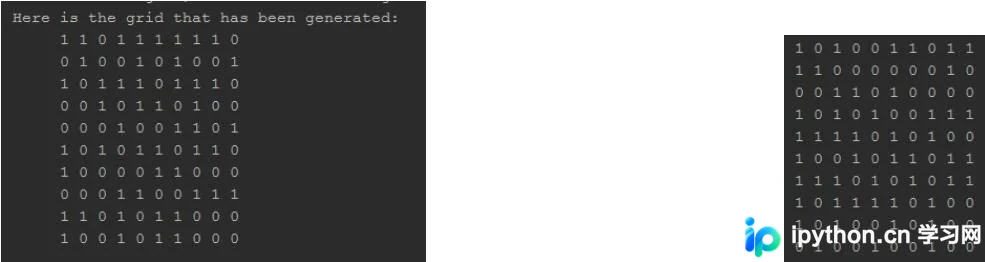
本文介绍Python中二维列表(grid)的两种常见操作:转置与前后反转。通过列表推导式实现行列互换,利用reverse()方法逐行反转元素顺序,提供清晰代码示例供参考。
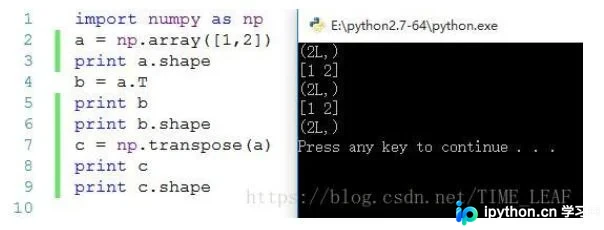
本文探讨在Python中如何实现一维列向量与其转置向量的外积运算。由于Python原生及NumPy的一维数组转置无效,文章提出通过reshape调整维度,将一维向量转换为二维列向量,从而利用广播机制或矩阵乘法完成n*n矩阵的生成。