

Python实现基于生辰八字与五格评分的宝宝起名工具

本文介绍一个使用Python编写的宝宝起名程序,通过爬虫自动提交表单获取指定网站的八字与五格评分。支持自定义家谱限定字、扩充词库,并批量生成带评分的名字列表。程序基于urllib2和BeautifulSoup4实现,提供配置示例与运行结果,旨在为家长提供一份结合传统命理与个性化限制的参考名单。
前言
相信每位家长都有这样的体会:孩子出生后两周内必须办理出生证明,因此起名往往让人措手不及。起初觉得汉字浩如烟海,随便选个字组合即可,但深入思考后才发现并非易事。反复查阅词典、网络搜索、翻阅唐诗宋词、诗经甚至武侠小说,得出的名字常因不顺口或与亲戚重名重音而被家人否决,从而陷入不断寻找又不断被否定的循环,令人焦虑。
于是再次转向网络搜索,发现大量“男宝宝好听名字大全”类文章,一次性列出数百上千个名字,令人眼花缭乱且难以筛选。另有不少测名网站或APP,输入名字后可给出八字或五格评分,看似提供了参考,但实际操作中要么需逐个输入测试,要么库内名字稀少,要么无法满足限定字等特定需求,甚至部分功能收费,最终仍难找到真正好用的工具。
因此,我尝试开发这样一个程序:
- 核心功能是批量生成参考名字,这些名字基于宝宝的生辰八字计算得出;
- 支持用户自行扩充名字库,例如发现一批诗经中的好名字,可直接添加至库中使用;
- 支持限定名字中的特定字,例如家族谱系规定当前辈分为“国”字,则名字中必须包含“国”字;
- 生成的名字列表附带评分,经倒序排列后可从高分到低分逐一查看;
通过这种方式,可获得一份既符合孩子生辰八字、又满足家谱限制及个人喜好的名字列表,且列表已提供评分供参考。以此为基础,可逐一斟酌选出心仪的名字。若产生新想法,可随时将新名字加入词库并重新计算。
程序的代码结构
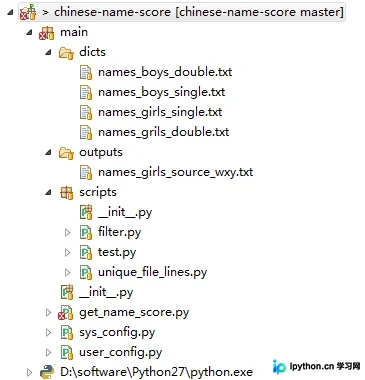
代码介绍:
- /chinese-name-score 代码根目录
- /chinese-name-score/main 代码目录
- /chinese-name-score/main/dicts 词典文件目录
- /chinese-name-score/main/dicts/names_boys_double.txt 词典文件,包含男孩的双字名字
- /chinese-name-score/main/dicts/names_boys_single.txt 词典文件,包含男孩的单字名字
- /chinese-name-score/main/dicts/names_girls_single.txt 词典文件,包含女孩的双字名字
- /chinese-name-score/main/dicts/names_grils_double.txt 词典文件,包含女孩的单字名字
- /chinese-name-score/main/outputs 输出数据目录
- /chinese-name-score/main/outputs/names_girls_source_wxy.txt 输出的示例文件
- /chinese-name-score/main/scripts 用于对词典文件进行预处理的脚本
- /chinese-name-score/main/scripts/unique_file_lines.py 设定词典文件,对词典中的名字进行去重及去除空白行处理
- /chinese-name-score/main/sys_config.py 程序的系统配置文件,包含爬取的目标URL及词典文件路径
- /chinese-name-score/main/user_config.py 程序的用户配置文件,包括宝宝的年月日时分及性别等设定
- /chinese-name-score/main/get_name_score.py 程序的运行入口脚本
使用代码的方法:
- 若未设定限定字,请找到词典文件names_boys_double.txt和names_grils_double.txt,在此处添加自行收集的名字列表,按行分割后追加至文件末尾即可;
- 若设定了限定字,请找到词典文件names_boys_single.txt和names_girls_single.txt,在此处添加预先筛选好的单个字列表,按行分割后追加至文件末尾即可;
- 打开user_config.py进行配置,具体配置项见下一节;
- 运行脚本get_name_score.py
- 在outputs目录中查看生成的产出文件,可复制到Excel中进行排序等操作;
程序的配置入口
程序的配置如下:
# coding:GB18030

"""
在这里写好配置
"""

setting = {}

# 限定字,如果配置了该值,则会取用单字字典,否则取用多字字典
setting["limit_world"] = "国"
# 姓
setting["name_prefix"] = "李"
# 性别,取值为 男 或者 女
setting["sex"] = "男"
# 省份
setting["area_province"] = "北京"
# 城市
setting["area_region"] = "海淀"
# 出生的公历年份
setting['year'] = "2017"
# 出生的公历月份
setting['month'] = "1"
# 出生的公历日子
setting['day'] = "11"
# 出生的公历小时
setting['hour'] = "11"
# 出生的公历分钟
setting['minute'] = "11"
# 结果产出文件名称
setting['output_fname'] = "names_girls_source_xxx.txt"
根据配置项setting[“limit_world”] ,系统自动决定选用单字词典还是多字词典:
- 若设置了该项,例如值为“国”,程序将组合所有单字生成名字进行计算,如“国浩”和“浩国”两个名字均会被计算;
- 若不设置该项,保持空字符串,则程序仅读取*_double.txt的双字词典
程序的原理
这是一个简单的爬虫程序。大家可以访问http://life.httpcn.com/xingming.asp网站查看,该网站提供一个POST表单,填写所需参数并提交后,会打开一个结果页面,页面底部包含八字分数和五格分数。
若要获取分数,需完成两件事:一是通过爬虫自动提交表单以获取结果页面;二是从结果页面中提取分数;
对于第一件事情,实现较为简单,使用urllib2即可(代码位于/chinese-name-score/main/get_name_score.py):
 post_data = urllib.urlencode(params)
 req = urllib2.urlopen(sys_config.REQUEST_URL, post_data)
 content = req.read()
这里的params是一个参数字典,通过这种方式实现了带数据的POST提交,随后从content中获取结果数据。
params的参数设定如下:
 params = {}

 # 日期类型,0表示公历,1表示农历
 params['data_type'] = "0"
 params['year'] = "%s" % str(user_config.setting["year"])
 params['month'] = "%s" % str(user_config.setting["month"])
 params['day'] = "%s" % str(user_config.setting["day"])
 params['hour'] = "%s" % str(user_config.setting["hour"])
 params['minute'] = "%s" % str(user_config.setting["minute"])
 params['pid'] = "%s" % str(user_config.setting["area_province"])
 params['cid'] = "%s" % str(user_config.setting["area_region"])
 # 喜用五行,0表示自动分析,1表示自定喜用神
 params['wxxy'] = "0"
 params['xing'] = "%s" % (user_config.setting["name_prefix"])
 params['ming'] = name_postfix
 # 表示女,1表示男
 if user_config.setting["sex"] == "男":
  params['sex'] = "1"
 else:
  params['sex'] = "0"

 params['act'] = "submit"
 params['isbz'] = "1"
第二件事情,即从网页中提取所需分数,我们可以使用BeautifulSoup4来实现,其语法同样简单:
 soup = BeautifulSoup(content, 'html.parser', from_encoding="GB18030")
 full_name = get_full_name(name_postfix)

 # print soup.find(string=re.compile(u"姓名五格评分"))
 for node in soup.find_all("div", class_="chaxun_b"):
  node_cont = node.get_text()
  if u'姓名五格评分' in node_cont:
   name_wuge = node.find(string=re.compile(u"姓名五格评分"))
   result_data['wuge_score'] = name_wuge.next_sibling.b.get_text()

  if u'姓名八字评分' in node_cont:
   name_wuge = node.find(string=re.compile(u"姓名八字评分"))
   result_data['bazi_score'] = name_wuge.next_sibling.b.get_text()
通过该方法,即可对HTML进行解析,提取八字和五格的分数。
运行结果事例
1/1287 李国锦 姓名八字评分=61.5 姓名五格评分=78.6 总分=140.1
2/1287 李国铁 姓名八字评分=61 姓名五格评分=89.7 总分=150.7
3/1287 李国晶 姓名八字评分=21 姓名五格评分=81.6 总分=102.6
4/1287 李鸣国 姓名八字评分=21 姓名五格评分=90.3 总分=111.3
5/1287 李柔国 姓名八字评分=64 姓名五格评分=78.3 总分=142.3
6/1287 李国经 姓名八字评分=21 姓名五格评分=89.8 总分=110.8
7/1287 李国蒂 姓名八字评分=22 姓名五格评分=87.2 总分=109.2
8/1287 李国登 姓名八字评分=21 姓名五格评分=81.6 总分=102.6
9/1287 李略国 姓名八字评分=21 姓名五格评分=83.7 总分=104.7
10/1287 李国添 姓名八字评分=21 姓名五格评分=81.6 总分=102.6
11/1287 李国天 姓名八字评分=22 姓名五格评分=83.7 总分=105.7
12/1287 李国田 姓名八字评分=22 姓名五格评分=93.7 总分=115.7
获得这些分数后,即可进行排序,这是一份非常实用的参考资料。
友情提示
- 分数受多种因素影响,如出生时刻、已限定的字、限定字的笔画等,这些条件导致部分名字分数不高,无需因此受挫,找出相对高分的名字即可;
- 目前程序仅能抓取一个网站的内容,地址为http://life.httpcn.com/xingming.asp
- 本列表仅供参考,查阅部分文章可知,历史上许多名人伟人的姓名八字评分虽低,却建功立业,名字确实有一定影响,但朗朗上口往往才是关键;
- 从本列表选取名字后,建议在百度、人人网等平台查询,以防与有负面新闻的人重名,或避免名字过于普遍而“烂大街”;
- 八字分数是中国传统概念,五格分数则是日本近代发明,有时也可尝试西方星座起名法。有趣的是,不同网站对八字和五格的打分差异巨大,这更说明了该工具仅供娱乐参考;
本文的代码已上传至github
总结
以上就是这篇文章的全部内容,希望本文的内容对大家学习或使用Python能带来一定的帮助,如果有疑问大家可以留言交流,谢谢大家对本站的支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









