

Python爬取微信公众号文章与评论实战:基于Fiddler抓包分析

本文详细介绍如何使用Python结合Fiddler抓包工具,突破微信公众号的反爬限制,实现文章列表与评论数据的抓取。通过解析getmsg与getcomment接口参数,如__biz、pass_ticket及appmsg_token,并配合PostgreSQL数据库存储,提供完整的代码实现与数据库建表语句,帮助开发者掌握微信内容抓取的核心技术。
背景说明
背景说明
开发环境
微信公众号常被视为内容抓取难度较高的平台,但经过深入调试后仍可获得有效数据。本文未采用Scrapy框架(因高频请求易触发反爬机制),后续将整理更多实战案例。开发环境主要包含以下组件:
- Python 3
- requests库
- psycopg2(用于操作PostgreSQL数据库)
抓包分析
抓包分析
Fiddler配置
本次抓取不限定特定公众号,但每个公众号需单独进行接口分析。启动Fiddler后配置手机代理,为减少干扰,在Fiddler中设置Filter规则,仅监控微信域名mp.weixin.qq.com的流量:
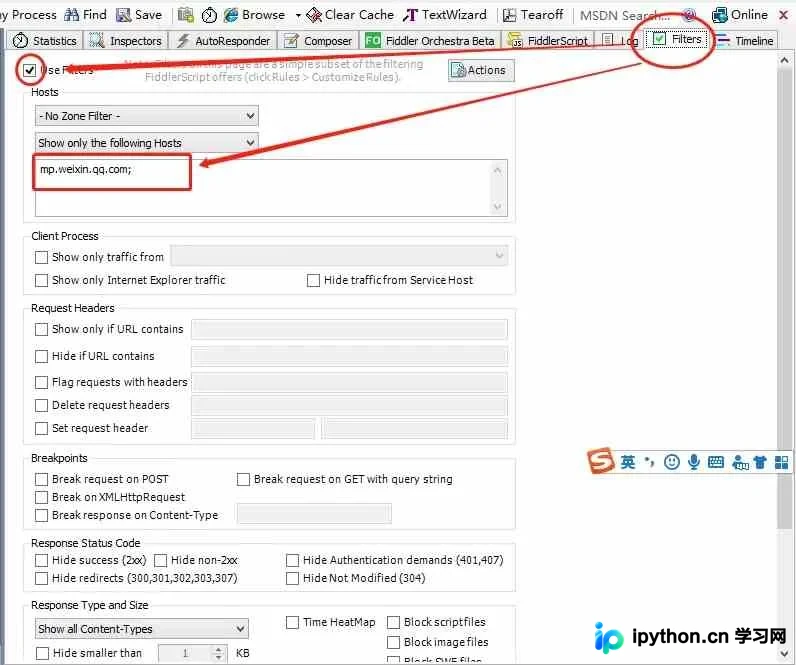
Fiddler配置Filter规则
公众号示例
以关注的“36氪”公众号为例,继续后续步骤:
“36氪”公众号
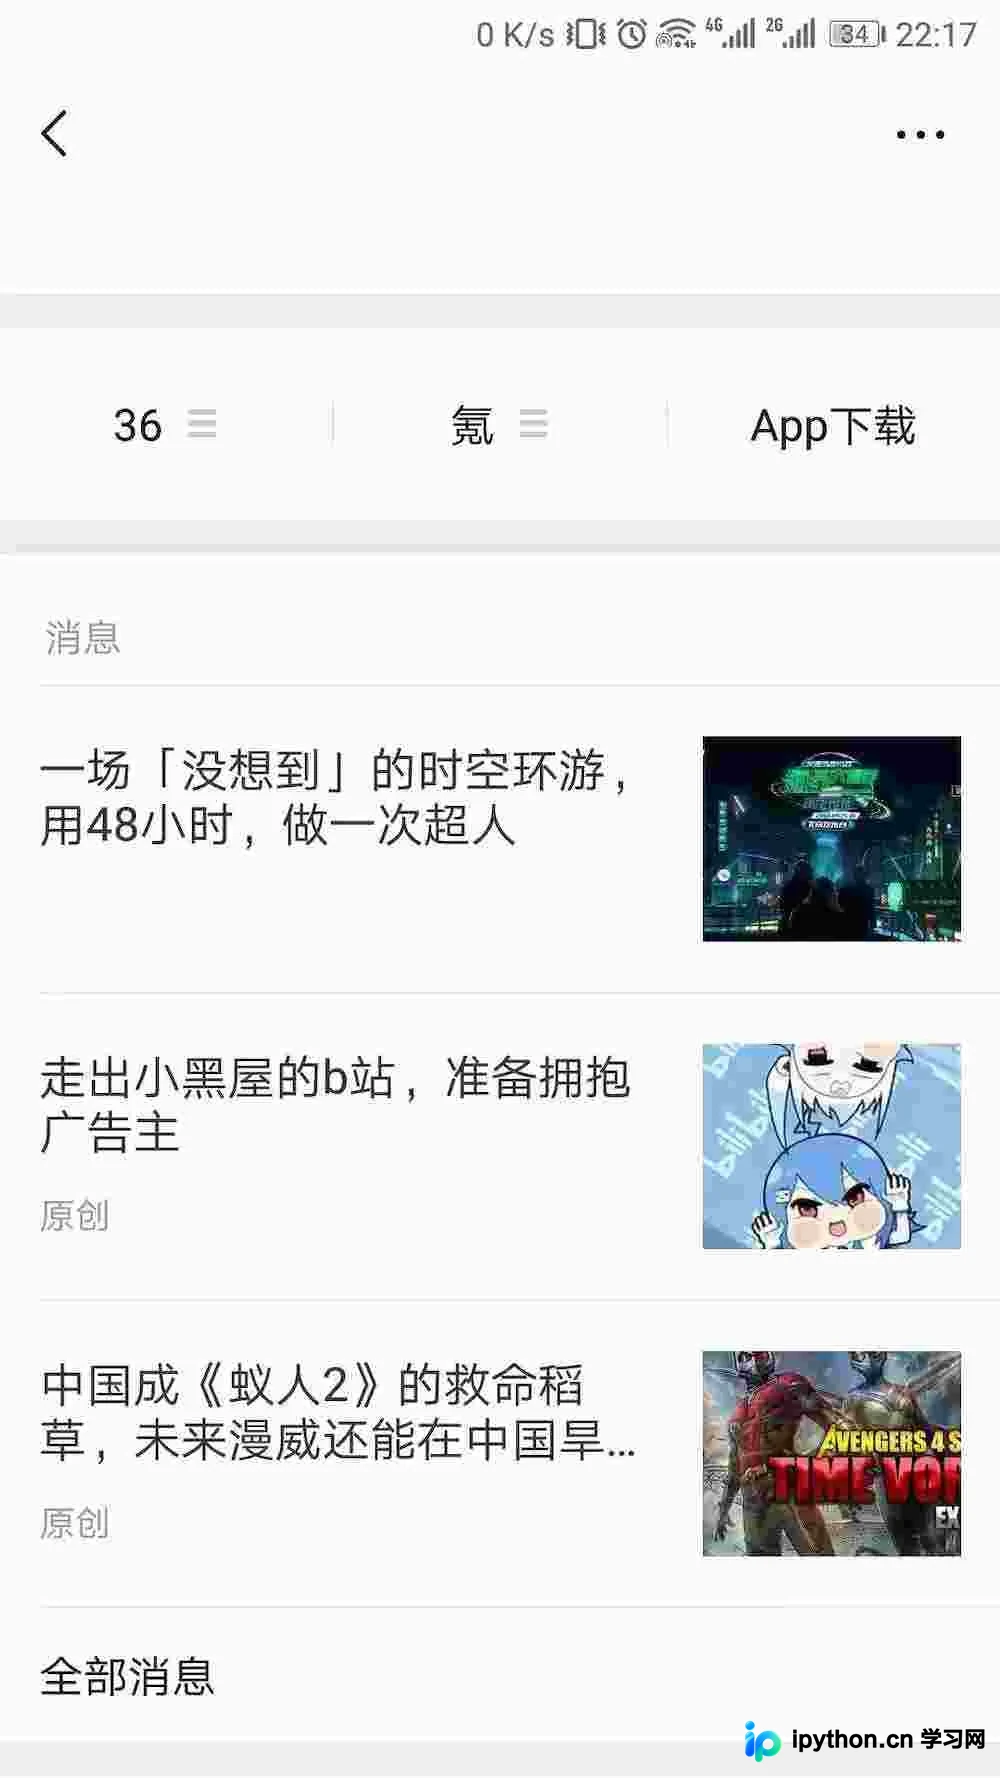
获取文章列表
进入公众号主页右上角,点击“全部消息”
在公众号主页点击右上角三个实心圆点进入消息界面,下滑找到并点击“全部消息”。向下滚动加载几次历史文章后,返回Fiddler界面。正常情况下,可观察到多次请求,返回数据为JSON格式,文章列表数据封装在general_msg_list字段中:
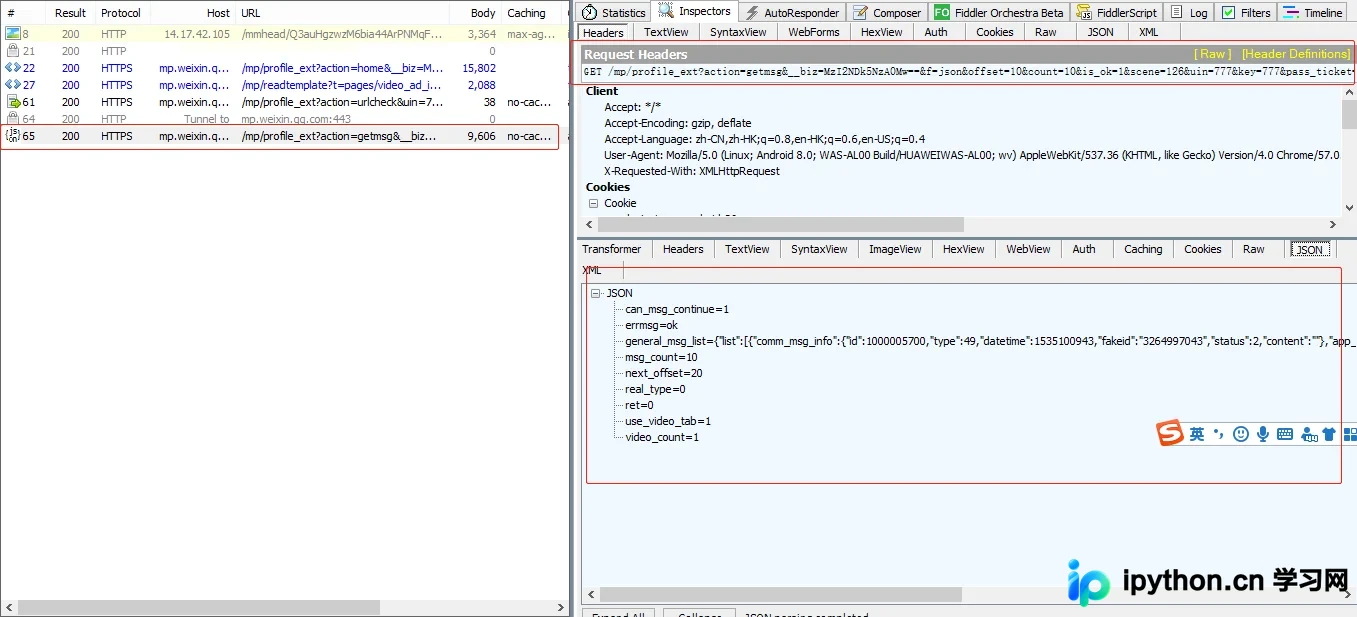
公众号文章列表抓包请求
分析文章列表接口
分析文章列表接口
参数说明
将请求URL与Cookie粘贴至文本编辑器进行分析:
https://mp.weixin.qq.com/mp/profile_ext?action=getmsg&__biz=MzI2NDk5NzA0Mw==&f=json&offset=10&count=10&is_ok=1&scene=126&uin=777&key=777&pass_ticket=QhOypNwH5dAr5w6UgMjyBrTSOdMEUT86vWc73GANoziWFl8xJd1hIMbMZ82KgCpN&wxtoken=&appmsg_token=971_LwY7Z%252BFBoaEv5z8k_dFWfJkdySbNkMR4OmFxNw~~&x5=1&f=json
Cookie: pgv_pvid=2027337976; pgv_info=ssid=s3015512850; rewardsn=; wxtokenkey=777; wxuin=2089823341; devicetype=android-26; version=26070237; lang=zh_CN;pass_ticket=NDndxxaZ7p6Z9PYulWpLqMbI0i3ULFeCPIHBFu1sf5pX2IhkGfyxZ6b9JieSYRUy;wap_sid2=CO3YwOQHEogBQnN4VTNhNmxQWmc3UHI2U3kteWhUeVExZHFVMnN0QXlsbzVJRUJKc1pkdVFUU2Y5UzhSVEtOZmt1VVlYTkR4SEllQ2huejlTTThJWndMQzZfYUw2SldLVGVMQUthUjc3QWdVMUdoaGN0Nml2SU05cXR1dTN2RkhRUVd1V2Y3SFJ5d01BQUF+fjCB1pLcBTgNQJVO
以下说明关键参数,未提及的参数相对次要:
- __biz:当前公众号的唯一固定标识ID
- offset:文章数据接口的请求偏移量(从0开始)。每次返回的JSON数据中包含下一次请求的offset值,注意该值并非按固定规则递增
- count:每次请求的数据量(实测最大值为10)
- pass_ticket:请求票据,具有时效性(约几小时过期),这也是微信难以按固定规则抓取的原因
- appmsg_token:同样为非固定且有过期策略的票据
- Cookie:使用时可整段粘贴,但最少需包含wap_sid2部分
数据表设计
若感觉流程繁琐,考虑到并非构建大规模专业爬虫,针对单个公众号分析后仍可继续。以下截取一段JSON数据,用于设计文章数据表:
{
"ret": 0,
"errmsg": "ok",
"msg_count": 10,
"can_msg_continue": 1,
"general_msg_list": "{\"list\":[{\"comm_msg_info\":{\"id\":1000005700,\"type\":49,\"datetime\":1535100943,\"fakeid\":\"3264997043\",\"status\":2,\"content\":\"\"},\"app_msg_ext_info\":{\"title\":\"金融危机又十年:钱荒之下,二手基金迎来高光时刻\",\"digest\":\"退出永远是基金的主旋律。\",\"content\":\"\",\"fileid\":100034824,\"content_url\":\"http:\\/\\/mp.weixin.qq.com\\/s?__biz=MzI2NDk5NzA0Mw==&mid=2247518479&idx=1&sn=124ab52f7478c1069a6b4592cdf3c5f5&chksm=eaa6d8d3ddd151c5bb95a7ae118de6d080023246aa0a419e1d53bfe48a8d9a77e52b752d9b80&scene=27#wechat_redirect\",\"source_url\":\"\",\"cover\":\"http:\\/\\/mmbiz.qpic.cn\\/mmbiz_jpg\\/QicyPhNHD5vYgdpprkibtnWCAN7l4ZaqibKvopNyCWWLQAwX7QpzWicnQSVfcBZmPrR5YuHS45JIUzVjb0dZTiaLPyA\\/0?wx_fmt=jpeg\",\"subtype\":9,\"is_multi\":0,\"multi_app_msg_item_list\":[],\"author\":\"石亚琼\",\"copyright_stat\":11,\"duration\":0,\"del_flag\":1,\"item_show_type\":0,\"audio_fileid\":0,\"play_url\":\"\",\"malicious_title_reason_id\":0,\"malicious_content_type\":0}}]}",
"next_offset": 20,
"video_count": 1,
"use_video_tab": 1,
"real_type": 0
}
文章表结构
可简单抽取所需数据,此处定义文章表结构,并附上建表SQL语句:
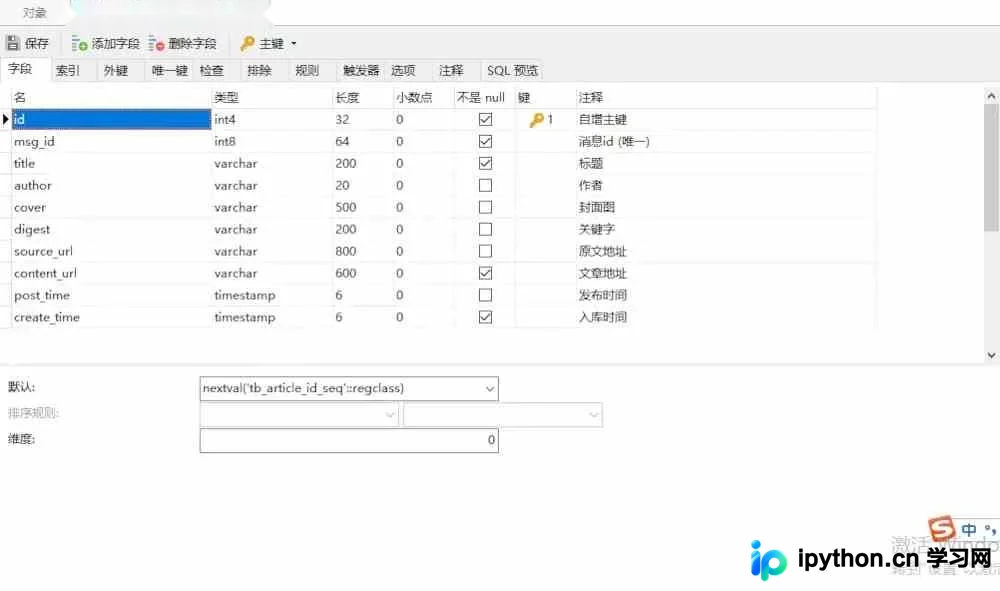
文章数据表
-- ----------------------------
-- Table structure for tb_article
-- ----------------------------
DROP TABLE IF EXISTS "public"."tb_article";
CREATE TABLE "public"."tb_article" (
"id" serial4 PRIMARY KEY,
"msg_id" int8 NOT NULL,
"title" varchar(200) COLLATE "pg_catalog"."default" NOT NULL,
"author" varchar(20) COLLATE "pg_catalog"."default",
"cover" varchar(500) COLLATE "pg_catalog"."default",
"digest" varchar(200) COLLATE "pg_catalog"."default",
"source_url" varchar(800) COLLATE "pg_catalog"."default",
"content_url" varchar(600) COLLATE "pg_catalog"."default" NOT NULL,
"post_time" timestamp(6),
"create_time" timestamp(6) NOT NULL
)
;
COMMENT ON COLUMN "public"."tb_article"."id" IS '自增主键';
COMMENT ON COLUMN "public"."tb_article"."msg_id" IS '消息id (唯一)';
COMMENT ON COLUMN "public"."tb_article"."title" IS '标题';
COMMENT ON COLUMN "public"."tb_article"."author" IS '作者';
COMMENT ON COLUMN "public"."tb_article"."cover" IS '封面图';
COMMENT ON COLUMN "public"."tb_article"."digest" IS '关键字';
COMMENT ON COLUMN "public"."tb_article"."source_url" IS '原文地址';
COMMENT ON COLUMN "public"."tb_article"."content_url" IS '文章地址';
COMMENT ON COLUMN "public"."tb_article"."post_time" IS '发布时间';
COMMENT ON COLUMN "public"."tb_article"."create_time" IS '入库时间';
COMMENT ON TABLE "public"."tb_article" IS '公众号文章表';
-- ----------------------------
-- Indexes structure for table tb_article
-- ----------------------------
CREATE UNIQUE INDEX "unique_msg_id" ON "public"."tb_article" USING btree (
"msg_id" "pg_catalog"."int8_ops" ASC NULLS LAST
);
文章抓取代码
附上请求文章接口并解析数据保存到数据库的相关代码:
class WxMps(object):
"""微信公众号文章、评论抓取爬虫"""

def __init__(self, _biz, _pass_ticket, _app_msg_token, _cookie, _offset=0):
self.offset = _offset
self.biz = _biz # 公众号标志
self.msg_token = _app_msg_token # 票据(非固定)
self.pass_ticket = _pass_ticket # 票据(非固定)
self.headers = {
'Cookie': _cookie, # Cookie(非固定)
'User-Agent': 'Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko) Version/4.0 Chrome/57.0.2987.132 '
}
wx_mps = 'wxmps' # 这里数据库、用户、密码一致(需替换成实际的)
self.postgres = pgs.Pgs(host='localhost', port='5432', db_name=wx_mps, user=wx_mps, password=wx_mps)

def start(self):
"""请求获取公众号的文章接口"""

offset = self.offset
while True:
api = 'https://mp.weixin.qq.com/mp/profile_ext?action=getmsg&__biz={0}&f=json&offset={1}' \
'&count=10&is_ok=1&scene=124&uin=777&key=777&pass_ticket={2}&wxtoken=&appmsg_token' \
'={3}&x5=1&f=json'.format(self.biz, offset, self.pass_ticket, self.msg_token)

resp = requests.get(api, headers=self.headers).json()
ret, status = resp.get('ret'), resp.get('errmsg') # 状态信息
if ret == 0 or status == 'ok':
print('Crawl article: ' + api)
offset = resp['next_offset'] # 下一次请求偏移量
general_msg_list = resp['general_msg_list']
msg_list = json.loads(general_msg_list)['list'] # 获取文章列表
for msg in msg_list:
comm_msg_info = msg['comm_msg_info'] # 该数据是本次推送多篇文章公共的
msg_id = comm_msg_info['id'] # 文章id
post_time = datetime.fromtimestamp(comm_msg_info['datetime']) # 发布时间
# msg_type = comm_msg_info['type'] # 文章类型
# msg_data = json.dumps(comm_msg_info, ensure_ascii=False) # msg原数据
app_msg_ext_info = msg.get('app_msg_ext_info') # article原数据
if app_msg_ext_info:
# 本次推送的首条文章
self._parse_articles(app_msg_ext_info, msg_id, post_time)
# 本次推送的其余文章
multi_app_msg_item_list = app_msg_ext_info.get('multi_app_msg_item_list')
if multi_app_msg_item_list:
for item in multi_app_msg_item_list:
msg_id = item['fileid'] # 文章id
if msg_id == 0:
msg_id = int(time.time() * 1000) # 设置唯一id,解决部分文章id=0出现唯一索引冲突的情况
self._parse_articles(item, msg_id, post_time)
print('next offset is %d' % offset)
else:
print('Before break , Current offset is %d' % offset)
break
def _parse_articles(self, info, msg_id, post_time):
"""解析嵌套文章数据并保存入库"""
title = info.get('title') # 标题
cover = info.get('cover') # 封面图
author = info.get('author') # 作者
digest = info.get('digest') # 关键字
source_url = info.get('source_url') # 原文地址
content_url = info.get('content_url') # 微信地址
# ext_data = json.dumps(info, ensure_ascii=False) # 原始数据
self.postgres.handler(self._save_article(), (msg_id, title, author, cover, digest,
source_url, content_url, post_time,
datetime.now()), fetch=True)
@staticmethod
def _save_article():
sql = 'insert into tb_article(msg_id,title,author,cover,digest,source_url,content_url,post_time,create_time) ' \
'values(%s,%s,%s,%s,%s,%s,%s,%s,%s)'
return sql
if __name__ == '__main__':
biz = 'MzI2NDk5NzA0Mw==' # "36氪"
pass_ticket = 'NDndxxaZ7p6Z9PYulWpLqMbI0i3ULFeCPIHBFu1sf5pX2IhkGfyxZ6b9JieSYRUy'
app_msg_token = '971_Z0lVNQBcGsWColSubRO9H13ZjrPhjuljyxLtiQ~~'
cookie = 'wap_sid2=CO3YwOQHEogBQnN4VTNhNmxQWmc3UHI2U3kteWhUeVExZHFVMnN0QXlsbzVJRUJKc1pkdVFUU2Y5UzhSVEtOZmt1VVlYTkR4SEllQ2huejlTTThJWndMQzZfYUw2SldLVGVMQUthUjc3QWdVMUdoaGN0Nml2SU05cXR1dTN2RkhRUVd1V2Y3SFJ5d01BQUF+fjCB1pLcBTgNQJVO'
# 以上信息不同公众号每次抓取都需要借助抓包工具做修改
wxMps = WxMps(biz, pass_ticket, app_msg_token, cookie)
wxMps.start() # 开始爬取文章
分析文章评论接口
分析文章评论接口
获取评论请求
获取评论的思路类似,但更为复杂。首先在手机端打开一篇有评论的文章,查看Fiddler抓取的请求:
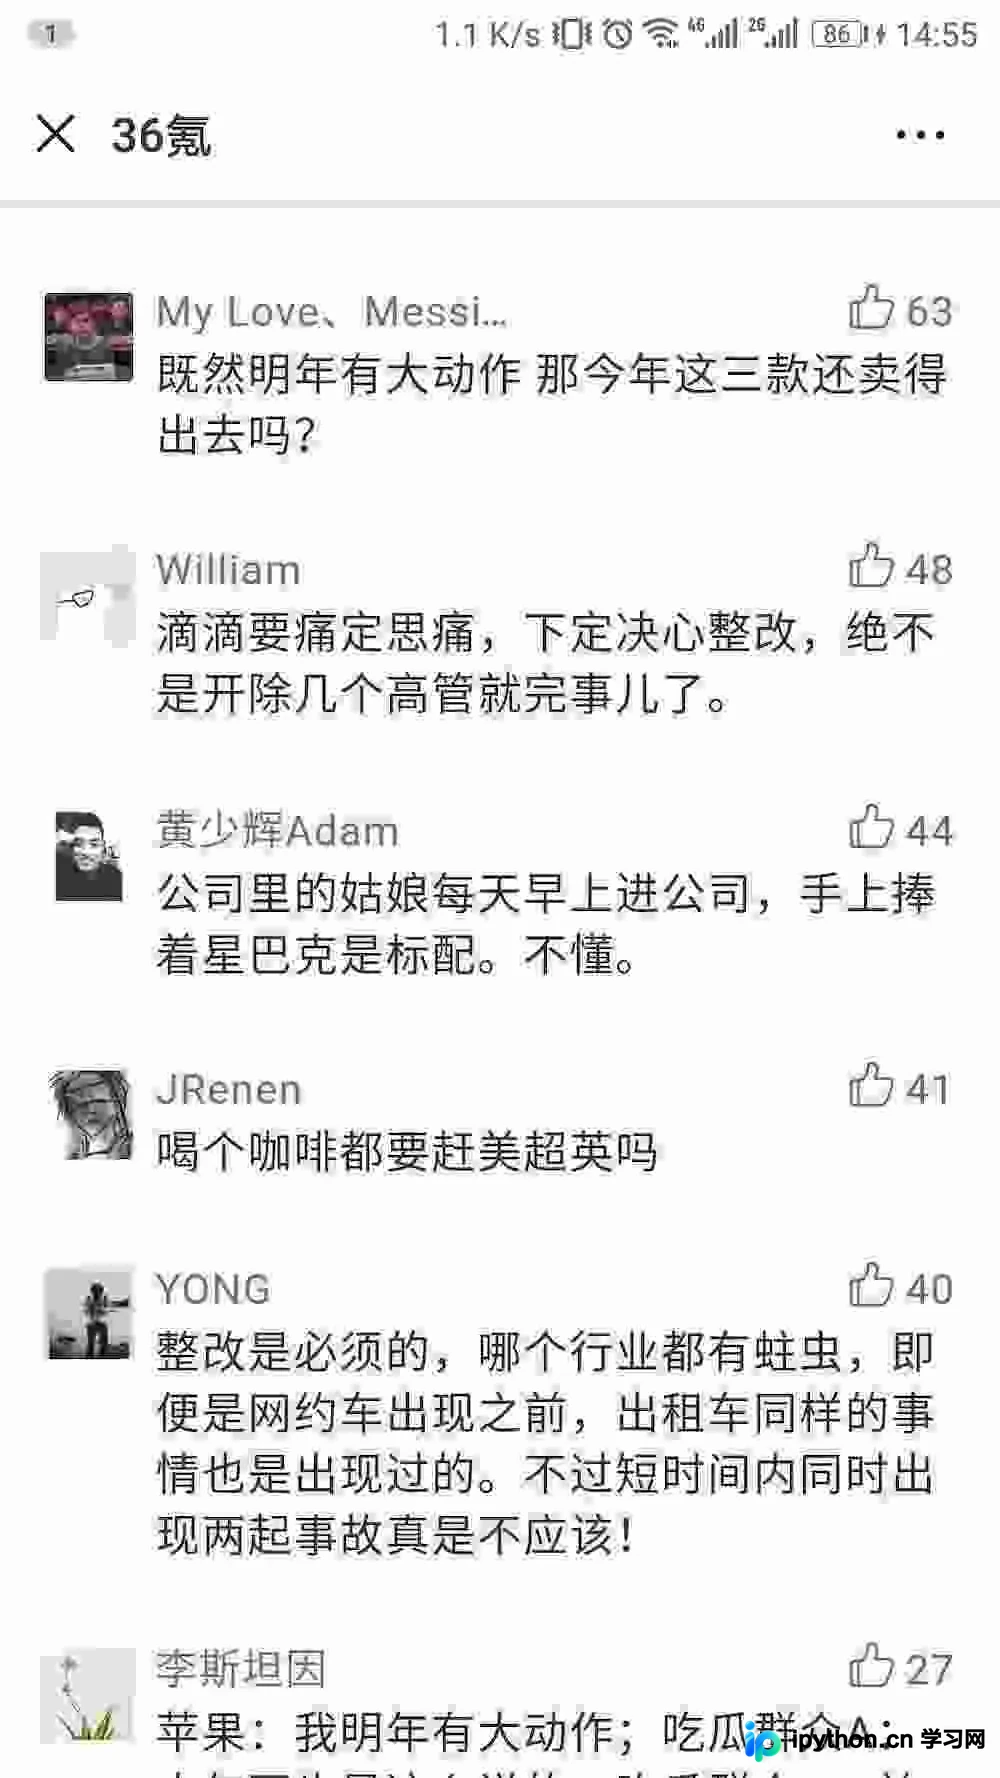
公众号文章评论
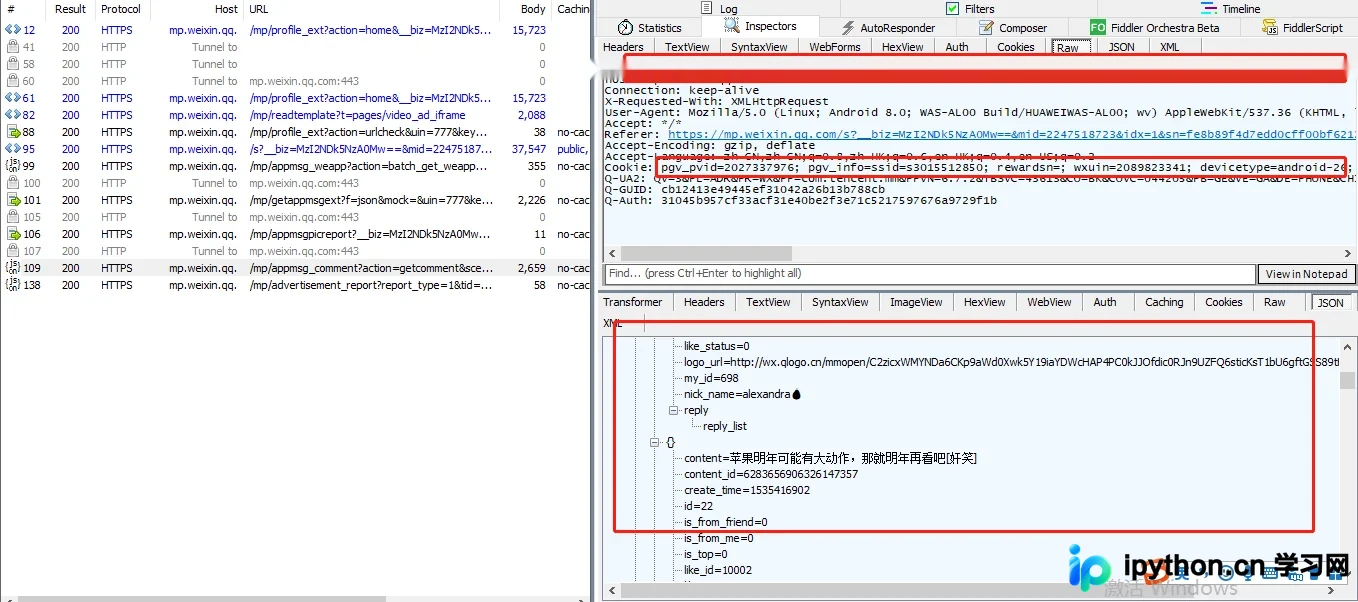
公众号文章评论接口抓包请求
评论接口参数
提取其中的URL和Cookie再次分析:
https://mp.weixin.qq.com/mp/appmsg_comment?action=getcomment&scene=0&__biz=MzI2NDk5NzA0Mw==&appmsgid=2247518723&idx=1&comment_id=433253969406607362&offset=0&limit=100&uin=777&key=777&pass_ticket=NDndxxaZ7p6Z9PYulWpLqMbI0i3ULFeCPIHBFu1sf5pX2IhkGfyxZ6b9JieSYRUy&wxtoken=777&devicetype=android-26&clientversion=26070237&appmsg_token=971_dLK7htA1j8LbMUk8pvJKRlC_o218HEgwDbS9uARPOyQ34_vfXv3iDstqYnq2gAyze1dBKm4ZMTlKeyfx&x5=1&f=json
Cookie: pgv_pvid=2027337976; pgv_info=ssid=s3015512850; rewardsn=; wxuin=2089823341; devicetype=android-26; version=26070237; lang=zh_CN; pass_ticket=NDndxxaZ7p6Z9PYulWpLqMbI0i3ULFeCPIHBFu1sf5pX2IhkGfyxZ6b9JieSYRUy; wap_sid2=CO3YwOQHEogBdENPSVdaS3pHOWc1V2QzY1NvZG9PYk1DMndPS3NfbGlHM0Vfal8zLU9kcUdkWTQxdUYwckFBT3RZM1VYUXFaWkFad3NVaWFXZ28zbEFIQ2pTa1lqZktfb01vcGdPLTQ0aGdJQ2xOSXoxTVFvNUg3SVpBMV9GRU1lbnotci1MWWl5d01BQUF+fjCj45PcBTgNQAE=; wxtokenkey=777
接着分析参数:
- __biz:同上
- pass_ticket:同上
- Cookie:同上
- offset和limit:分别代表偏移量和请求数量。由于公众号评论最多展示100条,这两个参数无需调整
- comment_id:获取文章评论数据的标记ID,固定但需从当前文章结构(HTML)解析提取
- appmsgid:票据ID,非固定,每次需从当前文章结构(HTML)解析提取
- appmsg_token:票据Token,非固定,每次需从当前文章结构(HTML)解析提取
HTML解析与URL处理
最后三个参数需解析HTML获取(此前花费较长时间才想到查看文章网页结构)。从文章请求接口可获得文章地址,对应上述content_url字段,但请求该地址前仍需对URL做相关处理,否则上述三个参数会缺失,导致无法获取评论内容:
def _parse_article_detail(self, content_url, article_id):
"""从文章页提取相关参数用于获取评论,article_id是已保存的文章id"""
try:
api = content_url.replace('amp;', '').replace('#wechat_redirect', '').replace('http', 'https')
html = requests.get(api, headers=self.headers).text
except:
print('获取评论失败' + content_url)
else:
# group(0) is current line
str_comment = re.search(r'var comment_id = "(.*)" \|\| "(.*)" \* 1;', html)
str_msg = re.search(r"var appmsgid = '' \|\| '(.*)'\|\|", html)
str_token = re.search(r'window.appmsg_token = "(.*)";', html)
if str_comment and str_msg and str_token:
comment_id = str_comment.group(1) # 评论id(固定)
app_msg_id = str_msg.group(1) # 票据id(非固定)
appmsg_token = str_token.group(1) # 票据token(非固定)
评论数据表设计
再回看该接口返回的JSON数据,分析结构后定义数据表(含SQL):
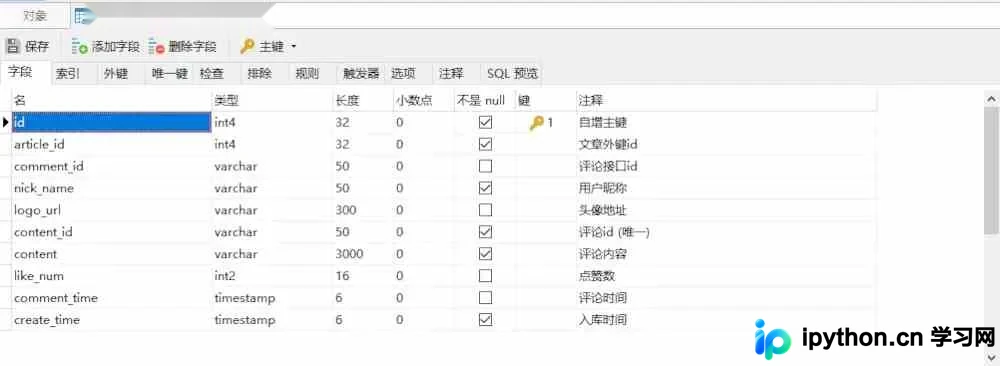
评论表结构
文章评论数据表
-- ----------------------------
-- Table structure for tb_article_comment
-- ----------------------------
DROP TABLE IF EXISTS "public"."tb_article_comment";
CREATE TABLE "public"."tb_article_comment" (
"id" serial4 PRIMARY KEY,
"article_id" int4 NOT NULL,
"comment_id" varchar(50) COLLATE "pg_catalog"."default",
"nick_name" varchar(50) COLLATE "pg_catalog"."default" NOT NULL,
"logo_url" varchar(300) COLLATE "pg_catalog"."default",
"content_id" varchar(50) COLLATE "pg_catalog"."default" NOT NULL,
"content" varchar(3000) COLLATE "pg_catalog"."default" NOT NULL,
"like_num" int2,
"comment_time" timestamp(6),
"create_time" timestamp(6) NOT NULL
)
;
COMMENT ON COLUMN "public"."tb_article_comment"."id" IS '自增主键';
COMMENT ON COLUMN "public"."tb_article_comment"."article_id" IS '文章外键id';
COMMENT ON COLUMN "public"."tb_article_comment"."comment_id" IS '评论接口id';
COMMENT ON COLUMN "public"."tb_article_comment"."nick_name" IS '用户昵称';
COMMENT ON COLUMN "public"."tb_article_comment"."logo_url" IS '头像地址';
COMMENT ON COLUMN "public"."tb_article_comment"."content_id" IS '评论id (唯一)';
COMMENT ON COLUMN "public"."tb_article_comment"."content" IS '评论内容';
COMMENT ON COLUMN "public"."tb_article_comment"."like_num" IS '点赞数';
COMMENT ON COLUMN "public"."tb_article_comment"."comment_time" IS '评论时间';
COMMENT ON COLUMN "public"."tb_article_comment"."create_time" IS '入库时间';
COMMENT ON TABLE "public"."tb_article_comment" IS '公众号文章评论表';
-- ----------------------------
-- Indexes structure for table tb_article_comment
-- ----------------------------
CREATE UNIQUE INDEX "unique_content_id" ON "public"."tb_article_comment" USING btree (
"content_id" COLLATE "pg_catalog"."default" "pg_catalog"."text_ops" ASC NULLS LAST
);
评论抓取代码
接近完成,最后附上这部分代码。由于需先获取文章地址,因此与上文获取文章数据的代码合并在一起:
import json
import re
import time
from datetime import datetime

import requests

from utils import pgs


class WxMps(object):
"""微信公众号文章、评论抓取爬虫"""

def __init__(self, _biz, _pass_ticket, _app_msg_token, _cookie, _offset=0):
self.offset = _offset
self.biz = _biz # 公众号标志
self.msg_token = _app_msg_token # 票据(非固定)
self.pass_ticket = _pass_ticket # 票据(非固定)
self.headers = {
'Cookie': _cookie, # Cookie(非固定)
'User-Agent': 'Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko) Version/4.0 Chrome/57.0.2987.132 '
}
wx_mps = 'wxmps' # 这里数据库、用户、密码一致(需替换成实际的)
self.postgres = pgs.Pgs(host='localhost', port='5432', db_name=wx_mps, user=wx_mps, password=wx_mps)

def start(self):
"""请求获取公众号的文章接口"""

offset = self.offset
while True:
api = 'https://mp.weixin.qq.com/mp/profile_ext?action=getmsg&__biz={0}&f=json&offset={1}' \
'&count=10&is_ok=1&scene=124&uin=777&key=777&pass_ticket={2}&wxtoken=&appmsg_token' \
'={3}&x5=1&f=json'.format(self.biz, offset, self.pass_ticket, self.msg_token)

resp = requests.get(api, headers=self.headers).json()
ret, status = resp.get('ret'), resp.get('errmsg') # 状态信息
if ret == 0 or status == 'ok':
print('Crawl article: ' + api)
offset = resp['next_offset'] # 下一次请求偏移量
general_msg_list = resp['general_msg_list']
msg_list = json.loads(general_msg_list)['list'] # 获取文章列表
for msg in msg_list:
comm_msg_info = msg['comm_msg_info'] # 该数据是本次推送多篇文章公共的
msg_id = comm_msg_info['id'] # 文章id
post_time = datetime.fromtimestamp(comm_msg_info['datetime']) # 发布时间
# msg_type = comm_msg_info['type'] # 文章类型
# msg_data = json.dumps(comm_msg_info, ensure_ascii=False) # msg原数据

app_msg_ext_info = msg.get('app_msg_ext_info') # article原数据
if app_msg_ext_info:
# 本次推送的首条文章
self._parse_articles(app_msg_ext_info, msg_id, post_time)
# 本次推送的其余文章
multi_app_msg_item_list = app_msg_ext_info.get('multi_app_msg_item_list')
if multi_app_msg_item_list:
for item in multi_app_msg_item_list:
msg_id = item['fileid'] # 文章id
if msg_id == 0:
msg_id = int(time.time() * 1000) # 设置唯一id,解决部分文章id=0出现唯一索引冲突的情况
self._parse_articles(item, msg_id, post_time)
print('next offset is %d' % offset)
else:
print('Before break , Current offset is %d' % offset)
break

def _parse_articles(self, info, msg_id, post_time):
"""解析嵌套文章数据并保存入库"""

title = info.get('title') # 标题
cover = info.get('cover') # 封面图
author = info.get('author') # 作者
digest = info.get('digest') # 关键字
source_url = info.get('source_url') # 原文地址
content_url = info.get('content_url') # 微信地址
# ext_data = json.dumps(info, ensure_ascii=False) # 原始数据

content_url = content_url.replace('amp;', '').replace('#wechat_redirect', '').replace('http', 'https')
article_id = self.postgres.handler(self._save_article(), (msg_id, title, author, cover, digest,
source_url, content_url, post_time,
datetime.now()), fetch=True)
if article_id:
self._parse_article_detail(content_url, article_id)

def _parse_article_detail(self, content_url, article_id):
"""从文章页提取相关参数用于获取评论,article_id是已保存的文章id"""

try:
html = requests.get(content_url, headers=self.headers).text
except:
print('获取评论失败' + content_url)
else:
# group(0) is current line
str_comment = re.search(r'var comment_id = "(.*)" \|\| "(.*)" \* 1;', html)
str_msg = re.search(r"var appmsgid = '' \|\| '(.*)'\|\|", html)
str_token = re.search(r'window.appmsg_token = "(.*)";', html)

if str_comment and str_msg and str_token:
comment_id = str_comment.group(1) # 评论id(固定)
app_msg_id = str_msg.group(1) # 票据id(非固定)
appmsg_token = str_token.group(1) # 票据token(非固定)

# 缺一不可
if appmsg_token and app_msg_id and comment_id:
print('Crawl article comments: ' + content_url)
self._crawl_comments(app_msg_id, comment_id, appmsg_token, article_id)

def _crawl_comments(self, app_msg_id, comment_id, appmsg_token, article_id):
"""抓取文章的评论"""

api = 'https://mp.weixin.qq.com/mp/appmsg_comment?action=getcomment&scene=0&__biz={0}' \
'&appmsgid={1}&idx=1&comment_id={2}&offset=0&limit=100&uin=777&key=777' \
'&pass_ticket={3}&wxtoken=777&devicetype=android-26&clientversion=26060739' \
'&appmsg_token={4}&x5=1&f=json'.format(self.biz, app_msg_id, comment_id,
self.pass_ticket, appmsg_token)
resp = requests.get(api, headers=self.headers).json()
ret, status = resp['base_resp']['ret'], resp['base_resp']['errmsg']
if ret == 0 or status == 'ok':
elected_comment = resp['elected_comment']
for comment in elected_comment:
nick_name = comment.get('nick_name') # 昵称
logo_url = comment.get('logo_url') # 头像
comment_time = datetime.fromtimestamp(comment.get('create_time')) # 评论时间
content = comment.get('content') # 评论内容
content_id = comment.get('content_id') # id
like_num = comment.get('like_num') # 点赞数
# reply_list = comment.get('reply')['reply_list'] # 回复数据

self.postgres.handler(self._save_article_comment(), (article_id, comment_id, nick_name, logo_url,
content_id, content, like_num, comment_time,
datetime.now()))

@staticmethod
def _save_article():
sql = 'insert into tb_article(msg_id,title,author,cover,digest,source_url,content_url,post_time,create_time) ' \
'values(%s,%s,%s,%s,%s,%s,%s,%s,%s) returning id'
return sql

@staticmethod
def _save_article_comment():
sql = 'insert into tb_article_comment(article_id,comment_id,nick_name,logo_url,content_id,content,like_num,' \
'comment_time,create_time) values(%s,%s,%s,%s,%s,%s,%s,%s,%s)'
return sql

if __name__ == '__main__':
biz = 'MzI2NDk5NzA0Mw==' # "36氪"
pass_ticket = 'NDndxxaZ7p6Z9PYulWpLqMbI0i3ULFeCPIHBFu1sf5pX2IhkGfyxZ6b9JieSYRUy'
app_msg_token = '971_Z0lVNQBcGsWColSubRO9H13ZjrPhjuljyxLtiQ~~'
cookie = 'wap_sid2=CO3YwOQHEogBQnN4VTNhNmxQWmc3UHI2U3kteWhUeVExZHFVMnN0QXlsbzVJRUJKc1pkdVFUU2Y5UzhSVEtOZmt1VVlYTkR4SEllQ2huejlTTThJWndMQzZfYUw2SldLVGVMQUthUjc3QWdVMUdoaGN0Nml2SU05cXR1dTN2RkhRUVd1V2Y3SFJ5d01BQUF+fjCB1pLcBTgNQJVO'
# 以上信息不同公众号每次抓取都需要借助抓包工具做修改
wxMps = WxMps(biz, pass_ticket, app_msg_token, cookie)
wxMps.start() # 开始爬取文章及评论
文末小结
文末小结
数据展示
最后展示数据库中的数据。由于采用单线程爬取速度较慢,且无大规模数据需求,此处仅为简单测试:
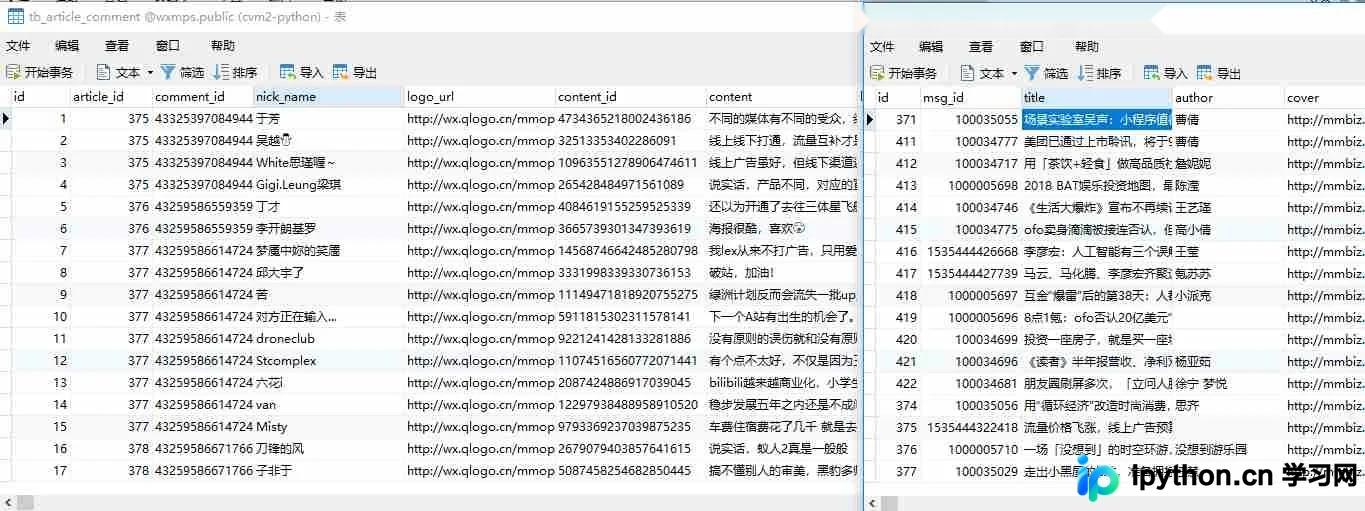
抓取的部分数据
总结与推荐
编写爬虫需要细心,若觉得过于繁琐,推荐了解WechatSogou工具。如有疑问欢迎在底部留言讨论。
完整代码
完整代码:GitHub
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









