Django集成Scrapy爬虫实现数据自动入库教程
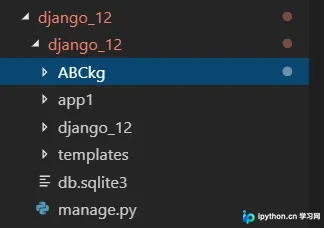
本文详细讲解如何在Django项目中创建并运行Scrapy爬虫,实现数据抓取后直接存入Django数据库。通过配置settings.py、编写爬虫逻辑、利用scrapy-djangoitem将Item映射为Django模型,并在Pipeline中调用save()方法,最终在Admin后台查看结果。
2026-10-14
6

本文详细讲解如何在Django项目中创建并运行Scrapy爬虫,实现数据抓取后直接存入Django数据库。通过配置settings.py、编写爬虫逻辑、利用scrapy-djangoitem将Item映射为Django模型,并在Pipeline中调用save()方法,最终在Admin后台查看结果。
本文详细介绍如何在Scrapy框架中实现IP动态代理及定时更换IP池的方法。通过配置settings文件定义IP池与计数器,利用start_requests初始化IP数据,并在下载器中间件的process_request中实现每次请求随机选取IP及达到阈值后自动刷新IP池的逻辑,确保爬虫的稳定运行。
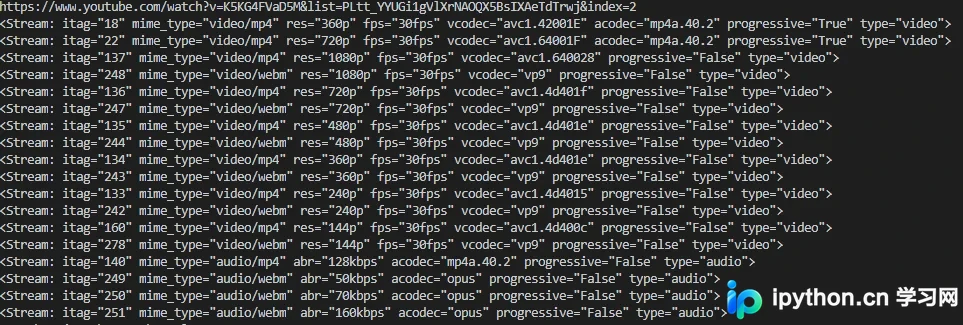
本文介绍使用Python爬取YouTube视频的方法。通过pytube库获取1080p视频和音频流,利用ffmpeg命令进行音视频融合。文中提供了完整的Python代码示例及批处理脚本,帮助实现批量下载高清视频资源。
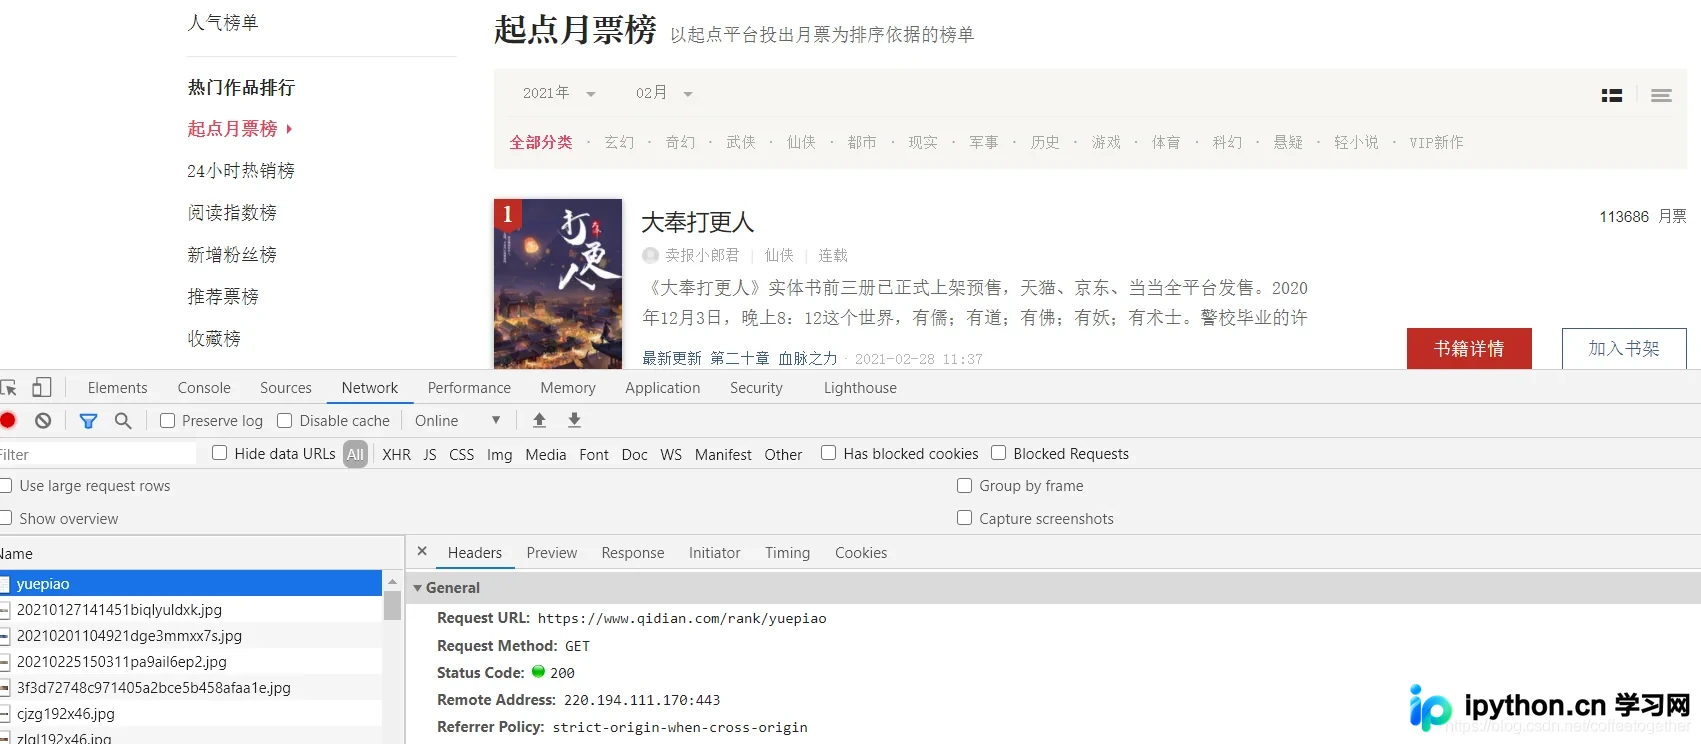
本文以爬取起小点小说月票榜为例,详细演示如何破解网站字体加密反爬机制。通过定位HTML节点、使用正则提取加密数据、解析woff字体文件映射关系,最终还原明文月票数。文章提供完整Python代码及关键步骤解析,帮助开发者掌握动态字体加密的应对方法。
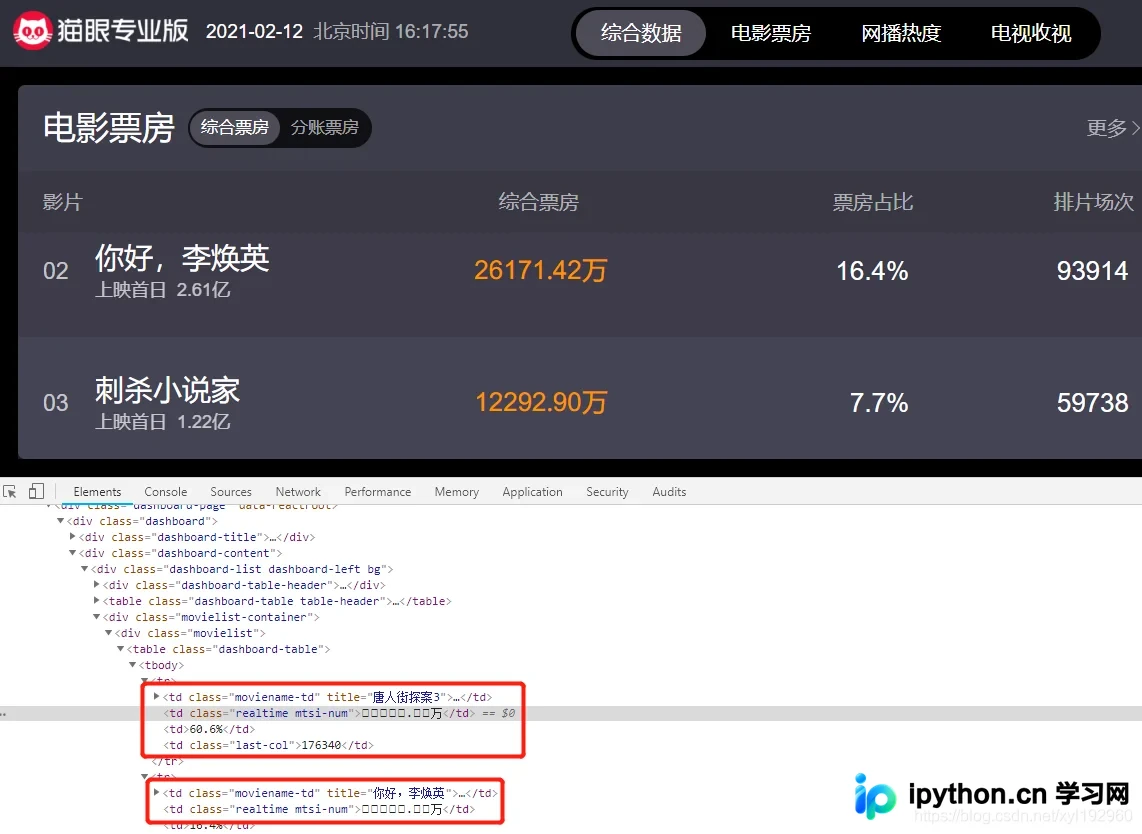
本文深入解析2021年猫眼票房页面的动态字体加密机制,通过Python实现反爬策略。核心思路是下载动态字体文件,利用fontTools提取字形坐标,计算线段斜率并进行差值比对。当斜率差小于0.5且样本数大于等于9时判定为同一数字,从而构建映射表替换乱码,获取真实票房数据。
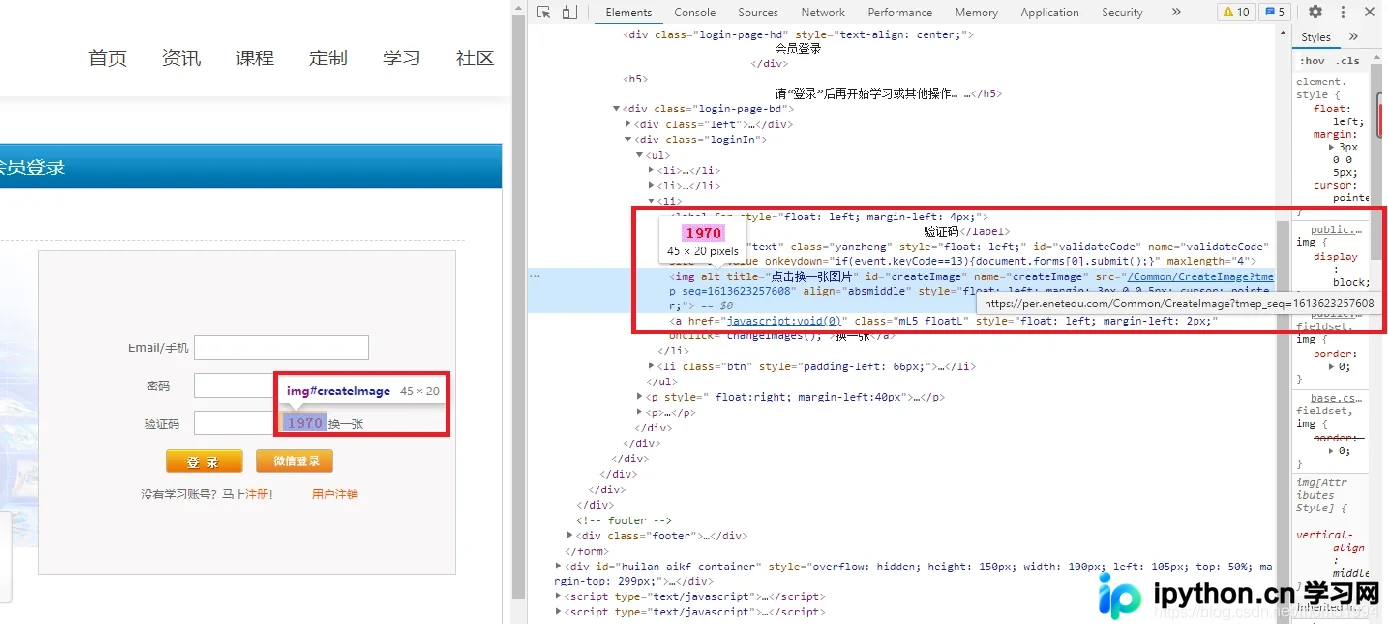
本文详细讲解如何使用Python爬取经过分片处理的TS视频文件,并解决验证码登录难题。通过手动或自动识别验证码完成Session保持,解析M3U8索引文件获取视频片段列表,批量下载后拼接并转换为MP4格式,完整展示从登录到视频保存的技术细节。
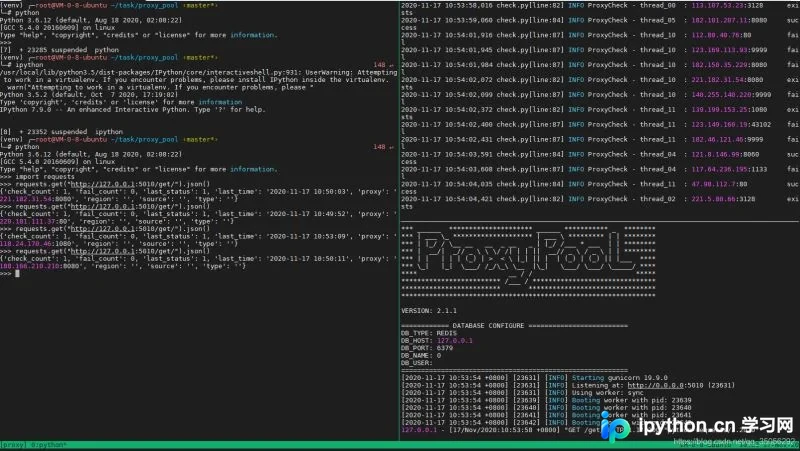
本文介绍在Python爬虫开发中,针对高并发请求导致IP被封禁的问题,使用开源项目proxy_pool搭建代理池的完整流程。涵盖从Python虚拟环境搭建、Redis依赖安装,到配置文件修改、服务启动及代码测试的具体步骤,帮助开发者实现IP自动轮换与异常处理。
本文详细介绍在Scrapy框架中实现模拟登录的三种核心方式:直接携带Cookies、使用FormRequest发送POST请求以及利用from_response自动解析表单。通过GitHub登录示例,解析代码逻辑与配置要点,帮助开发者掌握不同场景下的最佳实践。
本文介绍如何使用Python实现B站直播自动发送弹幕功能。通过抓取直播间发送弹幕的Post请求接口,利用requests库模拟提交数据,结合Tkinter构建简易图形界面,实现指定房间号的弹幕自动发送。代码包含随机弹幕选取、请求参数构造及循环发送逻辑,供技术参考。
本文详细介绍在Python3爬虫项目中安装RedisDump的方法。由于RedisDump基于Ruby实现,需先配置Ruby环境及rvm工具。文章涵盖通过gem命令安装redis-dump的详细步骤,包括国内源配置、版本验证及命令测试,帮助开发者顺利完成Redis数据迁移工具的部署。
本文详解Python中BeautifulSoup库的核心用法,涵盖从安装配置到解析器选择(html.parser、lxml等)。深入解析Tag、NavigableString、Comment三大基本元素,系统讲解下行、上行及平行遍历技巧,并演示如何利用find_all结合正则表达式精准提取网页数据,助力爬虫开发入门。
本文详解如何使用Python批量下载抖音个人主页的无水印视频。核心思路是通过BurpSuite抓取手机App的HTTPS请求,分析获取视频列表的API接口。文章介绍了从单个视频去水印技巧到批量抓取链接的完整流程,重点讲解如何模拟手机请求以绕过网页端的限制,为开发自动化下载脚本提供技术参考。