

Python爬虫实战:2021猫眼票房字体加密反爬策略解析

本文深入解析2021年猫眼票房页面的动态字体加密机制,通过Python实现反爬策略。核心思路是下载动态字体文件,利用fontTools提取字形坐标,计算线段斜率并进行差值比对。当斜率差小于0.5且样本数大于等于9时判定为同一数字,从而构建映射表替换乱码,获取真实票房数据。
前言与背景
前言:
猫眼票房页面的字体加密机制具有动态性,每次或每日加载页面时生成的字体文件均会发生变化。本文旨在针对这种动态加密方式进行分析与破解。
字体加密的基本原理在于,网站开发者自定义了一套字体编码规则,对关键数据进行编码。浏览器在加载页面时,依据特定的字体文件对该编码进行解码,从而在视觉上显示为正确的数字或文字。
目前已知采用字体加密技术的网站包括58同城、起点中文网、猫眼、大众点评、启信宝、天眼查、实习僧以及汽车之家等。本文不再赘述字体文件的具体映射关系,建议不熟悉此概念的读者查阅其他相关资料。若尚未掌握爬虫基础,可参考《简单粗暴入门法——Python爬虫入门篇》。
import requests
import urllib.request as down
import json
from fontTools.ttLib import TTFont
import re
#分析用
import matplotlib.pyplot as plt #绘图
import numpy as np # 科学计算库
安装必要的Python库: pip install matplotlib pip install requests pip install numpy pip install fonttools
环境配置与页面分析
首先对猫眼票房页面进行初步分析。
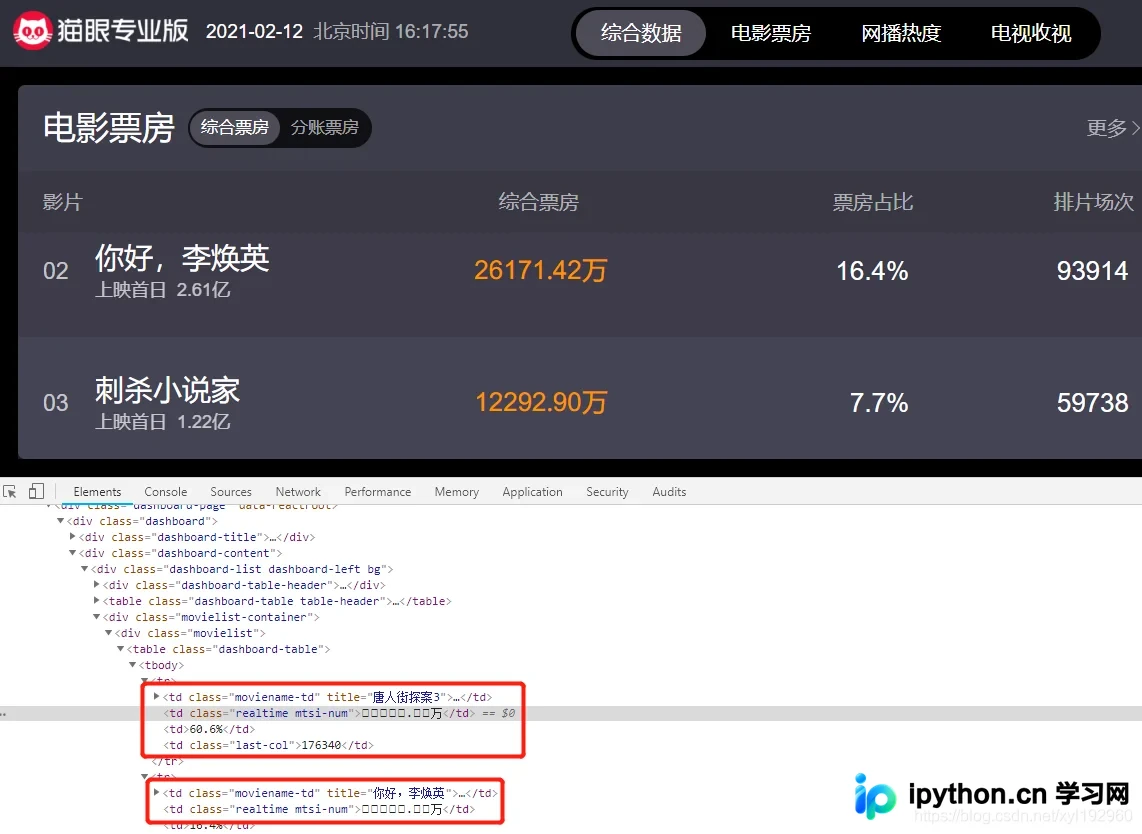
在审查元素中,票房数字显示为乱码,这通常是使用了字体加密的迹象。因此,我们需要定位并获取页面中引用的字体文件(通常以链接形式存在)。
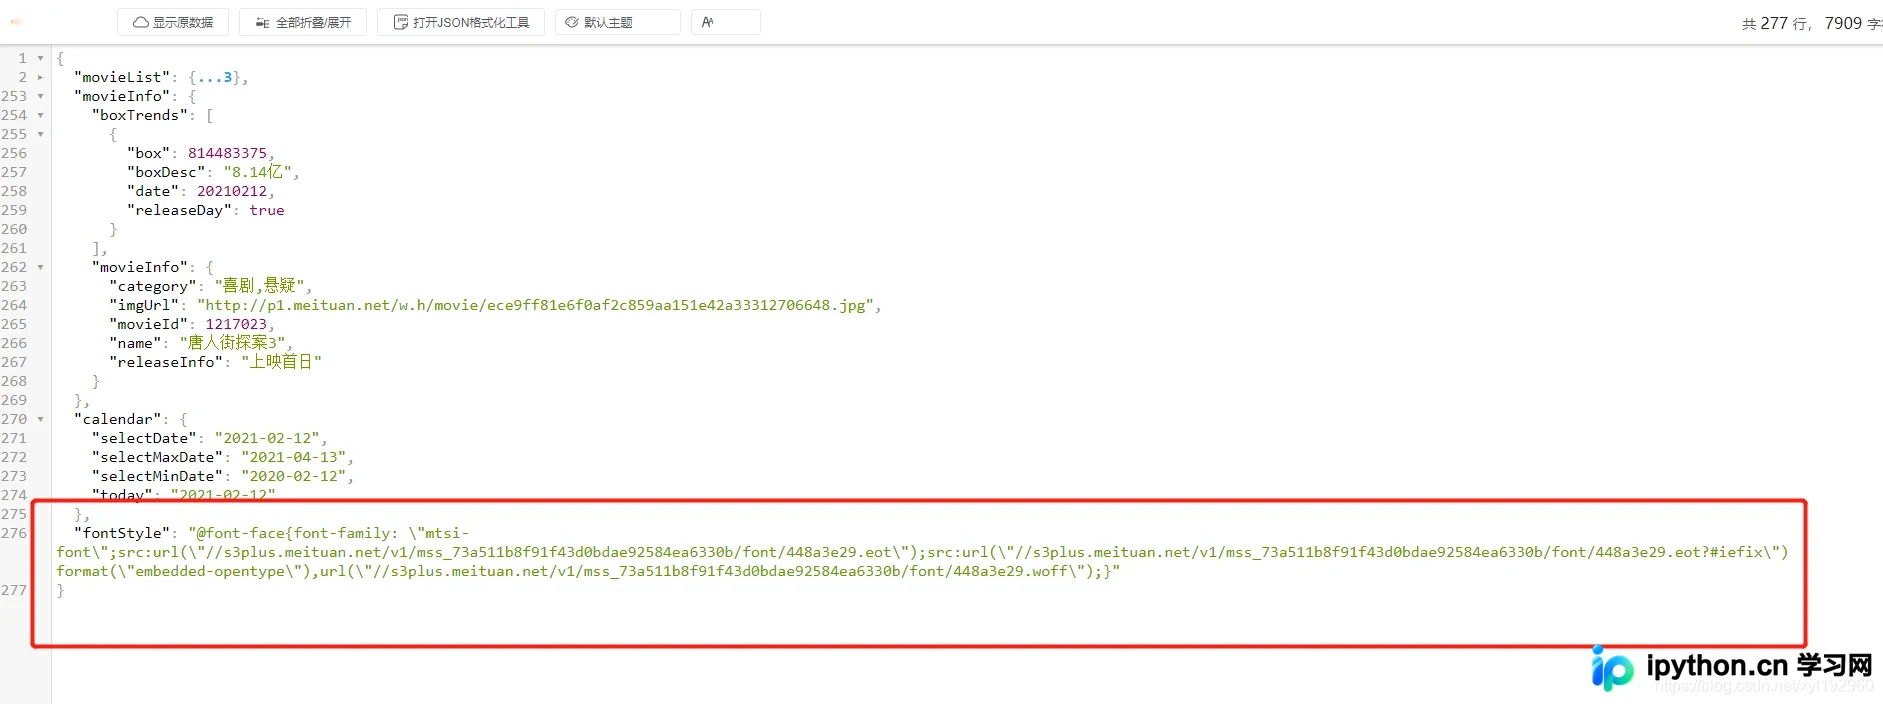
字体映射与坐标提取
获取字体文件后,下载并分析其映射关系,可以得到一组基础字形映射表。同时,通过该映射关系可以提取出每个字形对应的所有坐标点。
baseFont=TTFont('maoyan.woff')
# 获取相应数字的namecode和形状坐标的关系,可用来获取坐标
glyf=baseFont['glyf']
#通过对一份字体样本分析得出的字体映射
baseNumberMaps={
 0:glyf['uniF632'],
 1:glyf['uniF2F1'],
 2:glyf['uniF0A4'],
 3:glyf['uniF7B7'],
 4:glyf['uniE82D'],
 5:glyf['uniF653'],
 6:glyf['uniE756'],
 7:glyf['uniF41A'],
 8:glyf['uniE79B'],
 9:glyf['uniE81E']
}
for num,name in baseNumberMaps.items():
 print(name.coordinates)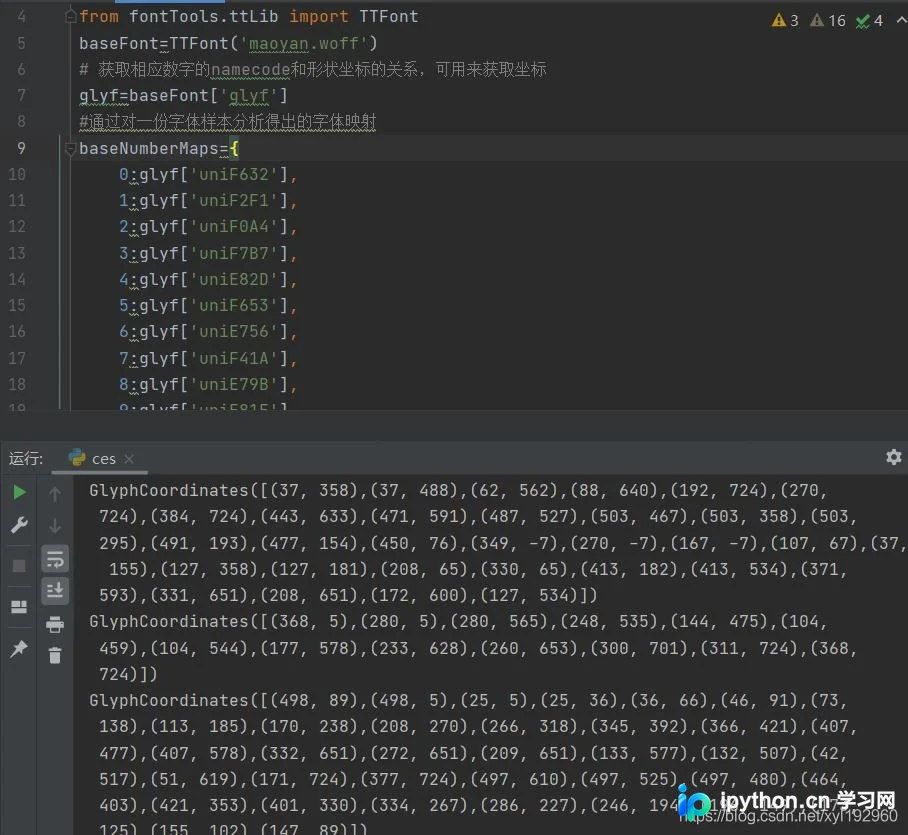
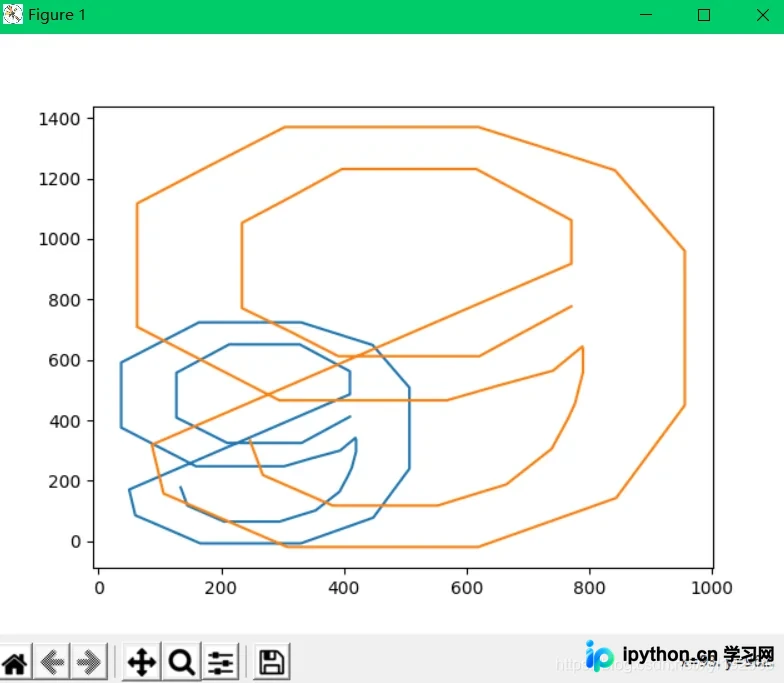
将提取的坐标绘制成图形,对比不同组字形的图形可以发现,尽管每套字形的坐标位置和大小比例不同,但字形结构保持不变,即图形具有相似性。
斜率对比算法原理
通过对比坐标发现,虽然每套字形的具体坐标会发生变化,但整体图形特征一致。因此,本文采用斜率对比法:计算每个字形各部分线段的斜率,若两组字形对应线段的斜率之差小于设定阈值,则判定这两个字形代表相同的数字。
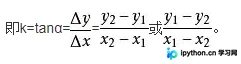
完整处理流程与思路
基于上述分析,得出完整的处理思路:首先获取基础字体映射关系表,然后爬取页面并下载动态加载的字体文件,获取待对比的字体映射关系表。接着,计算每套字体中每个字形线段的斜率,并进行差值计算。通过循环匹配,从基础字形的0-9开始与新字形的斜率进行比对,若斜率之差小于0.5且匹配样本数大于等于9,则认定两个图形代表同一个数字。最终获得正确的字体映射关系,对加密字体进行替换,从而得到正确的票房内容。
代码实现与效果
程序实现部分。
import requests
import urllib.request as down
import json
from fontTools.ttLib import TTFont
import re
import MyPyClass

# 得到字体斜率列表(部分)
def font_Kdict(mapstype,maps=None):
 '''
 得到字体斜率字典(部分)
 参数:
 mapstype:str->maps类型,判断是是base/new
 maps:映射字典

 return kdict
 kdict字典关系:
 num:Klist 数字对应每条线段的斜率列表
 '''
 kdict={}
 # 遍历maps字典,找到对应的num和namecode
 for num, namecode in maps.items():
 # 跳过无用数据
 if namecode == 'x': continue
 # 判断类型,并从.coordinates得到对应num的所有坐标
 if mapstype=='base':coordinates = namecode.coordinates
 elif mapstype=='new':coordinates=glyf[namecode].coordinates
 # 得到坐标 X列表和坐标 Y列表
 x = [i[0] for i in coordinates]
 y = [i[1] for i in coordinates]
 Klist = []
 # 遍历X列表并切片为前10个数据进行斜率计算,即代表绘图的前10条线段的斜率
 for index, absx in enumerate(x[:10]):
  # 当斜率为0/1时,认为斜率为1计算
  if x[index + 1] == x[index] or y[index + 1] == y[index]:
  absxy = 1
  else:
  absxy = (y[index + 1] - y[index]) / (x[index + 1] - x[index])
  # 将斜率加入到列表
  Klist.append(-absxy if absxy < 0 else absxy)
 kdict[num]=Klist
 #print('base:', code, Klist, name)
 return kdict
# 对比斜率字典
def contrast_K(kbase,knew):
 '''
 对比斜率映射差距
 参数:
 kbase:基础字体映射表的斜率字典
 knew:当前链接的字体映射表的斜率字典

 return:dict
 fontMaps:根据对比得出正确的字体映射关系字典

 '''
 fontMaps = {}
 # 遍历kbase字典
 for base in kbase.items():
 n = 0 # 成功匹配的斜率个数
 # 遍历knew字典
 for new in knew.items():
  # 遍历kbase>knew>下的两组斜率,进行大小匹配,
  # 如果斜率k的差值小于0.5,并且样本数>=9时,认为两个坐标图形相识只是大小比例不同
  # 即k<=0.5 n>=9
  for (k1,k2) in zip(base[1],new[1]):
  # k取正数
  k=k1-k2 if k1>k2 else k2-k1
  if k<=0.5:
   n+=1
   continue
  else:
   break
  if n>=9:
  # 匹配正确则添加进字典中 此时的字典关系是:code:num 代码对应数字的关系
  fontMaps[str(hex(new[0]).replace('0x','&#x'))]=str(base[0])
  break
  n=0
 #print(fontMaps)
 return fontMaps

# 建立基础字体对象
baseFont=TTFont('maoyan.woff')
# 获取相应数字的namecode和形状坐标的关系,可用来获取坐标
glyf=baseFont['glyf']
#通过对一份字体样本分析得出的字体映射
baseNumberMaps={
 0:glyf['uniF632'],
 1:glyf['uniF2F1'],
 2:glyf['uniF0A4'],
 3:glyf['uniF7B7'],
 4:glyf['uniE82D'],
 5:glyf['uniF653'],
 6:glyf['uniE756'],
 7:glyf['uniF41A'],
 8:glyf['uniE79B'],
 9:glyf['uniE81E']
}
url='https://piaofang.maoyan.com/dashboard-ajax?orderType=0&uuid=1778ad877f8c8-0b23bf32a2bb26-c7d6957-1fa400-1778ad877f8c8&riskLevel=71&optimusCode=10'
ua=MyPyClass.GetUserAgent()#获得ua
# 爬取内容
with requests.get(url,headers={'user-agent':ua}) as response:
 # 获取存放字典的json字段,并提取字体url
 fontStyle=json.loads(response.content)['fontStyle']
 fontStyle=re.findall('\"([\s\S]*?)\"',fontStyle[::-1])
 fonturl='http:'+fontStyle[0][::-1]# 字体url链接
 # 将加载的字体下载保存到本地,并对其进行分析
 down.urlretrieve(fonturl,'newfont.woff')
 # 爬取的电影数据内容
 content = json.loads(response.content)['movieList']['data']['list']
# 信息字典
movieNum={}#综合票房数字典
movieDayOne= {}#上映首日数量
movieRate={}#票房占比
movieshowCount={}#排片场次
movieViewerAvg={}#场均人数
movieInfos={}
# 页面内容
for i in content:
 moviename=i['movieInfo']['movieName']
 movieNum[moviename]=i['boxSplitUnit']['num']
 movieDayOne[moviename]=i['sumBoxDesc']
 movieRate[moviename]=i['splitBoxRate']
 movieshowCount[moviename]=i['showCount']
 movieViewerAvg[moviename]=i['avgShowView']

# 新字体对象
fontnew=TTFont('newfont.woff')
# 得到当前字体的映射关系表
newNumberMaps=fontnew.getBestCmap()
# 获取字形
glyf=fontnew['glyf']
# 基础字体斜率字典
k_base_dict=font_Kdict(maps=baseNumberMaps,mapstype='base')
# 新字体斜率字典
k_new_dict=font_Kdict(maps=fontnew.getBestCmap(),mapstype='new')
# 得到字体映射字典
fontcodes=contrast_K(k_base_dict,k_new_dict)
# 对加密的字体遍历分组,并去除无用字符
for name,numbercode in movieNum.items():
 movieNum[name]=re.findall('([\S]*?);', numbercode)
# 根据得到的fontcodes映射对加密字体进行替换,得到正确数值
for index,(name,numbercodelist) in enumerate(movieNum.items()):
 num=[]
 # 替换操作
 for code in numbercodelist:
 if '.' in code:
  code=code.replace('.','')
  num.append('.'+fontcodes[code])
 else:
  num.append(fontcodes[code])
 infos=['排行:'+str(index+1),
 '片名',name,
 '上映首日',movieDayOne[name],
 '票房',''.join(num)+'万',
 '票房占比',movieRate[name],
 '场均人数',movieViewerAvg[name]+'人',
 '排片场次',movieshowCount[name]]
 print(infos)
实现效果如下。
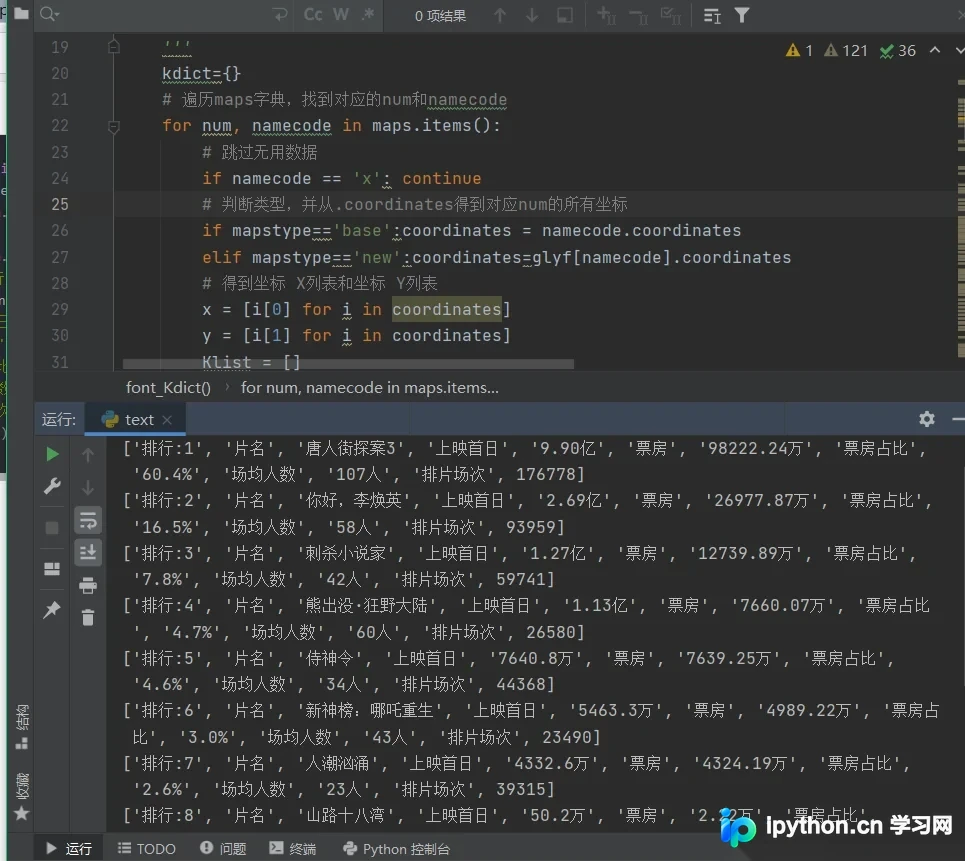
至此,关于Python爬虫实例之2021猫眼票房字体加密反爬策略(粗略版)的介绍到此结束。更多相关Python爬虫及猫眼票房字体反爬内容,请搜索本站历史文章或继续浏览后续相关文章。希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









