

Python爬虫实战:破解字体加密获取小说月票数据

本文以爬取起小点小说月票榜为例,详细演示如何破解网站字体加密反爬机制。通过定位HTML节点、使用正则提取加密数据、解析woff字体文件映射关系,最终还原明文月票数。文章提供完整Python代码及关键步骤解析,帮助开发者掌握动态字体加密的应对方法。
案例背景与目标
本次案例选取起小点小说网作为目标站点进行演示。
案例目的:
旨在通过抓取起小点小说月票榜中的小说名称及对应月票数量,深入解析并破解字体加密这一常见的反爬手段,将页面上显示的加密字符还原为可读的明文数据。
程序功能:
用户输入需要爬取的小说榜单页数后,程序自动获取每一页对应的小说标题及其月票数值。
数据定位与提取分析
案例分析:首先确定目标网站的URL地址。
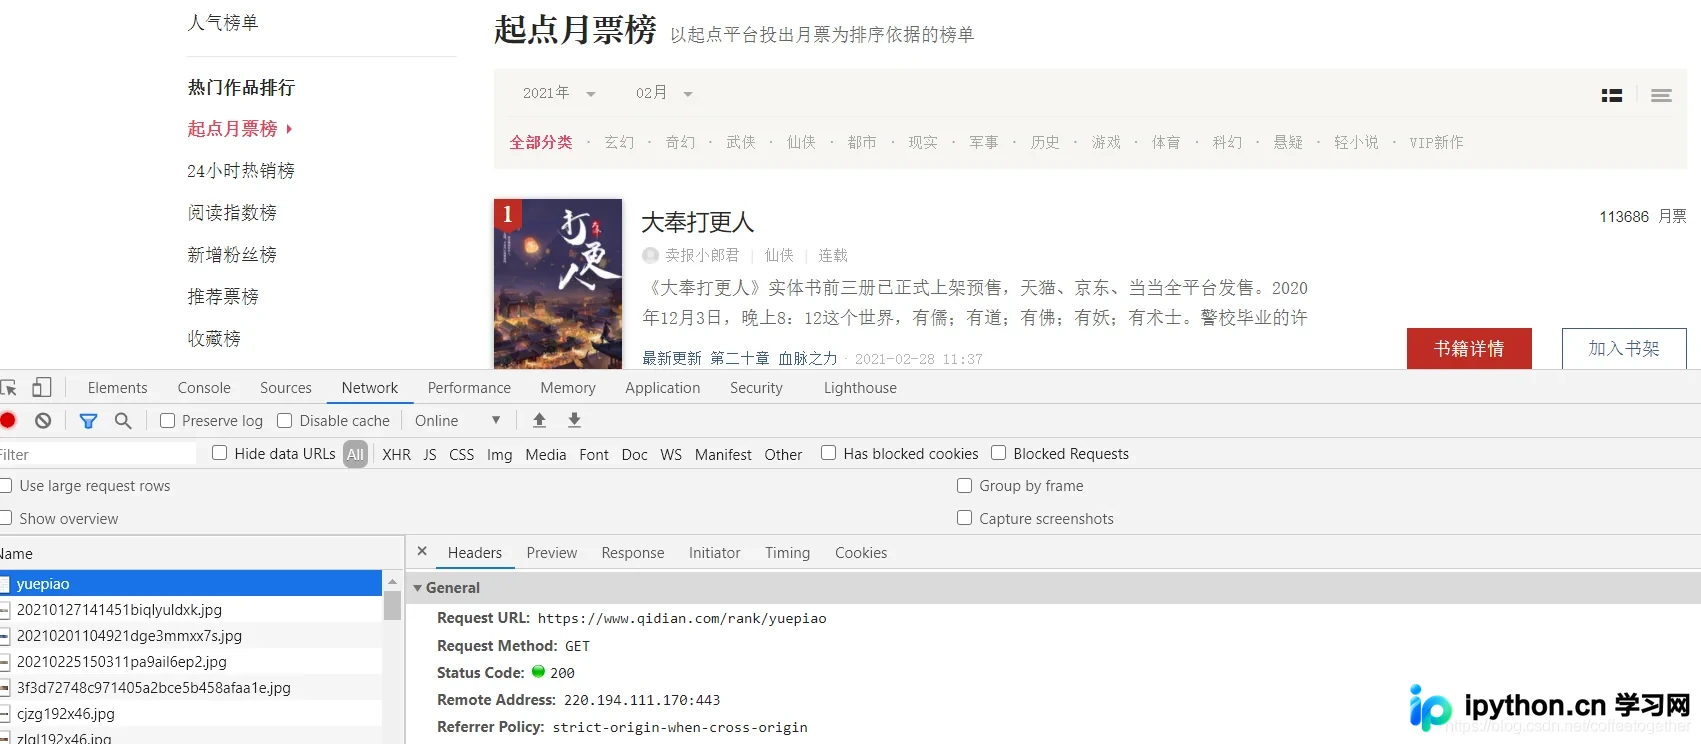
通过浏览器开发者工具(右键检查)定位小说名称在HTML结构中的具体位置。
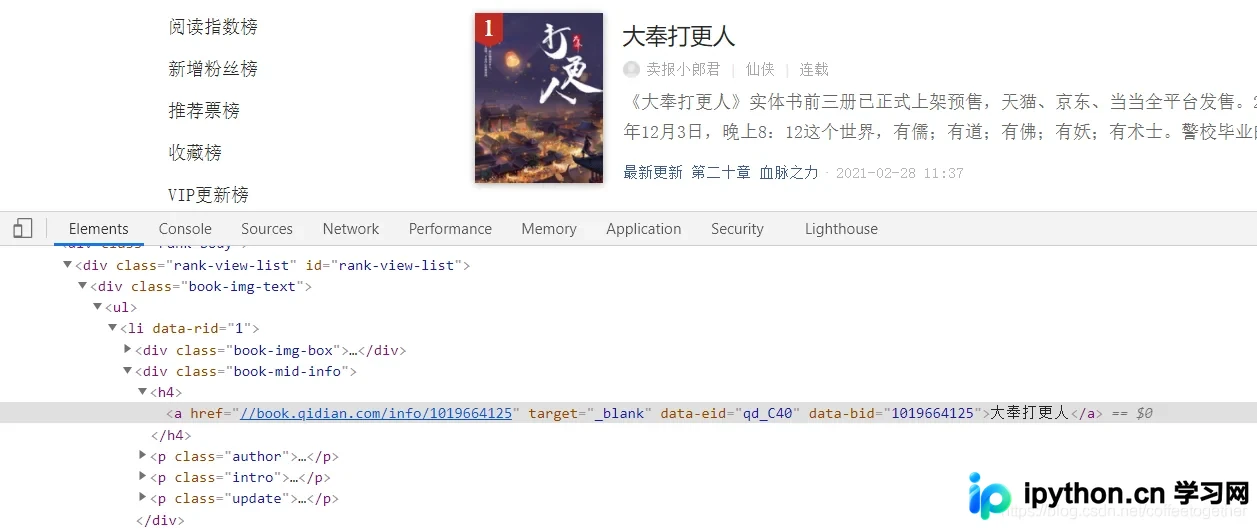
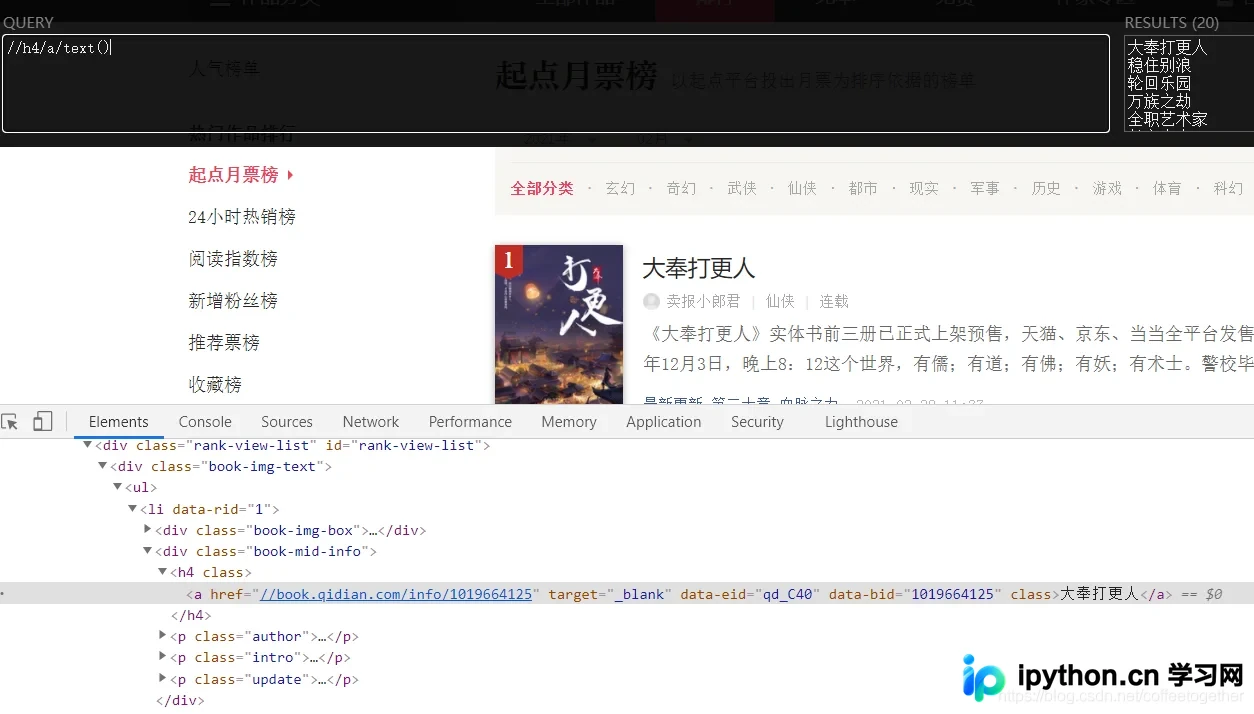
根据名称所在的DOM节点,编写提取小说名称的XPath语法。
同样利用开发者工具(右键检查)定位月票数值在页面中的位置。
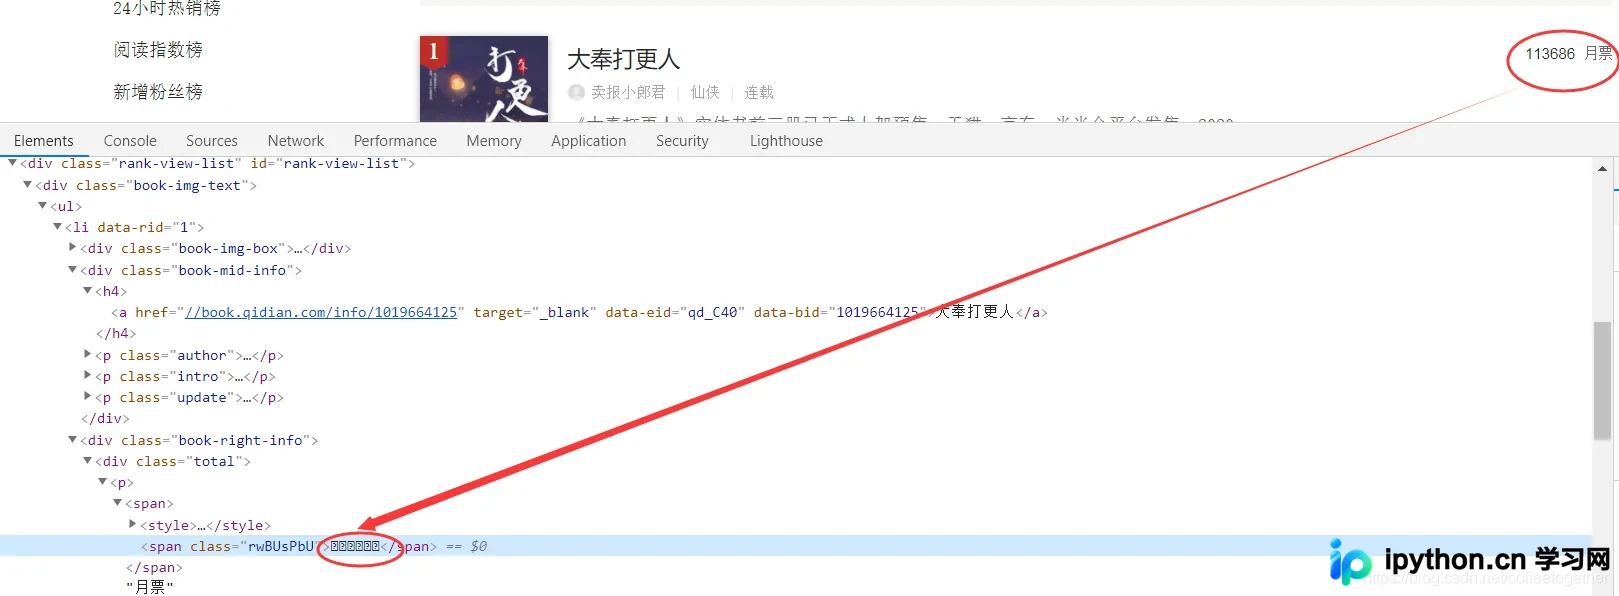
观察发现,直接检查月票数据的文本内容时,获取到的是一串经过加密处理的特殊字符。
尝试使用xpathhelper调试发现,由于数据被加密,无法直接通过常规XPath语法提取到有效的加密数据字符串。因此,决定改用正则表达式来提取这串加密数据。
利用正则表达式对页面源码进行数据提取操作。
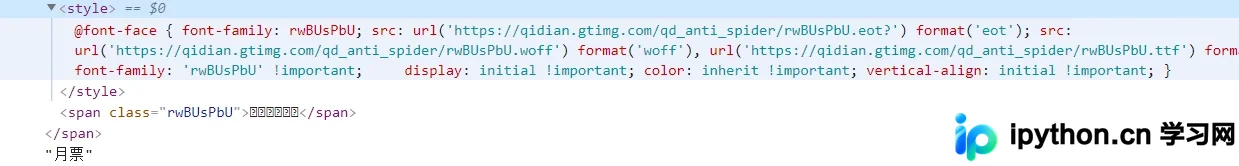
具体的正则表达式规则如下。

执行正则提取后,获得的加密数据示例如下。

字体加密破解原理
破解这串加密数据是本次案例的核心难点。
既然存在加密数据,必然存在对应的加密规则文件,即Font字体文件。通过定位包含加密数据的HTML元素,找到其引用的woff字体文件URL,发送HTTP请求获取响应,从而下载得到该woff文件。
注意:我们需要下载的woff文件,其文件名通常与包含加密月票数的HTML元素class属性名称一致。
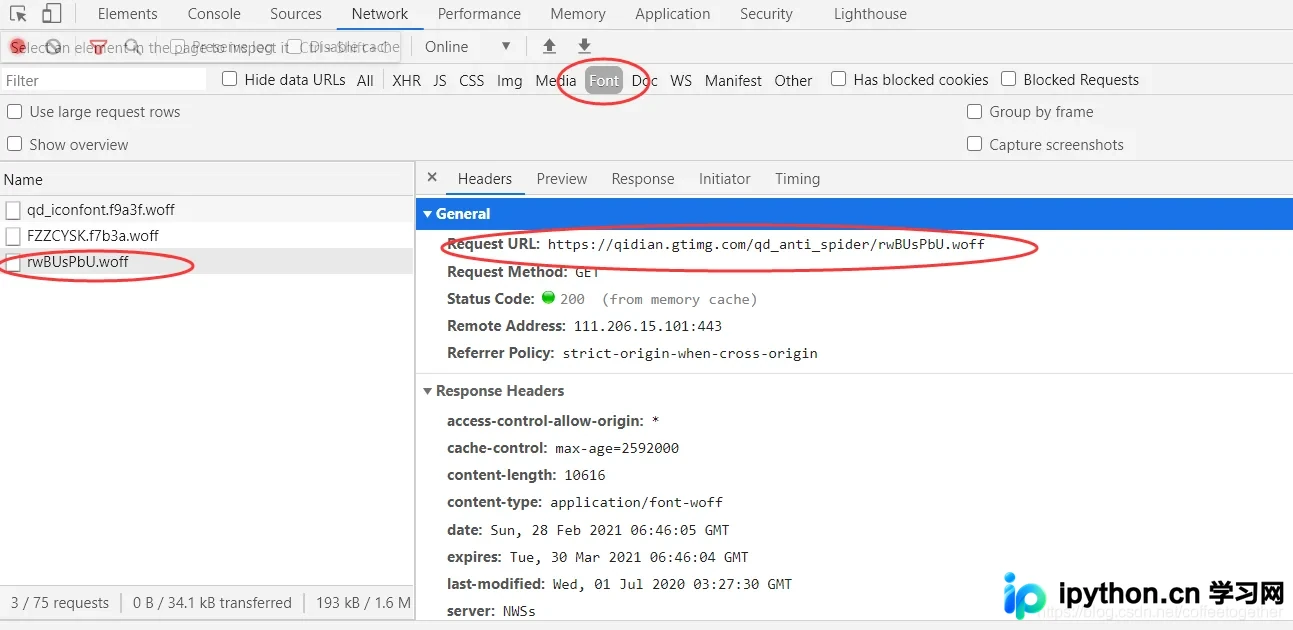
参考下图所示步骤,下载对应的woff字体文件。
接下来,需要建立加密字符与真实数字之间的映射关系,即找到16进制编码对应的英文数字描述。
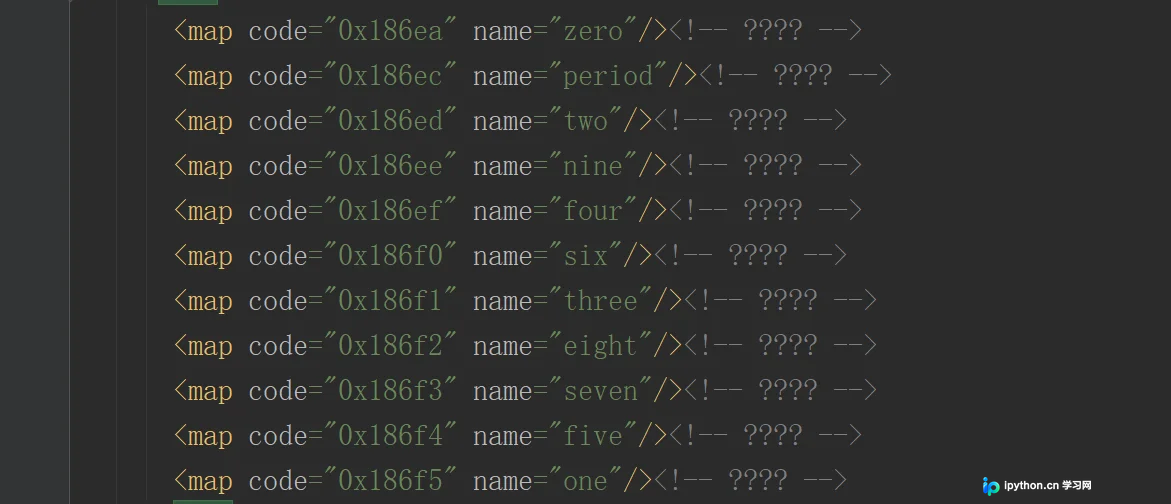
随后,利用第三方库TTFont读取woff文件,将文件中的16进制编码转换为10进制数值,并将英文数字描述转换为实际的阿拉伯数字。具体转换过程如下图所示。

经过解析,得到每个加密数据所对应的真实月票数值列表。

注意:
在前一步通过正则表达式提取的加密数据中,可能包含一些特殊符号或格式字符。
因此,在解析出月票数据的数字后,除了需要去除这些特殊符号外,还需将提取出的各个数字部分进行拼接,从而组合成最终的完整票数。
最后,通过对比不同页数的请求URL,分析并找到翻页的规律。
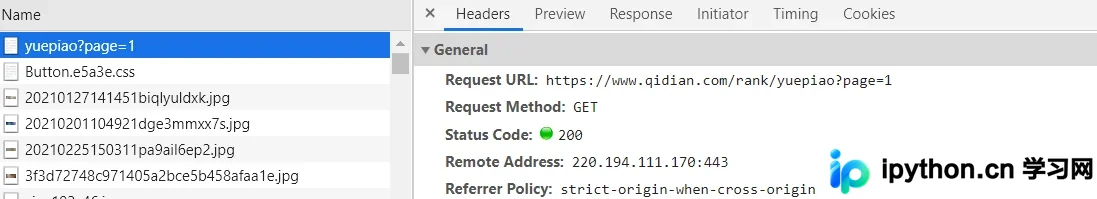
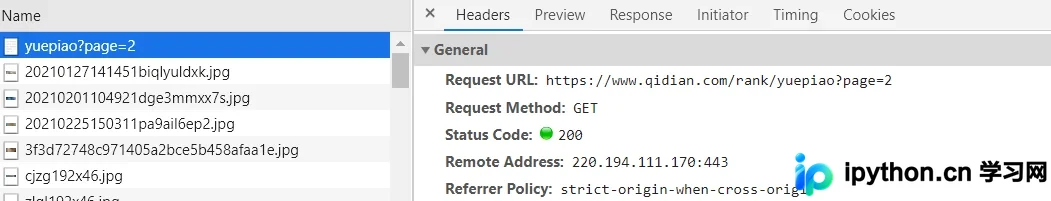
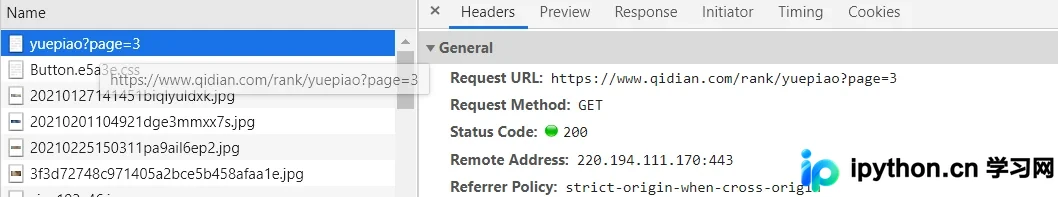
对比三个不同页面的URL发现,翻页的关键在于URL参数page的变化。
代码实现与结果验证
至此,问题分析完毕,开始编写具体代码实现。
import requests
from lxml import etree
import re
from fontTools.ttLib import TTFont
import json

if __name__ == '__main__':
  # 输入爬取的页数、
  pages = int(input('请输入要爬取的页数:')) # eg:pages=1,2
  for i in range(pages): # i=0,(0,1)
    page = i+1  # 1,(1,2)
    # 确认目标的url
    url_ = f'https://www.qidian.com/rank/yuepiao?page={page}'
    # 构造请求头参数
    headers = {
      'User-Agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/88.0.4324.150 Safari/537.36'
    }
    # 发送请求,获取响应
    response_ = requests.get(url_,headers=headers)
    # 响应类型为html问文本
    str_data = response_.text
    # 将html文本转换成python文件
    py_data = etree.HTML(str_data)
    # 提取文本中的目标数据
    title_list = py_data.xpath('//h4/a[@target="_blank"]/text() ')
    # 提取月票数,由于利用xpath语法无法提取,因此换用正则表达式,正则提取的目标为response_.text
    mon_list = re.findall('</style><span class=".*?">(.*?)</span></span>',str_data)
    print(mon_list)
    # 获取字体反爬woff文件对应的url,xpath配合正则使用
    fonturl_str = py_data.xpath('//p/span/style/text()')
    font_url = re.findall(r"format\('eot'\); src: url\('(.*?)'\) format\('woff'\)",str_data)[0]
    print(font_url)
    # 获得url之后,构造请求头获取响应
    headers_ = {
      'User-Agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/88.0.4324.150 Safari/537.36',
      'Referer':'https://www.qidian.com/'
    }
    # 发送请求,获取响应
    font_response = requests.get(font_url,headers=headers_)
    # 文件类型未知,因此用使用content格式
    font_data = font_response.content
    # 保存到本地
    with open('加密font文件.woff','wb')as f:
      f.write(font_data)
    # 解析加密的font文件
    font_obj = TTFont('加密font文件.woff')
    # 将文件转成明文的xml文件
    font_obj.saveXML('加密font文件.xml')
    # 获取字体加密的关系映射表,将16进制转换成10进制
    cmap_list = font_obj.getBestCmap()
    print('字体加密关系映射表:',cmap_list)
    # 创建英文转英文的字典
    dict_e_a = {'one':'1','two':'2','three':'3','four':'4','five':'5','six':'6',
          'seven':'7','eight':'8','nine':'9','zero':'0'}
    # 将英文数据进行转换
    for i in cmap_list:
      for j in dict_e_a:
        if j == cmap_list[i]:
          cmap_list[i] = dict_e_a[j]
    print('转换为阿拉伯数字的映射表为:',cmap_list)
    # 去掉加密的月票数据列表中的符号
    new_mon_list = []
    for i in mon_list:
      list_ = re.findall(r'\d+',i)
      new_mon_list.append(list_)
    print('去掉符号之后的月票数据列表为:',new_mon_list)
    # 最终解析月票数据
    for i in new_mon_list:
      for j in enumerate(i):
        for k in cmap_list:
          if j[1] == str(k):
            i[j[0]] = cmap_list[k]
    print('解析之后的月票数据为:',new_mon_list)
    # 将月票数据进行拼接
    new_list = []
    for i in new_mon_list:
      j = ''.join(i)
      new_list.append(j)
    print('解析出的明文数据为:',new_list)
    # 将名称和对应的月票数据放进字典,并转换成json格式及进行保存
    for i in range(len(title_list)):
      dict_ = {}
      dict_[title_list[i]] = new_list[i]
      # 将字典转换成json格式
      json_data = json.dumps(dict_,ensure_ascii=False)+',\n'
      # 将数据保存到本地
      with open('翻页起小点月票榜数据爬取.json','a',encoding='utf-8')as f:
        f.write(json_data)
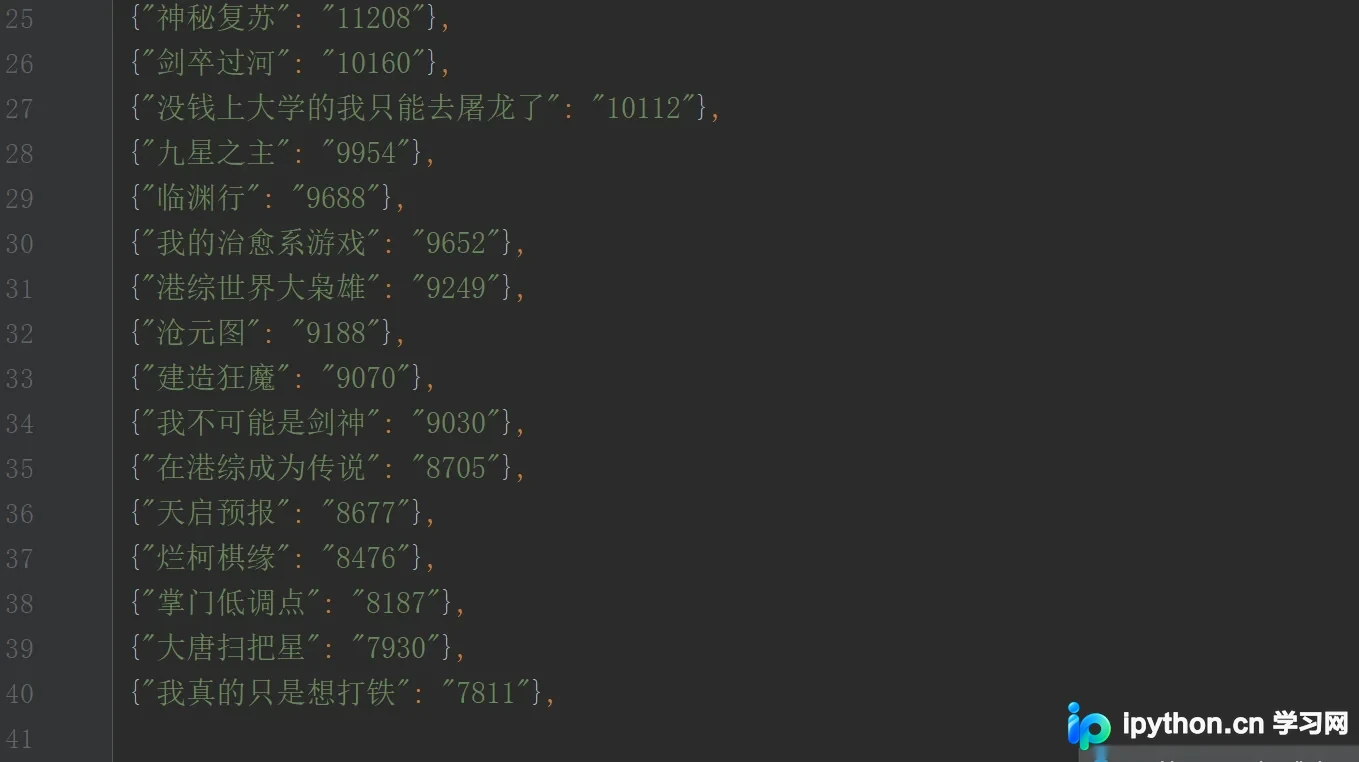
程序成功爬取了前2页的数据,每页包含20条小说信息。
代码执行结果如下所示。
到此,这篇关于Python爬虫破解字体加密的案例详解介绍完毕。更多关于Python爬虫破解字体加密的内容,欢迎搜索本站历史文章或继续浏览后续相关文章,希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









