Python 单线程爬虫实战:抓取课程列表与基础正则解析
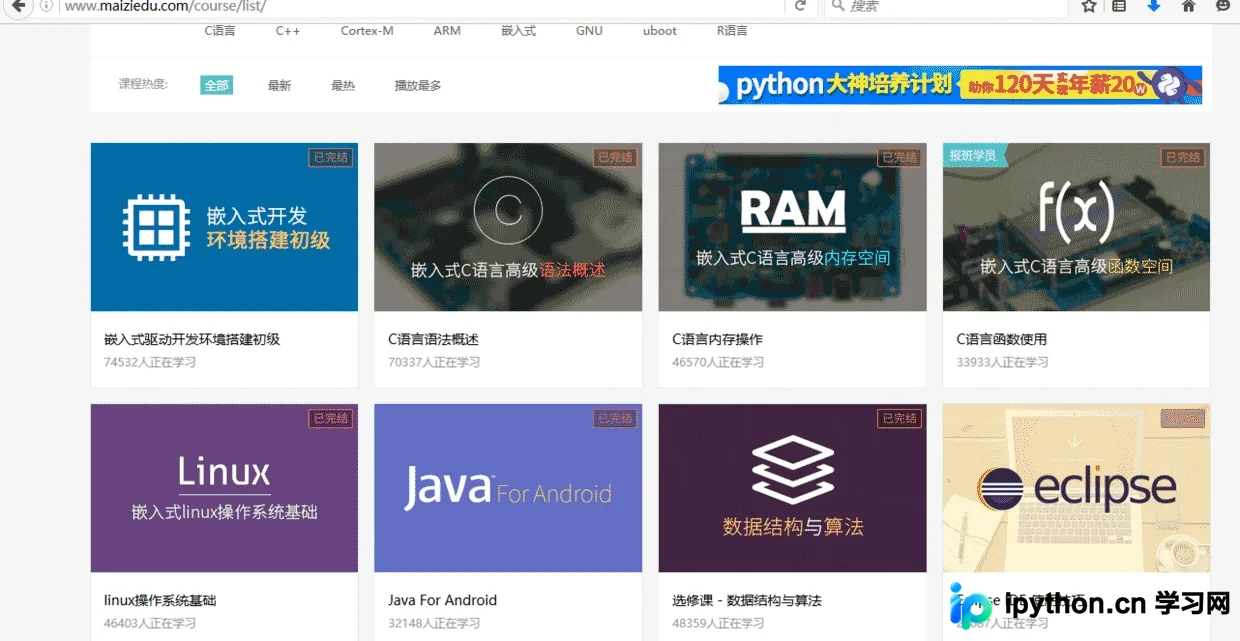
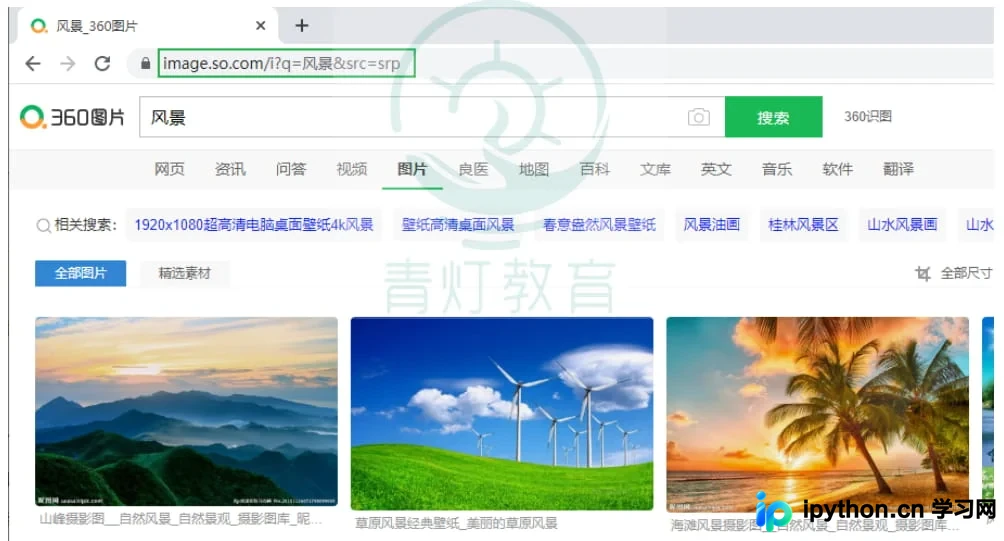
本文以抓取公开课程列表为例,详解 Python 单线程爬虫的实现流程。通过观察网址翻页规律构造请求队列,利用 requests 获取 HTML 源码,并结合 re 模块的正则表达式精准剥离课程标题与参与人数,最后将结构化数据写入本地文本。该方法适用于静态页面的基础数据采集学习。
2026-10-12
6

本文以抓取公开课程列表为例,详解 Python 单线程爬虫的实现流程。通过观察网址翻页规律构造请求队列,利用 requests 获取 HTML 源码,并结合 re 模块的正则表达式精准剥离课程标题与参与人数,最后将结构化数据写入本地文本。该方法适用于静态页面的基础数据采集学习。
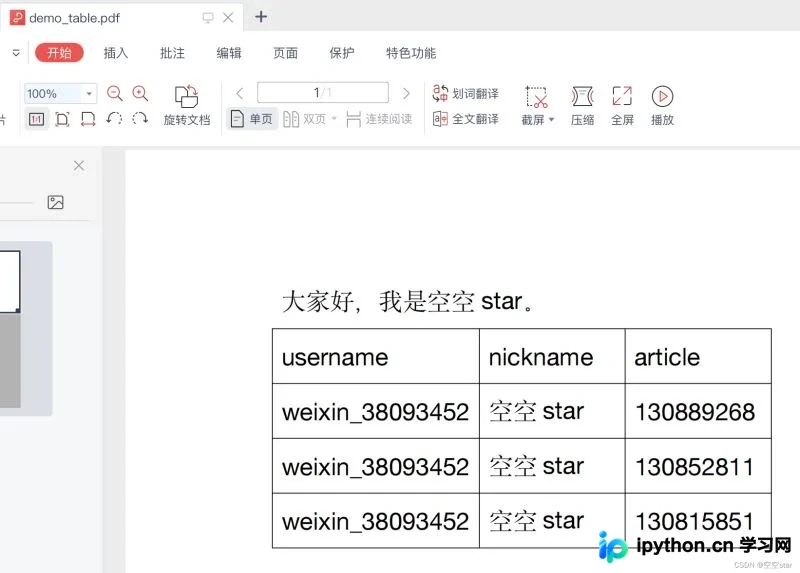
本文详细介绍如何利用Python的pdfplumber库快速提取PDF文件中的表格数据。通过安装依赖、配置解析策略与遍历页面的实操步骤,提供可直接运行的代码模板与参数说明,帮助用户高效完成结构化数据抓取任务。
本文介绍Python爬虫库Beautiful Soup的功能与安装方法。作为网页数据抓取工具,它提供简单的Python式函数处理导航、搜索、修改分析树。文章详细说明了从conda、pip到手动安装的多种途径,并演示了如何创建Beautiful Soup对象及解析HTML内容。
本文详细解析如何利用 Python 爬取动态网页中的图片,以知名插画网站 Pixiv 为例。文章涵盖请求头构造、JSON 数据解析、图片 ID 提取及真实地址获取等核心步骤,并提供完整的代码实现。通过手动输入 Cookie 的方式绕过登录限制,实现批量下载指定画师的所有插画作品。
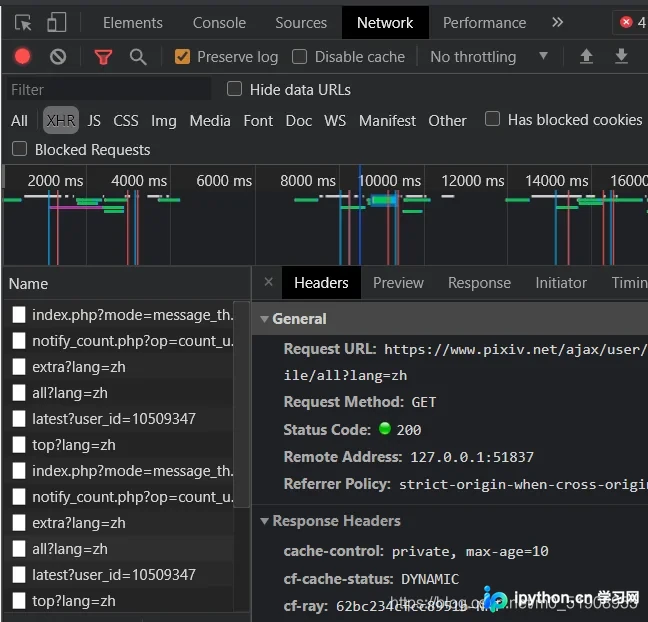
在使用 Python requests 模块进行网页抓取时,准确处理 URL 地址中的参数是成功获取数据的关键。本文将详细拆解查询参数与请求参数的区别,并演示如何使用 params 和 data 关键字自动完成数据的拼接与编码,避免手动字符串拼接导致的字符集错误。
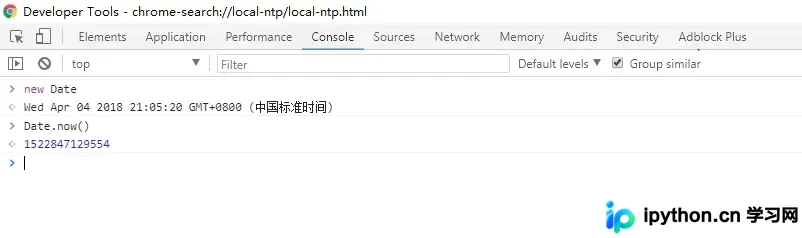
本文详解Python中利用PyExecJS库执行JavaScript代码的方法。涵盖Windows与Ubuntu环境下的JS运行时配置(Node.js、JScript等),通过代码示例展示如何编译与调用JS函数,并对比不同环境下的执行性能,指出PyExecJS在复杂场景下的局限性及优化建议。
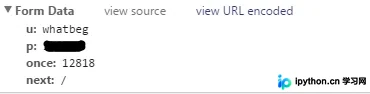
本文详细解析如何使用Python的requests.Session实现网站模拟登录。通过V2EX网站的登录流程为例,演示如何利用BeautifulSoup解析HTML获取动态参数(如once值),构建POST请求数据,并利用Session对象跨请求保持Cookie状态,最终验证登录成功。
本文详解Python爬虫中requests库发送POST请求的三种核心方式:Form表单、JSON数据及文件上传。通过httpbin.org测试接口,展示data与files参数的具体用法、Content-Type头部的自动处理及返回结果解析,帮助开发者掌握不同场景下的数据提交技巧。
本文详细解析Scrapy框架中items文件夹的标准工作流程。通过创建继承自scrapy.Item的结构化数据类,在Spider解析函数中提取并填充字段,最后经settings.py配置的Pipeline管道进行清洗或入库,可彻底告别松散字典传递,实现高效稳健的爬虫数据管理。
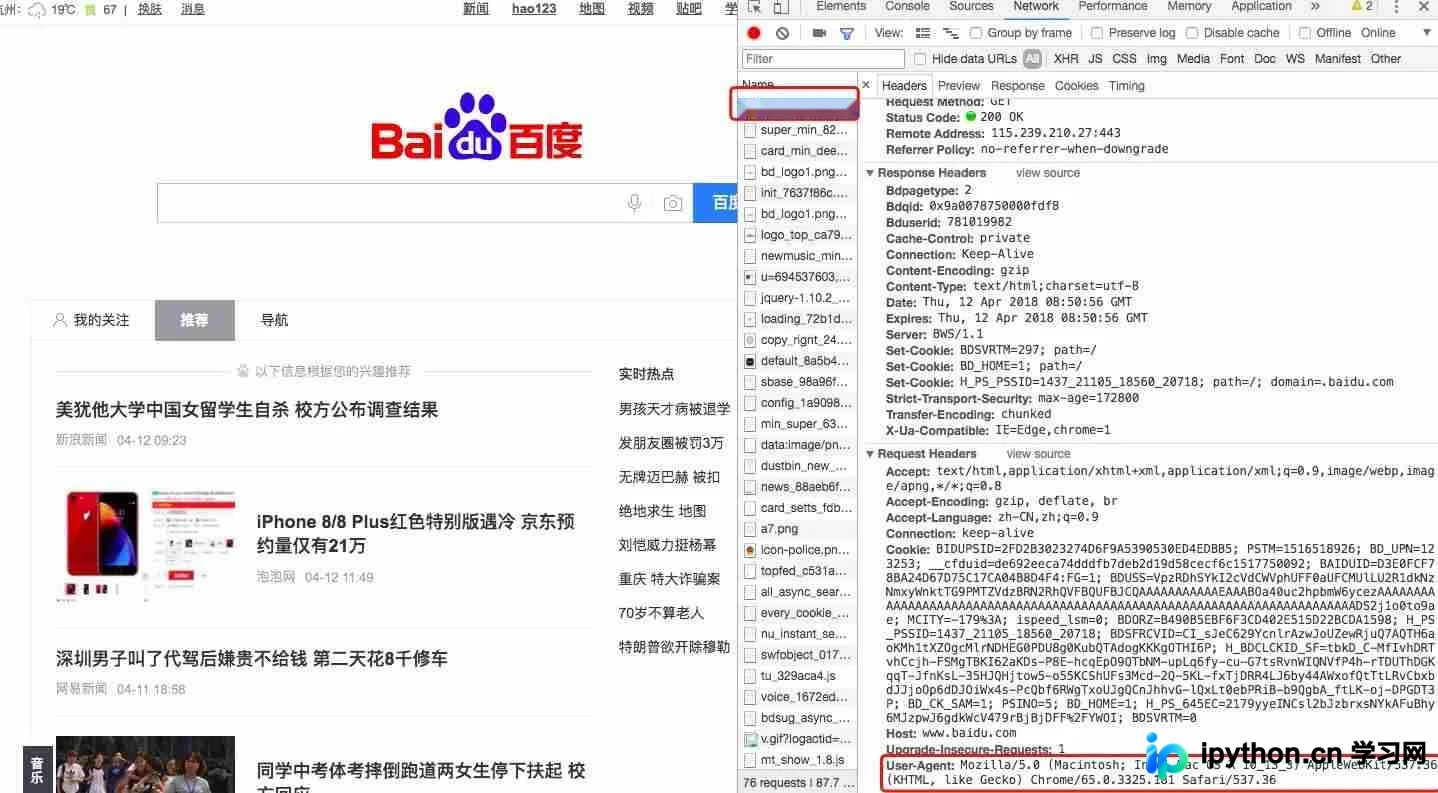
本文介绍如何利用Python的requests库通过伪装浏览器User-Agent来绕过网站的反爬机制。通过模拟真实浏览器的请求头(如Accept、Connection等),并随机切换User-Agent,可以有效防止IP被封禁,提高爬虫的稳定性和成功率。
教你使用 Python 的 requests 与 BeautifulSoup 编写第一个网页爬虫,步骤详尽,示例完整。