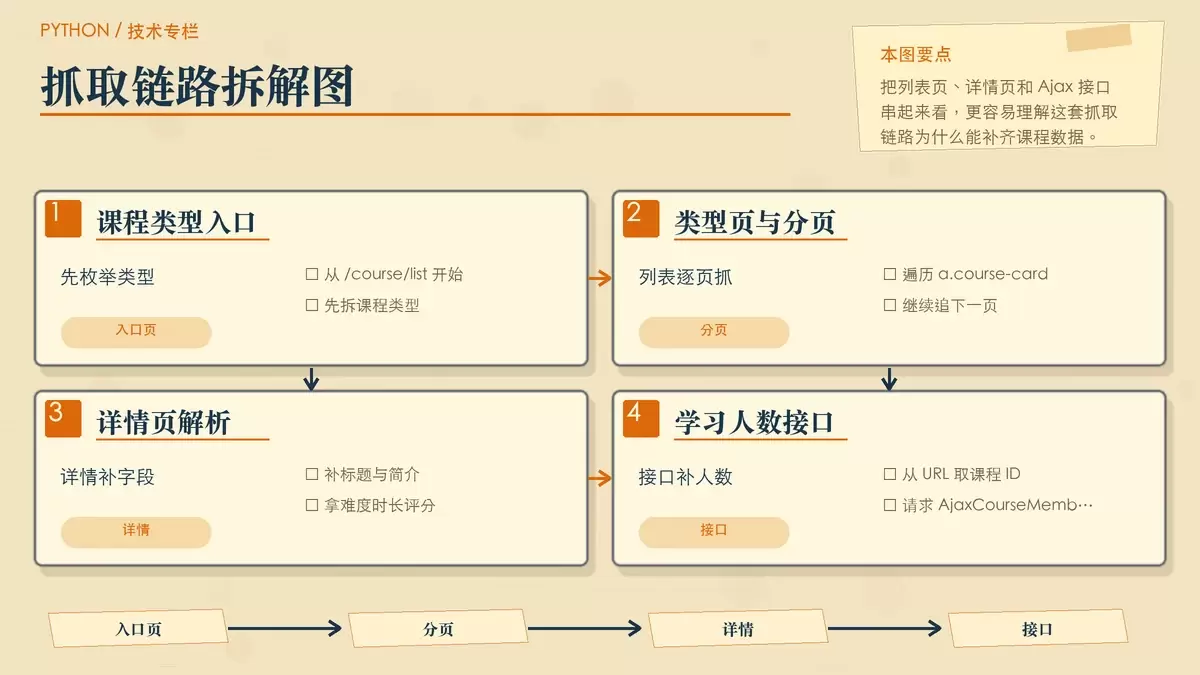
用 Scrapy 抓取慕课网全部免费课程:从分页采集到 MySQL 入库
这篇文章把一个抓取慕课网免费课程的 Scrapy 示例,整理成可直接复用的完整流程:从按课程类型翻页抓取,到进入详情页补齐难度、时长、评分,再通过接口拿到学习人数,最后异步写入 MySQL。代码事实、命令和表结构均保留,方便对照落地。
2026-08-25
201

这篇文章把一个抓取慕课网免费课程的 Scrapy 示例,整理成可直接复用的完整流程:从按课程类型翻页抓取,到进入详情页补齐难度、时长、评分,再通过接口拿到学习人数,最后异步写入 MySQL。代码事实、命令和表结构均保留,方便对照落地。
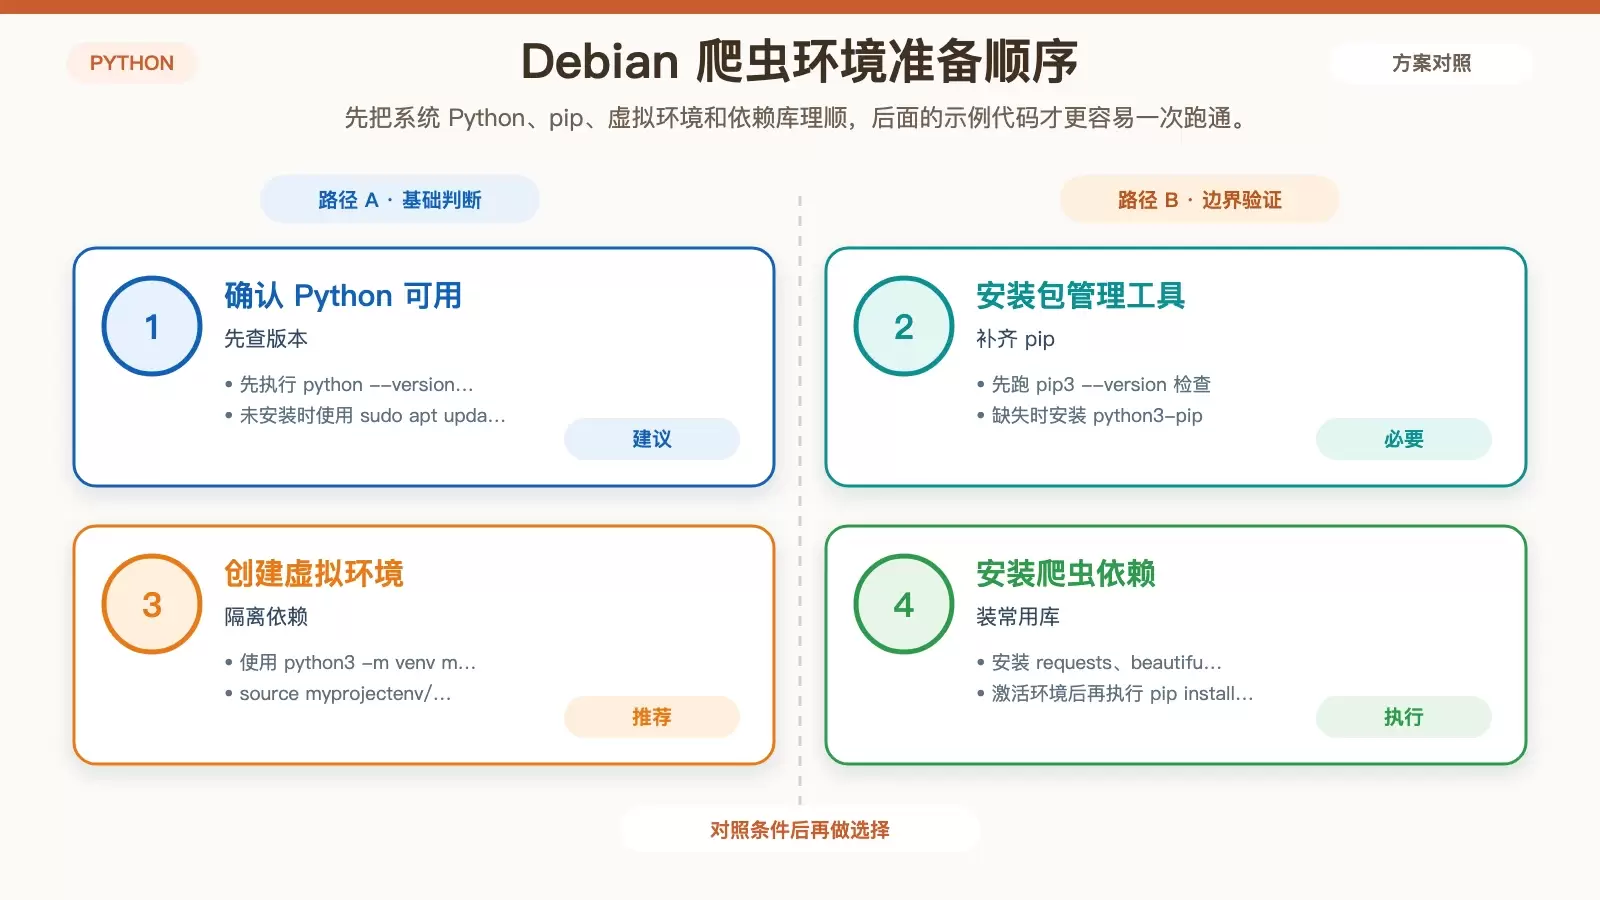
这篇文章把 Debian 上搭建 Python 爬虫的基础流程拆成可直接照做的几个环节:检查 Python、补齐 pip、创建虚拟环境、安装常用库、编写并运行示例程序,同时补上爬取礼仪和数据存储建议,适合刚开始在 Linux 环境里动手的人。
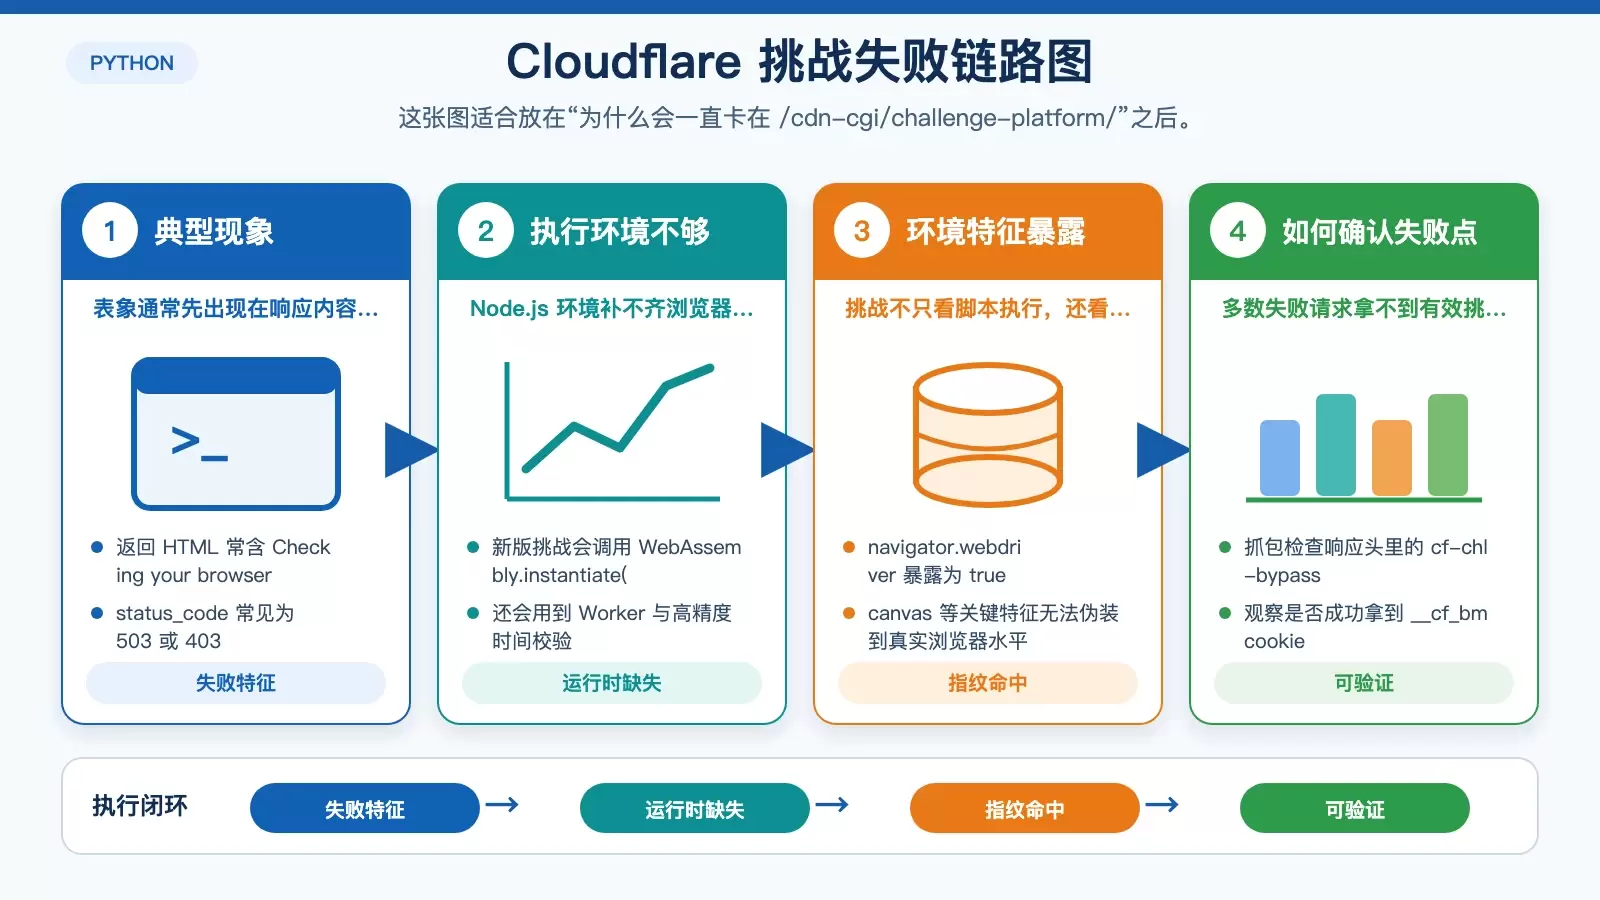
在当前主流 Cloudflare 防护下,`cloudscraper` 往往会卡在 `/cdn-cgi/challenge-platform/`,最终返回 `403/503`。问题不在于“请求没发出去”,而是新版 JS 挑战依赖 `WebAssembly`、时间校验和浏览器指纹,Node.js 模拟环境很难通过。能稳定跑通的方向,已经转向复用真实 Chromium 实例并尽量贴近人工访问行为。