

Python抓取同花顺业绩预告并可视化分析全流程
本文详解利用Python从同花顺财经抓取业绩预告数据的全过程。通过requests获取HTML源码,结合正则表达式提取股票代码、净利润及增长幅度,构建DataFrame进行数据清洗。最后使用Matplotlib绘制饼图,直观展示148家公司的盈利与亏损分布情况,为财务数据分析提供可视化参考。
2026-10-12
10

本文详解利用Python从同花顺财经抓取业绩预告数据的全过程。通过requests获取HTML源码,结合正则表达式提取股票代码、净利润及增长幅度,构建DataFrame进行数据清洗。最后使用Matplotlib绘制饼图,直观展示148家公司的盈利与亏损分布情况,为财务数据分析提供可视化参考。
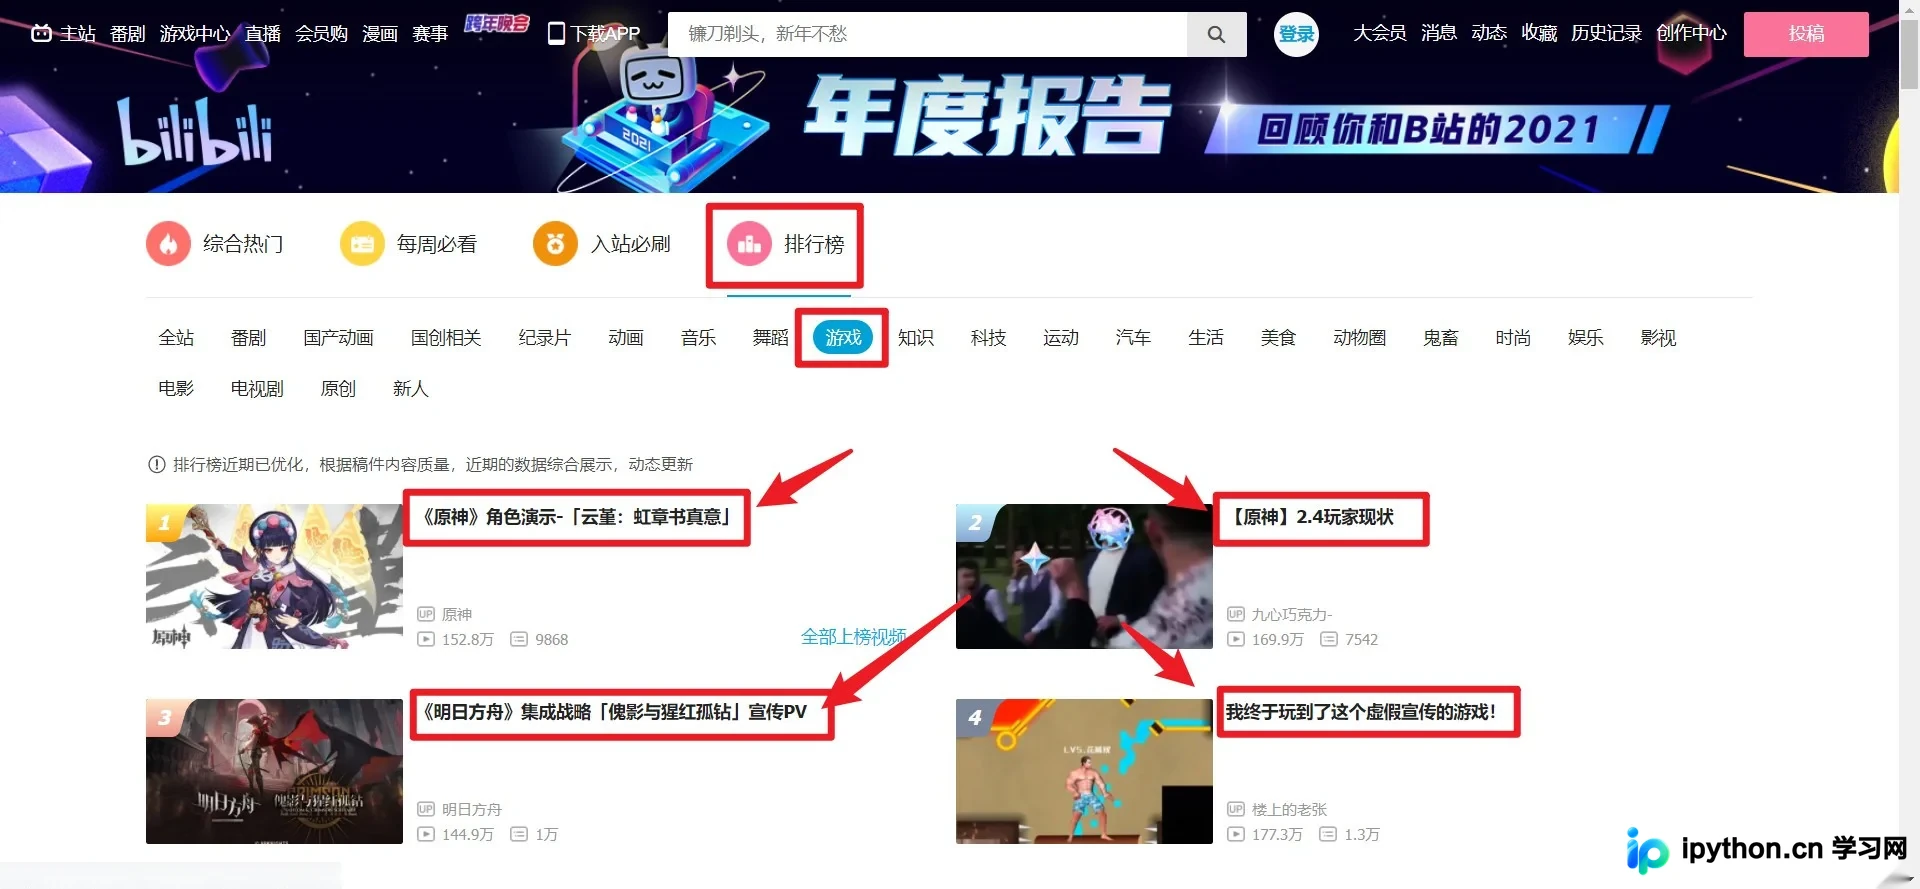
本文介绍如何使用Python的Requests和BeautifulSoup库,从Bilibili游戏排行榜页面抓取视频标题及对应链接。通过逐步优化代码,解决HTML解析、链接协议补全(http:)及数据提取问题,最终实现简洁高效的数据爬取,适合Python初学者参考学习。
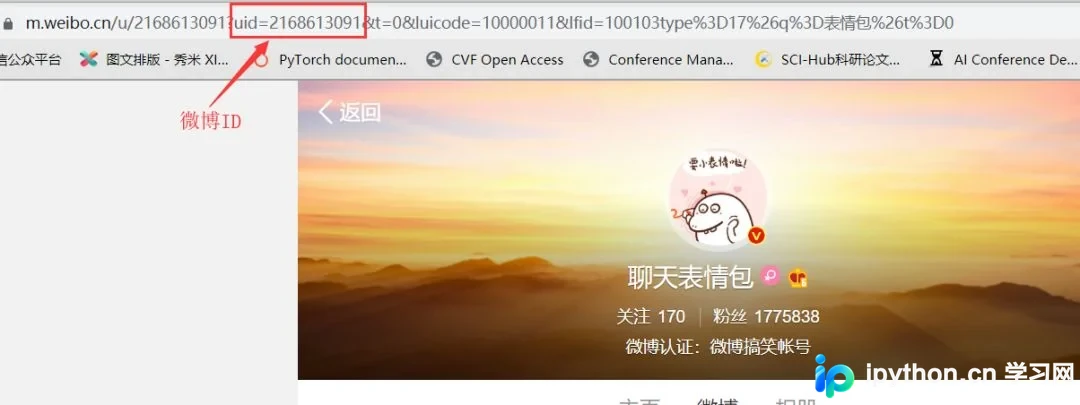
本文介绍使用Python 3.6.4通过DecryptLogin模块模拟登录微博,并抓取指定用户发布的表情包图片。文章详细讲解了环境搭建、异步爬取被封禁的教训、以及采用随机延迟和独立UA请求等反封禁策略。通过XPath提取用户信息及图片链接,并对HTTP链接错误进行后处理,最终实现稳定下载。
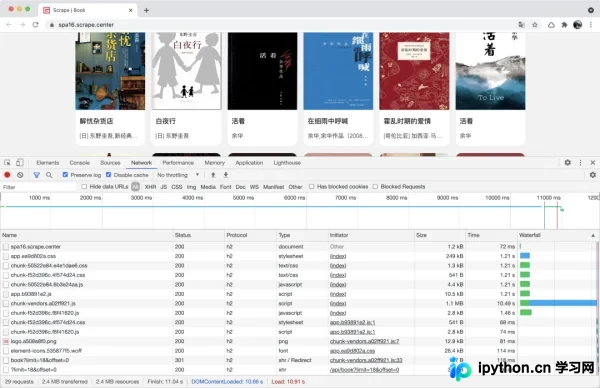
本文介绍一种基于强制HTTP/2.0协议的反爬虫策略。由于主流Python爬虫库如requests仅支持HTTP/1.1,且Scrapy的HTTP/2支持尚为实验性,通过Nginx配置拒绝HTTP/1.x请求可有效拦截大部分自动化脚本。文章详细演示了Nginx及Kubernetes Ingress的配置方法,并通过对比requests、Scrapy与httpx的测试结果,验证了该方案对常规爬虫的阻断效果及合法用户的兼容性。
本文详解如何在Scrapy框架中集成Selenium以解决动态加载数据的爬取难题。通过配置Spider与下载中间件,利用浏览器对象执行页面滚动并获取渲染后的HTML源码,成功抓取网易新闻多个版块的动态内容。文章提供了完整的代码实现、配置步骤及注意事项,帮助开发者高效处理复杂动态网页。
本文详细介绍如何利用Python的urllib.request库实现贝壳找房房源数据的自动化爬取。教程涵盖请求库引入、URL构建、随机代理IP配置及反爬策略(如随机休眠),并通过完整代码示例演示如何批量保存不同城市的多页网页数据,为后续大数据分析提供数据源。
本文详细讲解在Python中如何为数据添加标签、根据条件判断标签值以及从HTML结构中获取特定标签内容。通过Pandas的merge与apply方法实现复杂逻辑打标,并结合lxml库利用XPath表达式精准提取网页元素属性,适用于数据分析和网络爬虫场景。
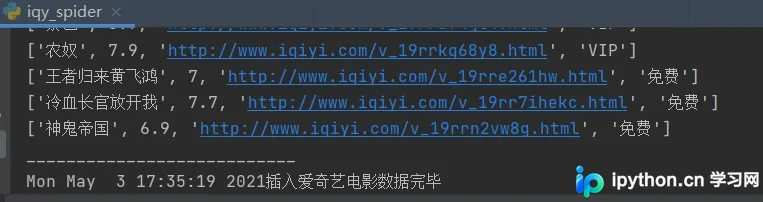
本文详细介绍使用Python爬取爱奇艺电影片库首页数据的完整流程。通过Requests获取HTML,结合Lxml和BeautifulSoup解析电影标题、评分及链接等关键信息。代码示例展示了如何连接MySQL数据库,将抓取到的电影数据批量插入数据库,并包含异常处理与事务提交机制,为影视数据抓取与存储提供实用参考。
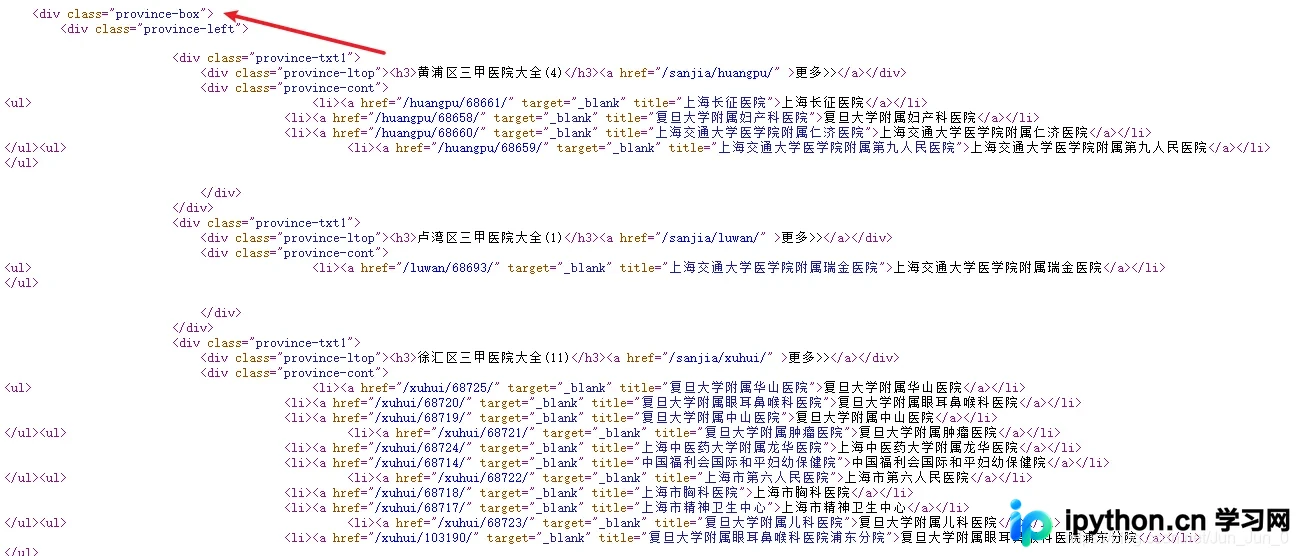
本文详解如何使用Python正则表达式进行网页数据抓取。通过解析上海三甲医院网站源码,演示了利用re模块进行一级和二级过滤以提取医院名称的方法,并展示了如何编写正则表达式从HTML中提取图片URL。包含完整的Python代码示例、正则匹配逻辑分析及运行结果展示,帮助读者掌握文本与图片的批量爬取技巧。
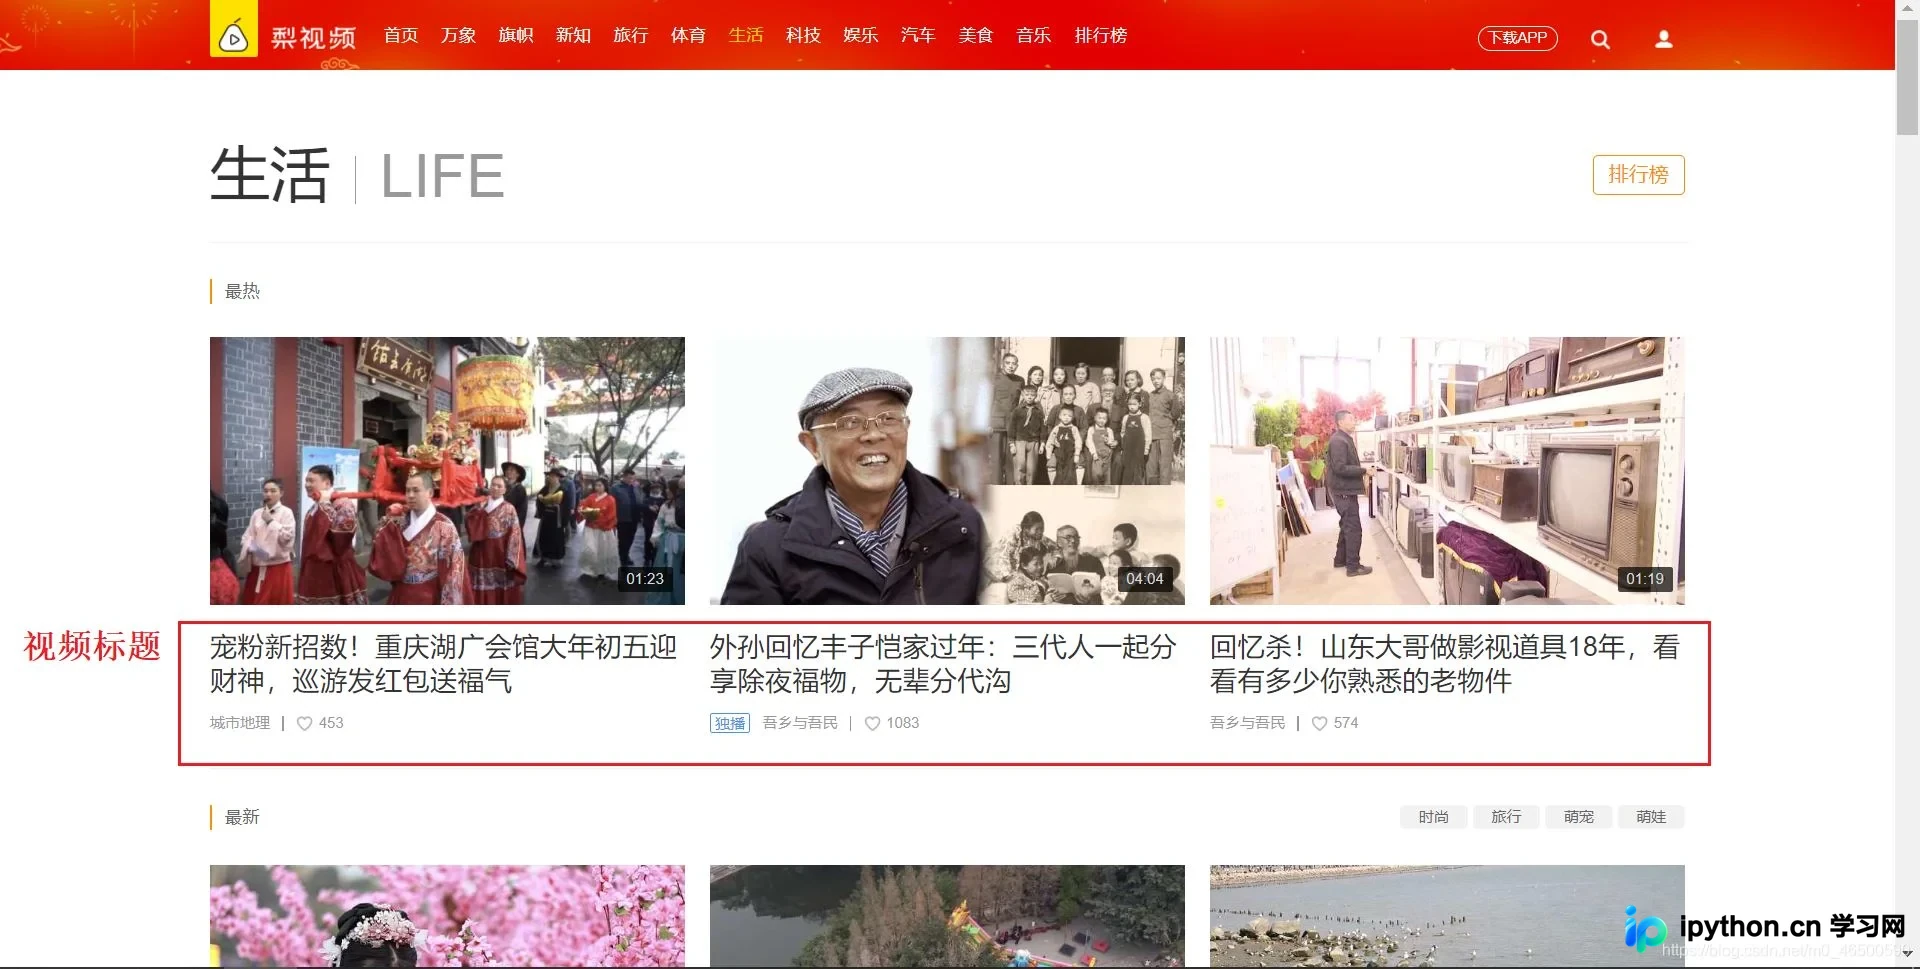
本文基于Scrapy框架解析梨视频网站的数据抓取流程。针对视频标题与描述分属不同页面的特点,通过自定义parse方法与meta参数传递Item对象,实现跨页面数据解析。结合items定义字段与pipeline管道类,完成数据的清洗、持久化存储及多管道优先级处理,提供完整的代码示例与配置说明。
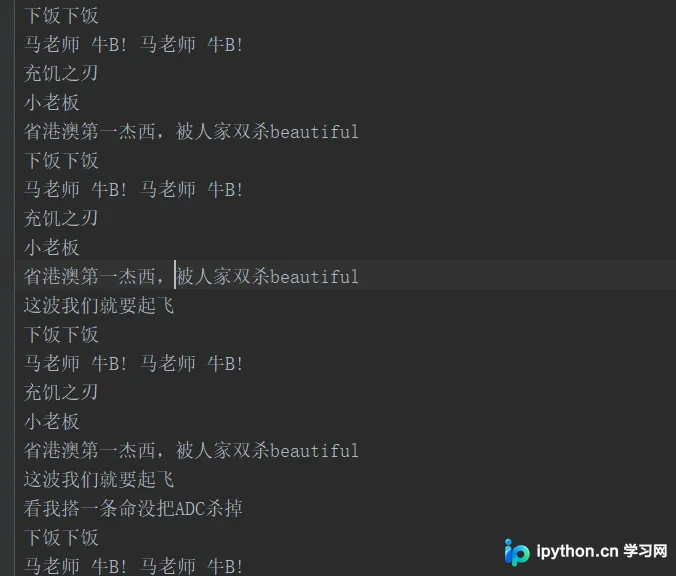
本文介绍使用Python Selenium库抓取斗鱼直播间弹幕的方法。通过配置Chrome无界面模式并优化加载策略,脚本可自动进入指定房间,循环提取弹幕文本并保存至txt文件。文章提供了完整的代码示例及运行效果截图,适合需要简单获取直播互动数据的开发者参考。
本文详解如何利用Python构造__jsluid_h和__jsl_clearance字段以应对网站反爬机制。通过分析JS混淆脚本,复现__jsl_clearance的生成逻辑,并结合Js2Py获取Cookie,实现自动化的请求头构造,有效解决因Cookie频繁过期导致的爬虫中断问题。
