PyCharm集成Scrapy:从环境搭建到项目初始化的完整指南
本文详细讲解如何在Python环境中安装Scrapy爬虫框架,并介绍如何利用PyCharm完成项目的初始化与Spider创建。内容涵盖使用国内豆瓣源解决安装慢的问题、验证安装版本、通过命令行创建项目结构以及在IDE中生成Spider模板的完整操作流程,帮助开发者快速上手Scrapy开发。
2026-10-13
6

本文详细讲解如何在Python环境中安装Scrapy爬虫框架,并介绍如何利用PyCharm完成项目的初始化与Spider创建。内容涵盖使用国内豆瓣源解决安装慢的问题、验证安装版本、通过命令行创建项目结构以及在IDE中生成Spider模板的完整操作流程,帮助开发者快速上手Scrapy开发。
本文介绍如何利用Python的BeautifulSoup库批量从城市美食及景点介绍等HTML页面中提取body标签内的具体内容。通过遍历目录结构并解析文件,实现自动化数据抓取与存储,为后续数据处理提供基础。
本文介绍如何使用Python爬虫结合百度地图API,通过小区名称获取经纬度,再反向解析为结构化地址。代码支持传入DataFrame批量处理,并优化了含“号”的小区名称精度,提高数据获取效率。
本文介绍Python中利用urllib和http.cookiejar模块保存Cookie到变量或文件,以及从文件读取Cookie并发起请求的方法。通过MozillaCookieJar实现持久化存储,适用于爬虫场景中的会话保持。
本文介绍在Python3中如何利用urllib库携带Cookie信息访问受保护网页。通过构建包含Cookie字段的headers字典,并创建Request对象,可实现模拟登录后的数据抓取。文章提供了完整的代码示例,展示如何设置请求头、发起HTTP请求并将响应内容保存至本地文件,适用于需要身份验证的爬虫场景。
本文详解Python中模拟登录的两种主要方式:直接复制浏览器Cookie与使用Session维持会话。重点解析为何普通请求无法保持登录状态,并通过代码示例展示如何利用requests.Session对象自动管理Cookie,实现跨请求的身份验证与数据获取,解决多页面交互中的会话断开问题。
本文介绍利用Python编写爬虫程序,自动从指定网站批量抓取动态GIF图片的方法。通过解析HTML页面获取图片链接,并实现多页循环下载与本地存储,解决手动保存繁琐及部分网站禁止右键的问题。
本文介绍如何使用Python 2.7编写程序,从北大未名BBS抓取十大热门帖子标题,并利用百度语音合成API将文本转换为音频文件进行自动播报。文章提供了完整的抓取模块代码、语音合成入口脚本及配置文件示例,详细说明了Token获取与音频播放的实现细节,适用于Windows和Linux系统。
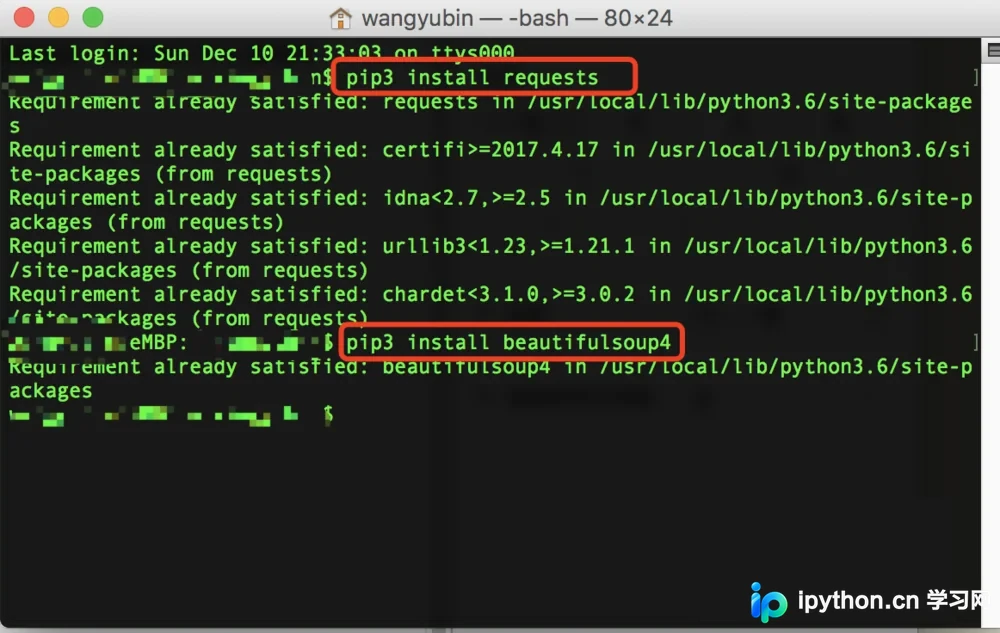
本文详细介绍如何使用Python编写爬虫程序抓取新浪新闻。通过安装requests和bs4库,模拟浏览器请求获取原始数据,并解决常见的乱码问题。接着利用浏览器开发者工具定位HTML标签,结合BeautifulSoup解析提取新闻标题、发布时间及链接,最终实现结构化数据的自动采集。
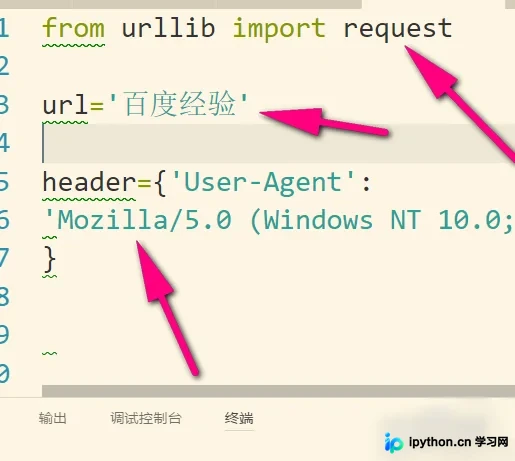
本文详解Python3爬虫中请求头Header的构建方法。通过浏览器开发者工具Network面板提取User-Agent,结合Request类构造GET或POST请求,并演示使用urlopen发送请求的完整流程,帮助开发者有效伪装浏览器身份。
本文详解Python爬虫中如何使用代理IP防止IP被封。通过urllib.request的ProxyHandler构建自定义opener,并调用install_opener设置全局代理,使urlopen默认使用代理IP。文中涵盖HTTP/HTTPS代理设置、端口配置及常见连接拒绝错误的排查方法,帮助开发者实现稳定的数据抓取。
本文详细介绍如何使用Python构建基础爬虫架构。通过解析urllib库的网络请求功能与BeautifulSoup的HTML解析能力,演示从导入模块、打开网址到提取节点信息的完整流程。同时涵盖常见错误如HTTPError和None值的排查与处理,帮助开发者掌握基础爬虫的核心步骤与异常处理机制。