

Python爬取微信小程序数据:基于Charles抓包的完整配置与实现指南
本文详细记录了使用Charles工具抓取微信小程序数据并配合Python进行解析的全过程。内容涵盖Windows与iPhone的网络环境配置、Charles代理安装、SSL证书在电脑及iOS设备上的正确部署方法,以及针对证书信任失败、网络不通等常见问题的排查方案。通过获取接口URL及参数,可直接利用Python爬虫获取JSON数据,为移动端小程序数据分析提供有效技术手段。
2026-10-14
8

本文详细记录了使用Charles工具抓取微信小程序数据并配合Python进行解析的全过程。内容涵盖Windows与iPhone的网络环境配置、Charles代理安装、SSL证书在电脑及iOS设备上的正确部署方法,以及针对证书信任失败、网络不通等常见问题的排查方案。通过获取接口URL及参数,可直接利用Python爬虫获取JSON数据,为移动端小程序数据分析提供有效技术手段。
本文介绍在 Python 中如何通过字典的值查找对应的键。主要涵盖两种场景:一是通过自定义函数遍历字典,返回所有匹配指定值的键集合;二是利用内置函数 max 结合 key 参数,高效获取具有最大值的键。此外,还列举了列表推导式、索引映射及字典反转等具体代码实现方式,帮助开发者灵活应对不同需求。
本文介绍在Python中如何让一个字典键对应多个值。通过dict.setdefault方法,可将值存储为列表或嵌套字典。示例展示了使用append向列表追加元素,以及使用update向嵌套字典添加键值对的操作过程与结果。
本文介绍如何利用Python的python-docx库自动化处理杂乱的Word题库文档。通过遍历段落、识别特定字符(如序号后的点号、选项符号)及过滤无效行,实现自动删除多余空白、修正错误题号、合并选项行及移除“窗体顶端/底端”等冗余内容,最终生成格式规范的标准化文档。
本文介绍使用Python实现图书馆座位自动预约的脚本逻辑。通过F12分析登录与预约接口,利用requests.session保持会话状态。核心优化包括定时在系统开放时发送请求以减轻服务器压力,以及处理撞车情况下的自动顺延策略。代码仅供参考,旨在提供同类系统的开发思路。
本文介绍了如何在Python和Node.js环境中生成当前时间戳。通过示例代码展示了如何格式化输出年月日时分秒,以及如何获取毫秒级时间戳。同时,文章提供了命令行参数处理逻辑,支持按指定次数批量生成递增的时间戳数据,适用于脚本自动化测试或日志生成场景。
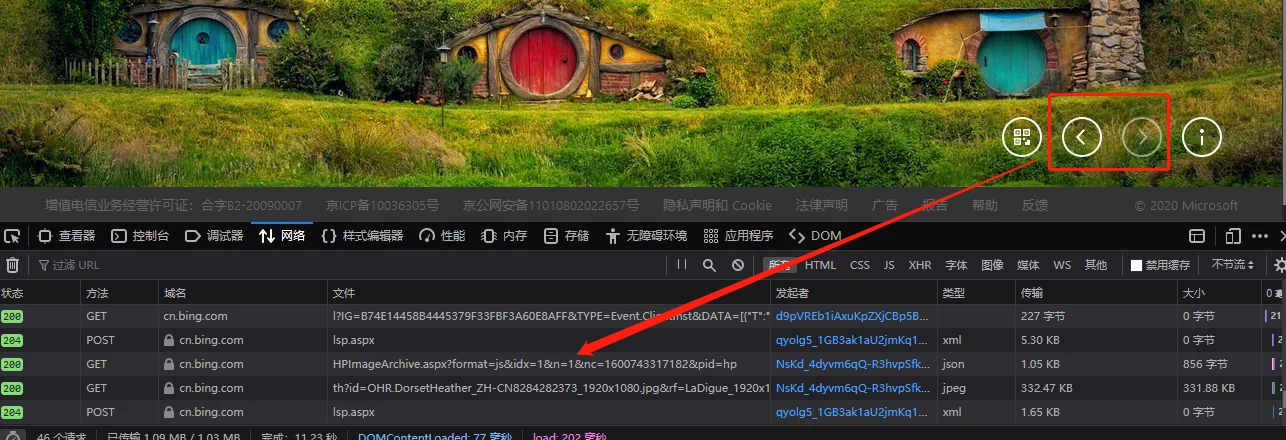
本文介绍如何使用 Python 的 requests 库调用 Bing 官网提供的图片接口,自动获取并下载每日高清壁纸。文章详细解析了接口参数含义,提供了完整的代码示例,包括请求构造、JSON 数据解析及图片保存逻辑,并提及了官方 Windows 应用作为替代方案。
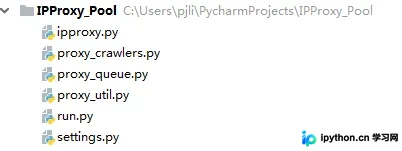
本文详细介绍Python爬虫代理池的搭建流程。针对IP访问频率限制问题,提出通过代理池轮询IP的解决方案。涵盖从代理网站抓取、可用性验证、Redis存储到队列管理的完整代码实现,包含IPProxy类、配置管理及多爬虫基类设计,并提供测试与GitHub源码地址。
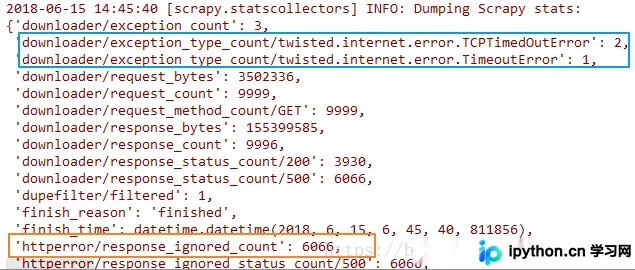
本文详解Scrapy中处理下载错误的两种主要场景:HTTP状态码异常(如403/500)与代码执行异常。通过深入分析RetryMiddleware源码,揭示process_response与process_exception的工作机制,并提供一个自定义中间件模板,用于兜底捕获未重试成功的请求,确保爬虫在长时间运行时的稳定性与数据完整性。
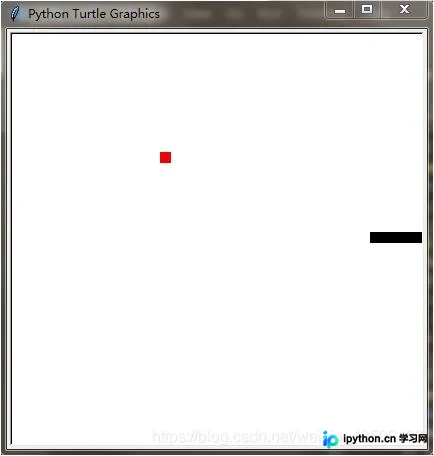
本文提供基于Python Turtle库的贪吃蛇游戏完整实现代码。通过定义蛇身坐标、苹果随机位置及方向控制函数,利用ontimer实现游戏循环。代码涵盖键盘监听、碰撞检测及绘图逻辑,适合Python初学者参考学习经典游戏开发流程。
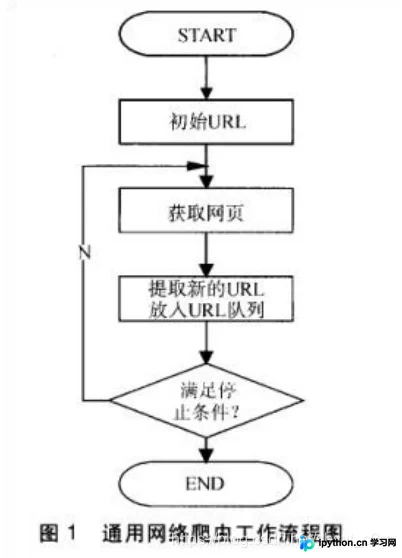
本文深入解析Python网络爬虫的两大核心类型:通用爬虫与聚焦爬虫。详细阐述通用爬虫在搜索引擎中的工作流程,包括种子URL选取、页面抓取、数据存储及预处理(分词、索引构建)等关键步骤,并探讨Robots协议的作用与局限性。同时,介绍聚焦爬虫如何通过主题筛选算法实现精准数据采集,对比两者在覆盖率、资源消耗及应用场景上的差异,并简述常见的反爬虫手段如IP限制与数据投毒,为开发者提供全面的技术参考。
本文详解Scrapy中向Spider传递参数的两种主流方法。第一种通过命令行crawl命令的-a选项传入参数,并在Spider构造函数中接收;第二种通过scrapyd调度schedule.json接口使用-d选项添加参数。此外,还介绍了利用Request的meta属性在页面解析间传递数据的技巧,帮助开发者灵活控制爬虫行为。