Python 中如何根据字典的值反向查询对应的键
本文详解在 Python 中如何根据字典的值反向查询对应的键。由于字典的值可能不唯一,查询结果通常返回包含所有匹配键的列表;而键具有唯一性,可直接获取对应值。文章通过具体代码示例展示了使用 filter 函数进行反向查找的实现方式,帮助开发者快速掌握字典操作技巧。
2026-10-14
8

本文详解在 Python 中如何根据字典的值反向查询对应的键。由于字典的值可能不唯一,查询结果通常返回包含所有匹配键的列表;而键具有唯一性,可直接获取对应值。文章通过具体代码示例展示了使用 filter 函数进行反向查找的实现方式,帮助开发者快速掌握字典操作技巧。
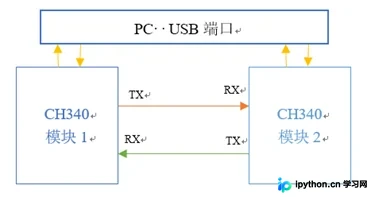
本文详解Python串口通信实现,涵盖pyserial模块安装、基础读写操作、十六进制处理及多线程封装方案。通过CH340模块示例,展示波特率配置、超时设置及异常处理,提供完整代码片段与常用API参考,助力开发者快速掌握串口调试技巧。
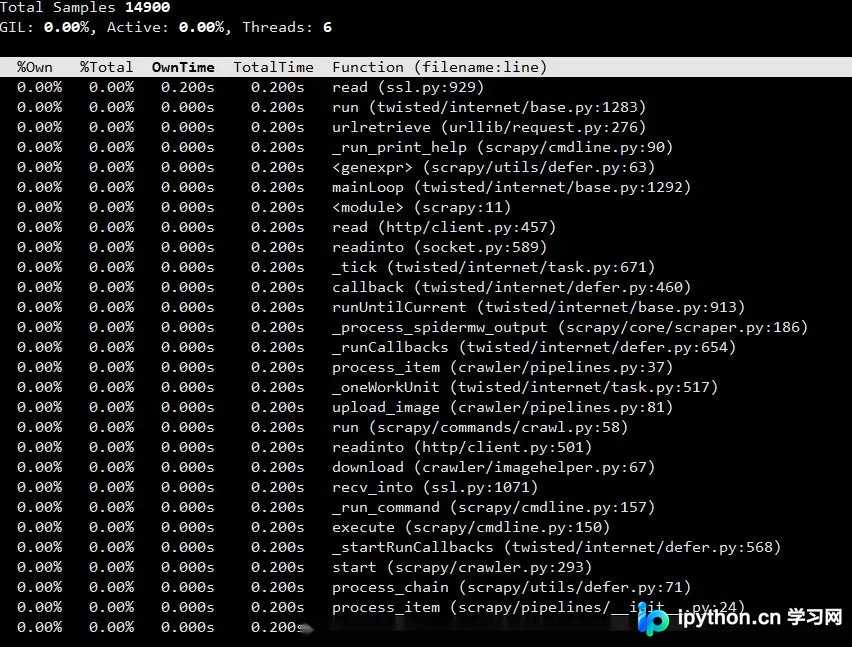
本文介绍如何使用py-spy工具排查Scrapy爬虫因网络IO导致的进程卡死问题。通过定位耗时函数发现urllib.urlretrieve缺乏超时参数,进而封装支持timeout的urlopen方法,有效解决爬虫进程堆积和数据延迟问题。
本文介绍在 Python 中删除空文件夹的两种常用方法。第一种基于递归遍历,深度检查子目录并清理空路径;第二种利用 os.walk 遍历目录树,尝试删除子目录并捕获非空异常。通过具体代码示例展示如何实现自动清理空目录,适用于批量整理文件场景。
本文详解如何在Python中调用百度识图API。首先指导用户前往百度智能云注册并获取AK和SK密钥,随后提供完整的Python代码模板,涵盖Token获取、图片Base64编码及API请求流程,帮助开发者快速实现图像识别功能。
本文深入解析Python中对象间的交互机制与组合用法。通过定义人类与狗类的交互示例,展示对象间如何相互调用方法。重点讲解组合模式,即在一个类中嵌入另一个类的实例作为属性,以圆环计算和教师信息为例,阐明“has-a”关系在代码复用与设计中的应用。
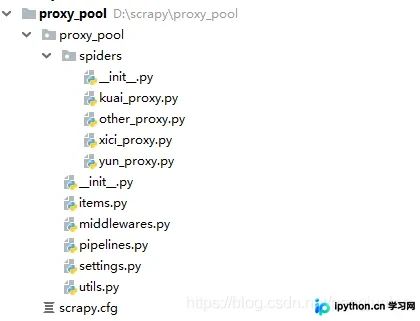
本文详细介绍如何使用Scrapy-Redis框架搭建高效的IP代理池。内容涵盖从快代理等网站批量爬取IP、通过请求验证IP可用性,以及利用Redis存储和管理代理池的完整流程。相比传统requests方案,该方法能显著提升爬取速度并解决高频访问限制问题,适合需要大规模数据采集的场景。
本文详解Python PIL模块的三大核心应用:通过convert('L')与point方法实现图像黑白化及阈值处理;利用像素遍历算法计算小图在大图中的精确坐标;以及使用ImageGrab模块进行全屏或指定区域的屏幕截图。涵盖关键参数设置与代码实现,适用于图像识别与自动化测试场景。
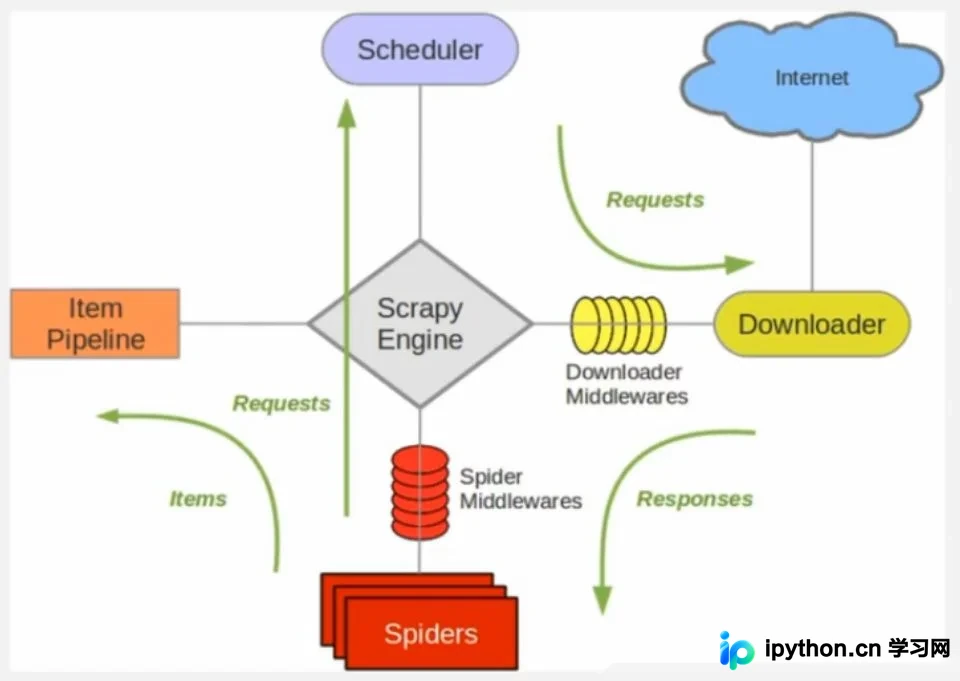
本文深入解析Scrapy-Redis分布式爬虫的核心原理与搭建流程。通过对比Scrapy与Scrapy-Redis的架构图,详细阐述Master端与Slaver端的协作机制,包括URL指纹判重、Request分配及数据存储策略。同时提供从环境配置、依赖安装到代码编写的完整实操指南,帮助开发者高效构建高性能分布式数据采集系统。
本文深入解析Python中的字典嵌套技术,涵盖三种核心场景:在列表中存储多个字典、在字典中存储列表作为值,以及在字典中嵌套其他字典。通过外星人数据、煎饼果子配料及用户信息管理的具体代码示例,展示如何处理复杂数据结构,帮助开发者掌握高效的数据组织与遍历方法。
本文详细解析在 Python 中创建守护进程(Daemon)的方法与核心原理。通过两次 Fork 机制、会话组管理、文件描述符重定向及权限掩码设置,实现服务脱离终端控制并常驻后台。文章提供完整 Python 代码示例,并深入剖析守护进程与后台进程的区别,帮助开发者构建稳定的 Linux 后台服务。
本文详细介绍如何利用scrapy_redis库将Scrapy爬虫升级为分布式架构。内容涵盖环境准备、Settings配置修改、Spider类重写以及Redis数据源注入等关键步骤,帮助开发者实现多台服务器共享URL去重与数据存储,提升爬取效率。