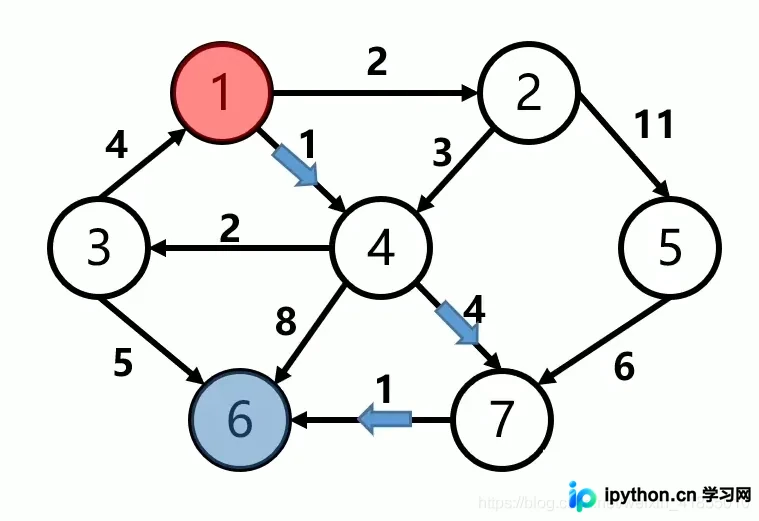
Python实现Dijkstra算法与A*改进:机器人路径规划详解
本文详细介绍如何使用Python实现Dijkstra算法进行机器人路径规划,涵盖算法原理、集合操作及代码实现。同时对比分析A*算法通过引入启发式函数优化搜索效率的方法,结合PythonRobotics项目源码,提供从理论到实践的完整路径规划解决方案。
2026-10-15
7

本文详细介绍如何使用Python实现Dijkstra算法进行机器人路径规划,涵盖算法原理、集合操作及代码实现。同时对比分析A*算法通过引入启发式函数优化搜索效率的方法,结合PythonRobotics项目源码,提供从理论到实践的完整路径规划解决方案。
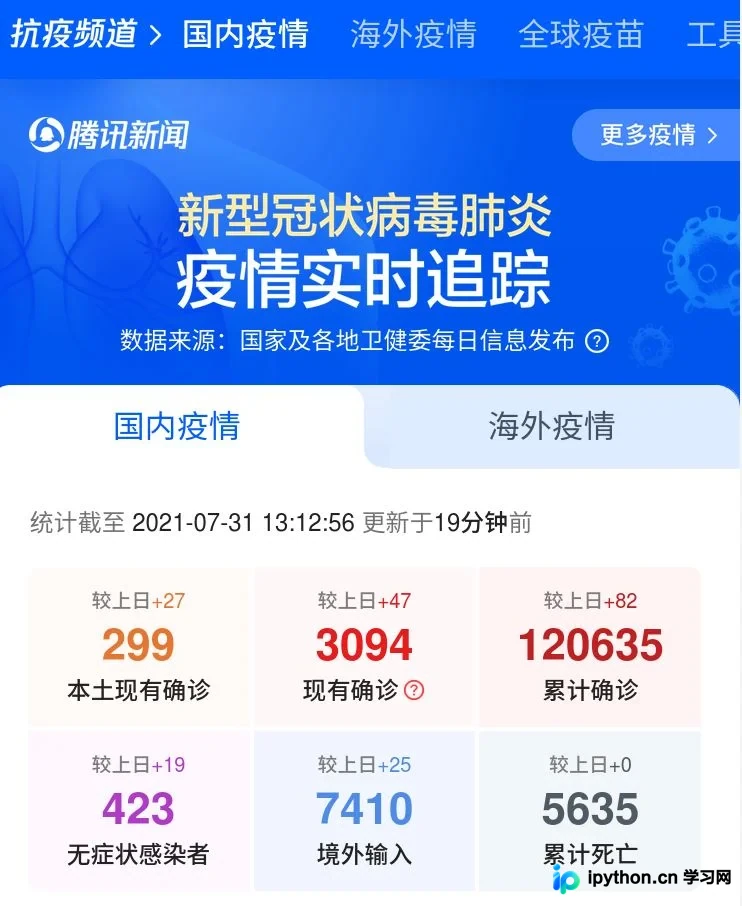
本文介绍如何使用Python的requests库抓取腾讯新闻疫情实时数据接口,并通过json解析提取全国及江苏省各地级市的确诊、新增及治愈数据。结合PrettyTable美化输出,最后利用matplotlib库对江苏各地市疫情分布进行可视化分析,直观展示扬州等地疫情状况。
本文详解利用Python Num库进行灰度图像压缩的核心原理。通过引入奇异值分解(SVD)概念,解释如何提取矩阵主要特征以大幅减少数据量。文章包含SVD数学定义、NumPy中linalg.svd函数的调用方法及具体的图像压缩代码实例,帮助开发者理解并应用矩阵近似技术优化图像处理效率。
本文详细解析Python中urllib标准库与第三方库urllib3的区别。urllib包含request、parse、error和robotparser四个模块,适用于基础网络请求。urllib3功能更强大,支持连接池、线程安全、代理及SSL验证。文章通过代码示例对比两者在GET/POST请求、Cookie处理、代理设置、文件上传及超时处理上的具体用法,帮助开发者根据需求选择合适的库。
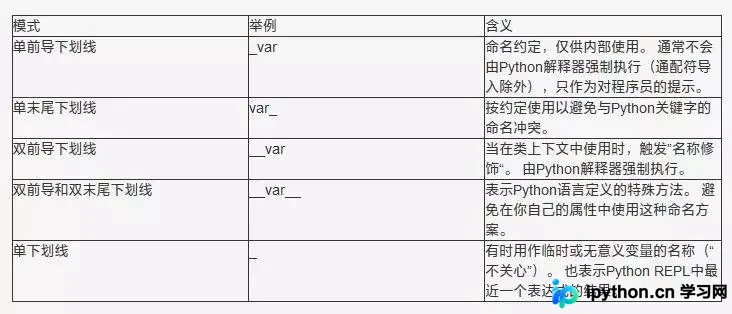
本文深入解析Python中单下划线和双下划线的5种命名约定。涵盖单前导下划线(_var)的内部使用提示、单尾下划线(var_)避免关键字冲突、双前导下划线(__var)的名称修饰机制,以及双前后下划线(_var_)的特殊方法保留。通过具体代码示例说明其对导入行为和子类继承的影响,帮助开发者规范代码风格并避免命名冲突。
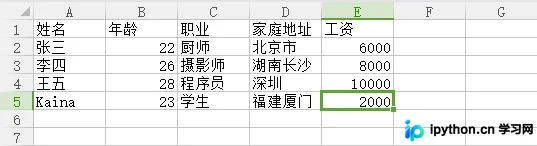
本文详细介绍Python中操作CSV文件的两种主要方式:内置csv库与第三方pandas库。涵盖读取表头、指定列、写入数据、统计分析及文件复制等常见操作,并提供具体代码示例与参数说明,帮助开发者高效处理表格数据。
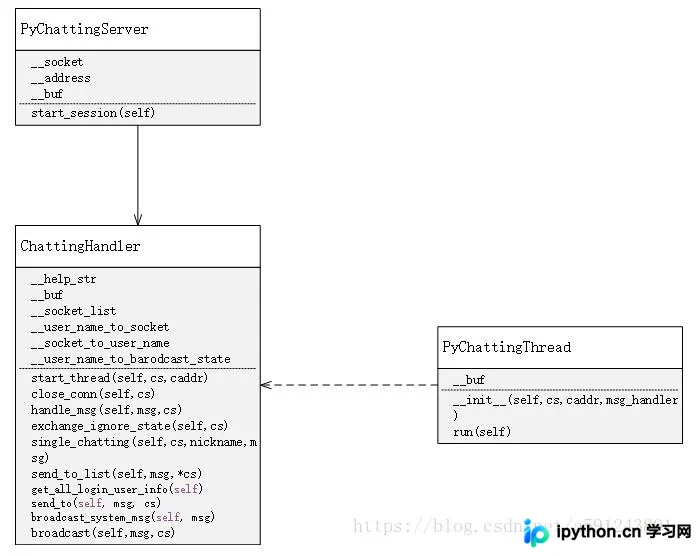
本文介绍使用Python socket模块结合多线程技术实现一个基于TCP协议的C/S架构聊天室。服务端通过独立线程管理每个客户端连接并分发消息,客户端采用收发分离的双线程机制避免阻塞。支持群聊与私聊功能,协议基于JSON字符串,代码包含完整的服务器与客户端实现逻辑。
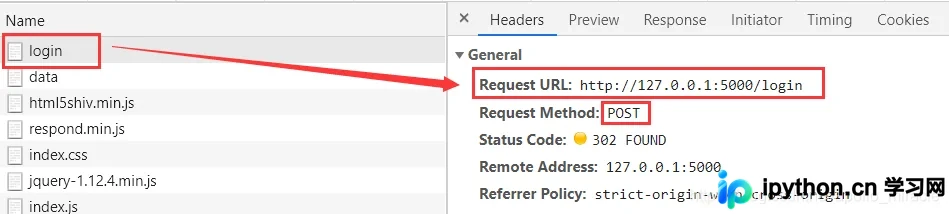
本文详解Python如何使用requests库通过HTTP协议上传文件。重点解析登录保持Session、利用fiddler抓包分析请求参数,以及data与files参数的配合使用。特别强调在上传文件时,headers中严禁手动指定Content-Type,需交由requests库自动生成,否则会导致上传失败。
本文深入解析Python中列表拼接与去重的三种常用方法。拼接方面,对比了“+”运算符、切片赋值及extend()方法的内存行为与性能差异;去重方面,介绍了利用集合set、字典键不可重复特性及index()索引判断的实现逻辑。通过代码示例与内存ID分析,帮助开发者根据场景选择最优方案。
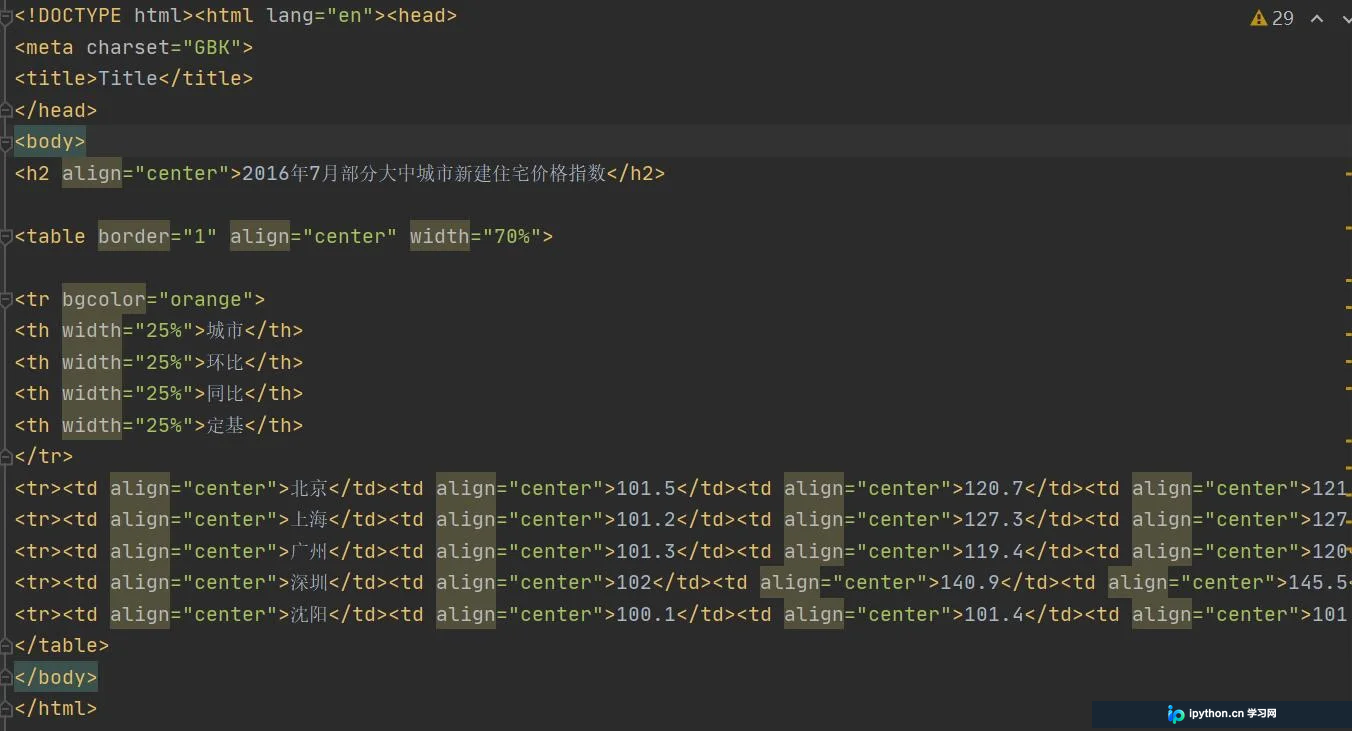
本文介绍如何使用Python将CSV文件转换为HTML文件。首先解析CSV文件格式,然后读取CSV数据,最后生成对应的HTML表格。
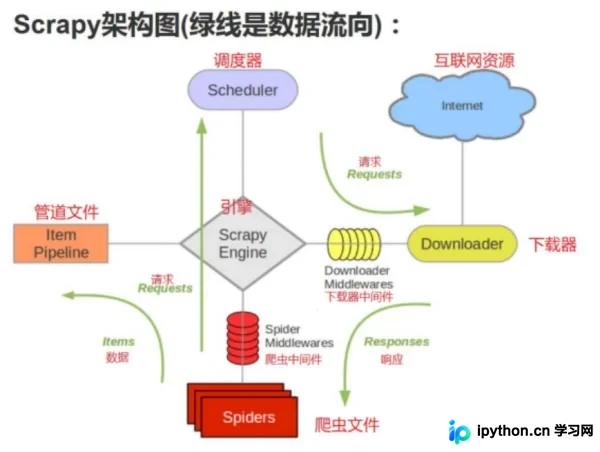
本文深入解析Scrapy爬虫框架的核心结构,详细阐述引擎、调度器、下载器、蜘蛛及管道等关键组件的功能与交互机制。通过梳理项目目录结构与数据流动路径,帮助开发者理解Scrapy为何被视为完整框架而非简单库,并掌握其高效处理网络请求与数据提取的工作原理。
本文详解Python代码的基本规范,包括文件扩展名、大小写敏感、缩进要求及换行符使用。重点介绍单行与多行注释的语法、注意事项及快捷键操作,结合PEP 8标准提升代码可读性与维护性。