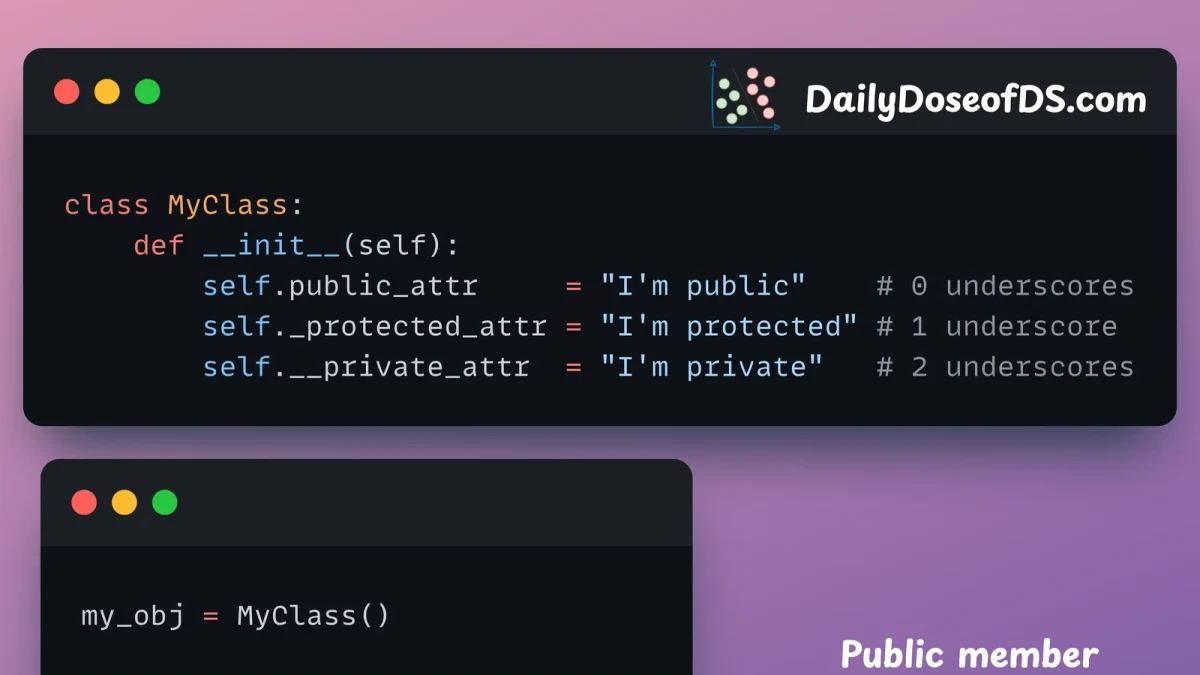
变量名前加单下划线在Python下划线命名中含义
在Python中,变量名前的单下划线(如 _name)主要用于表达“内部使用”或“非公开API”的命名意图,但它并不会真正阻止变量被访问。理解其语义、作用范围以及与双下划线的区别,有助于写出更规范、易维护的Python代码。
2026-09-08
25

在Python中,变量名前的单下划线(如 _name)主要用于表达“内部使用”或“非公开API”的命名意图,但它并不会真正阻止变量被访问。理解其语义、作用范围以及与双下划线的区别,有助于写出更规范、易维护的Python代码。
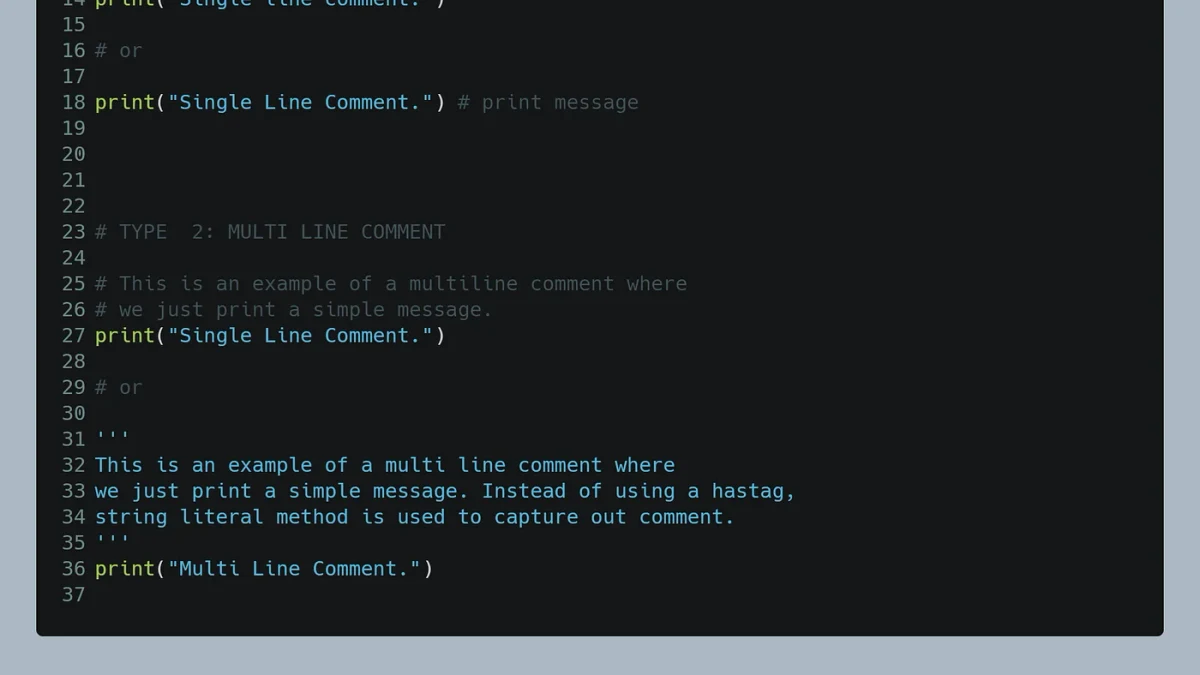
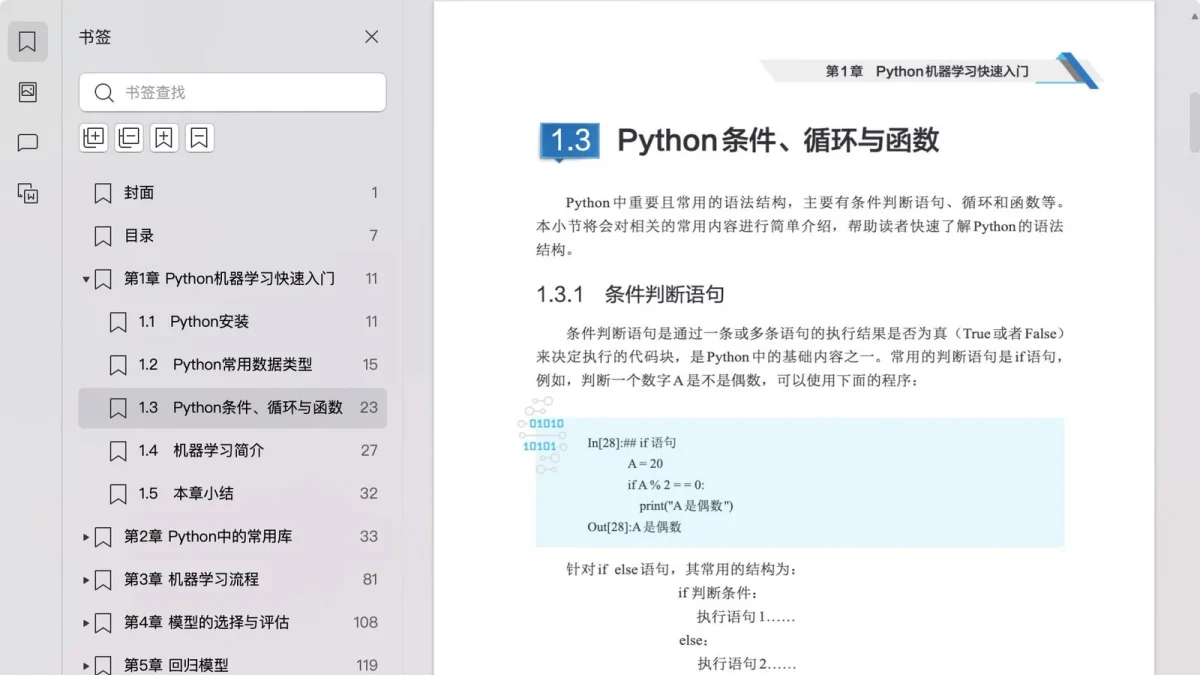
电子书的内容质量固然重要,但清晰目录、合理层级、代码排版和检索体验同样会直接影响Python学习效率。本文从目录结构、版式与代码展示、阅读与检索体验、资源获取与避坑几个方面,帮助读者筛选真正适合长期使用的Python电子书。
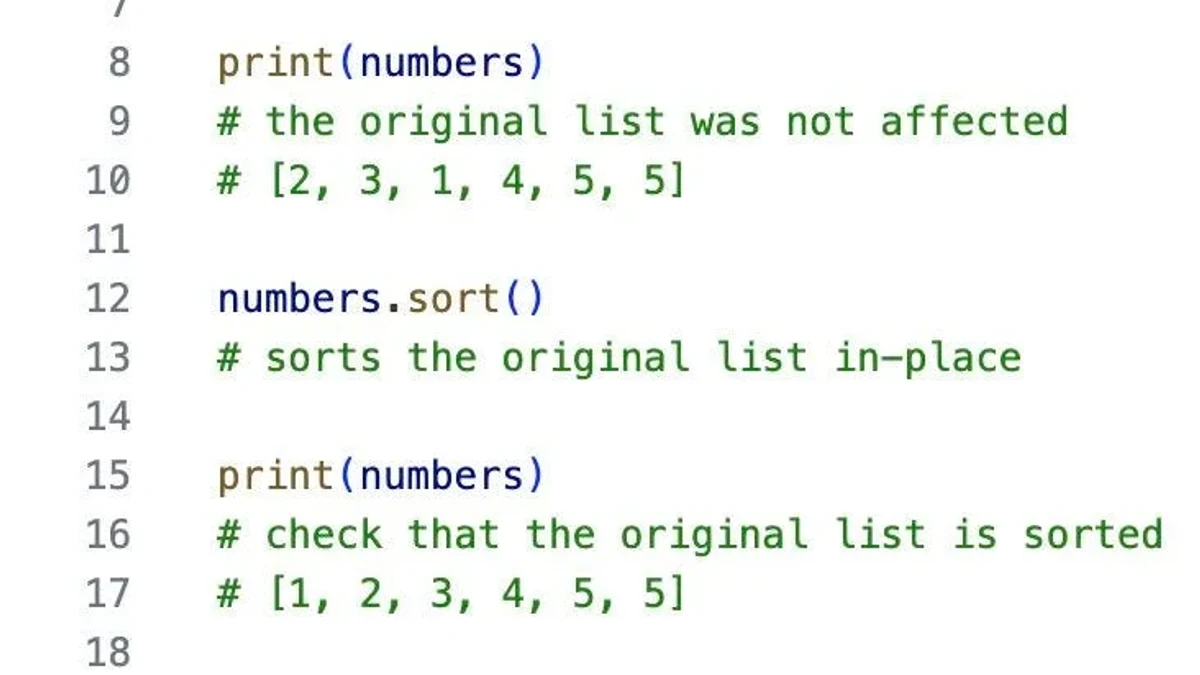
围绕Python列表排序,系统对比sort()方法与sorted()函数在返回值、是否修改原列表、使用场景和参数上的差异,并通过代码验证常见排序效果,帮助初学者避免误用。
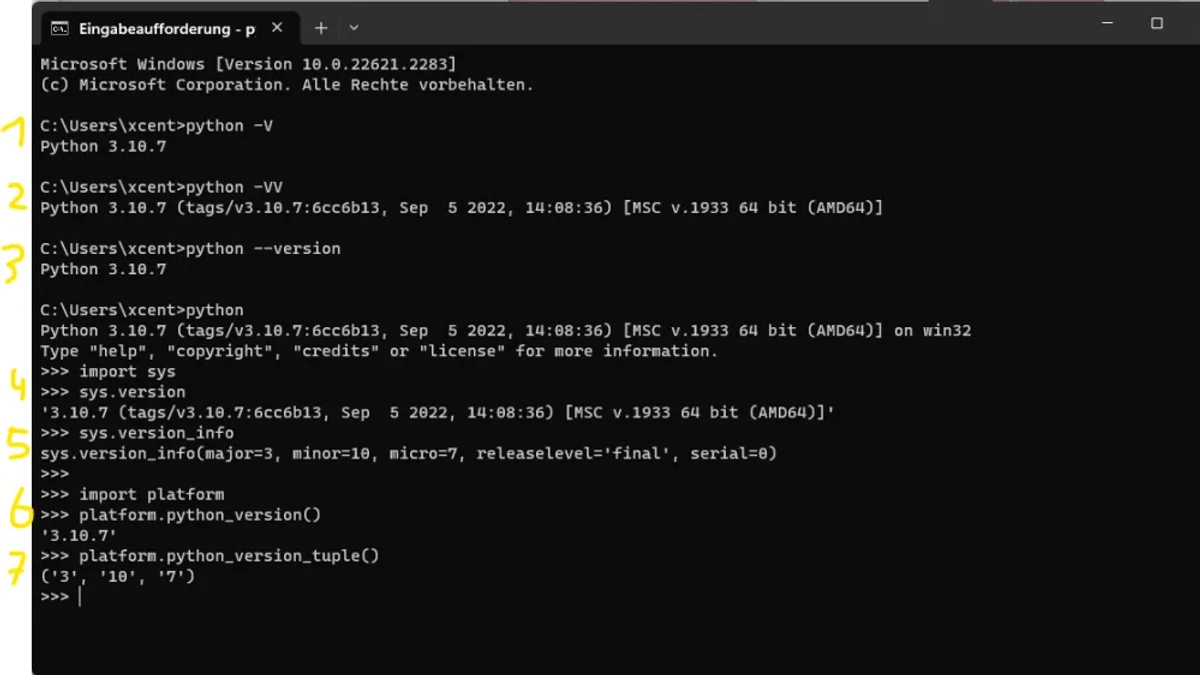
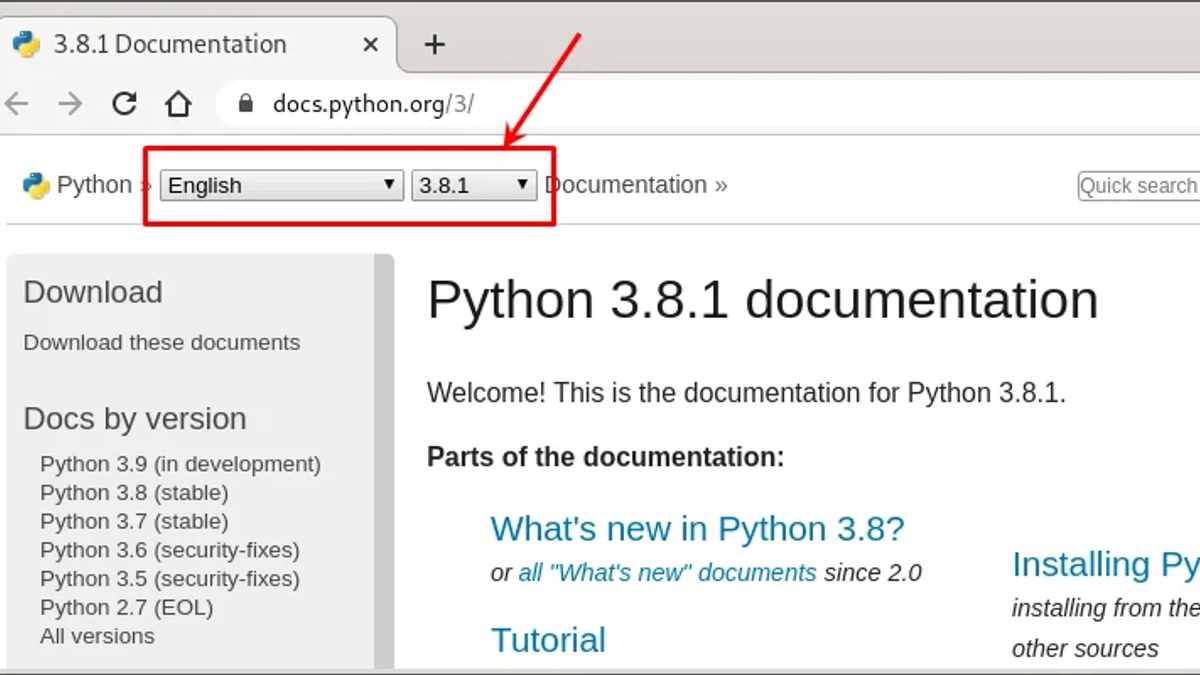
针对无法联网或网络受限的开发环境,介绍如何准备本地Python手册、快速检索API与标准库文档,并通过版本核对和实际运行验证避免查错文档。
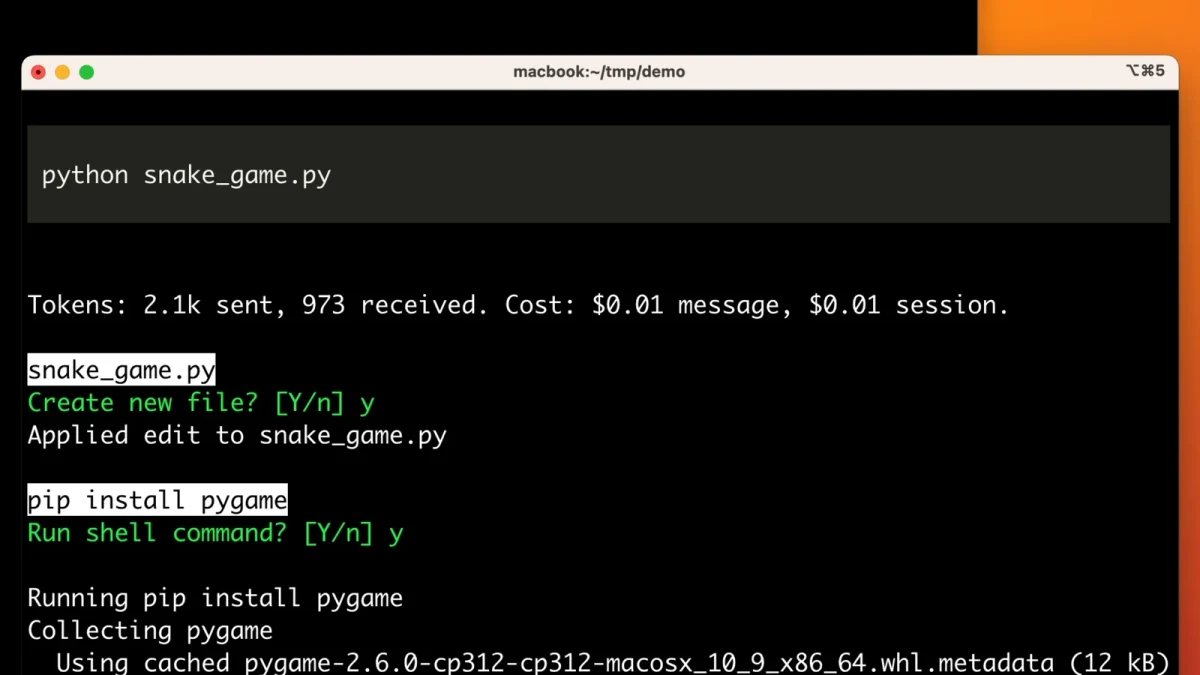
从官方文档、开源示例和完整小游戏项目入手,找到适合初学者的Pygame基础代码,并通过运行、拆解和修改验证代码是否真正适合自己的学习需求。
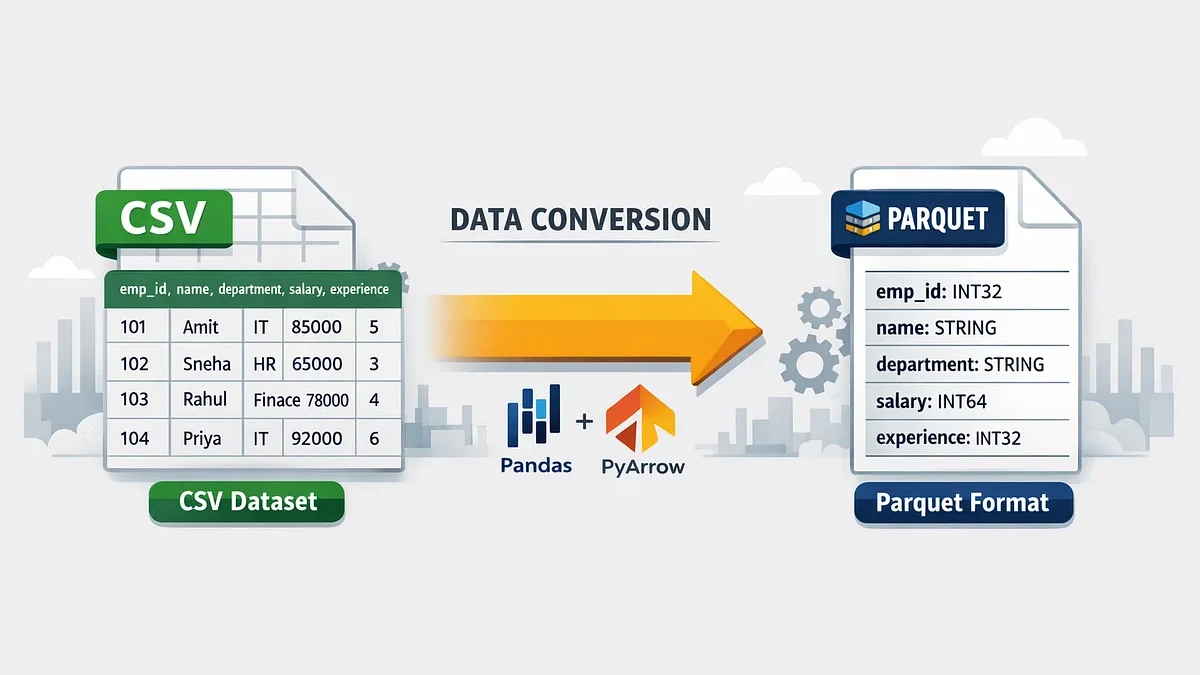
面对数GB甚至更大的CSV文件,Python数据导入常见瓶颈并不只来自文件读取,还涉及解析方式、内存占用、数据类型推断、磁盘与CPU吞吐等环节。本文将从性能定位、导入方式优化、内存控制和结果验证几个方面,系统分析大规模CSV导入中的常见问题与优化方法。
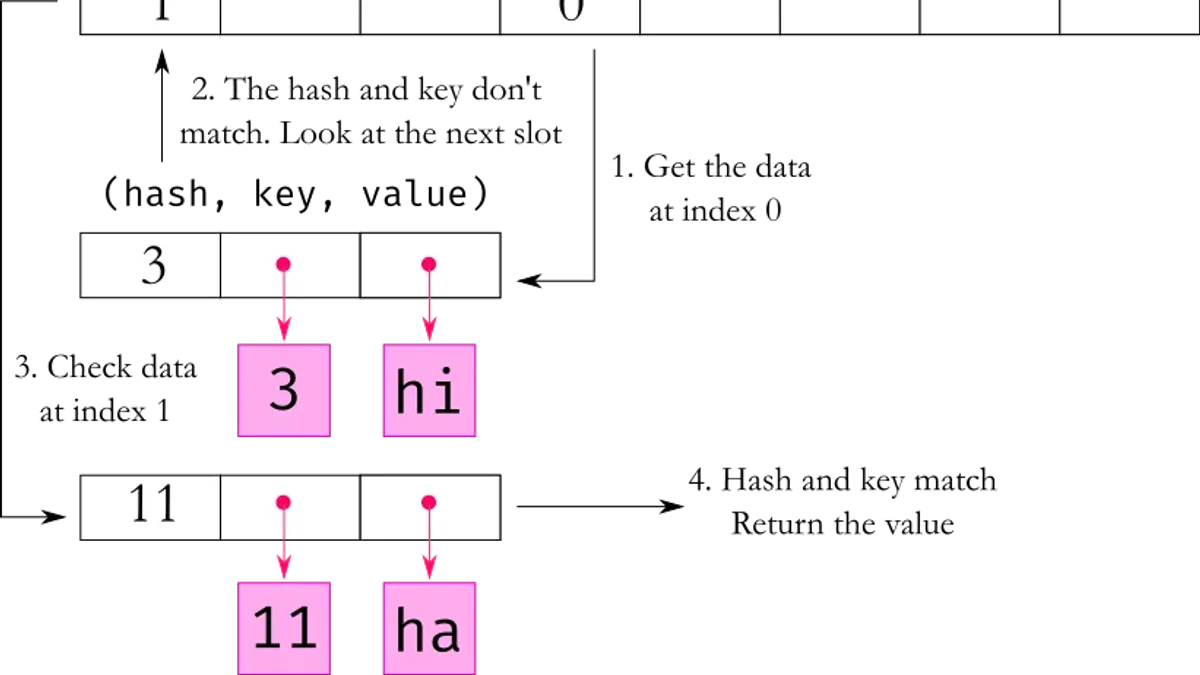
从对象内存布局、存储结构、扩容机制、哈希查找等角度拆解Python列表与字典的底层实现,并通过代码验证常见操作的性能与行为,帮助读者理解“为什么这样设计”以及实际开发中的避坑方法。
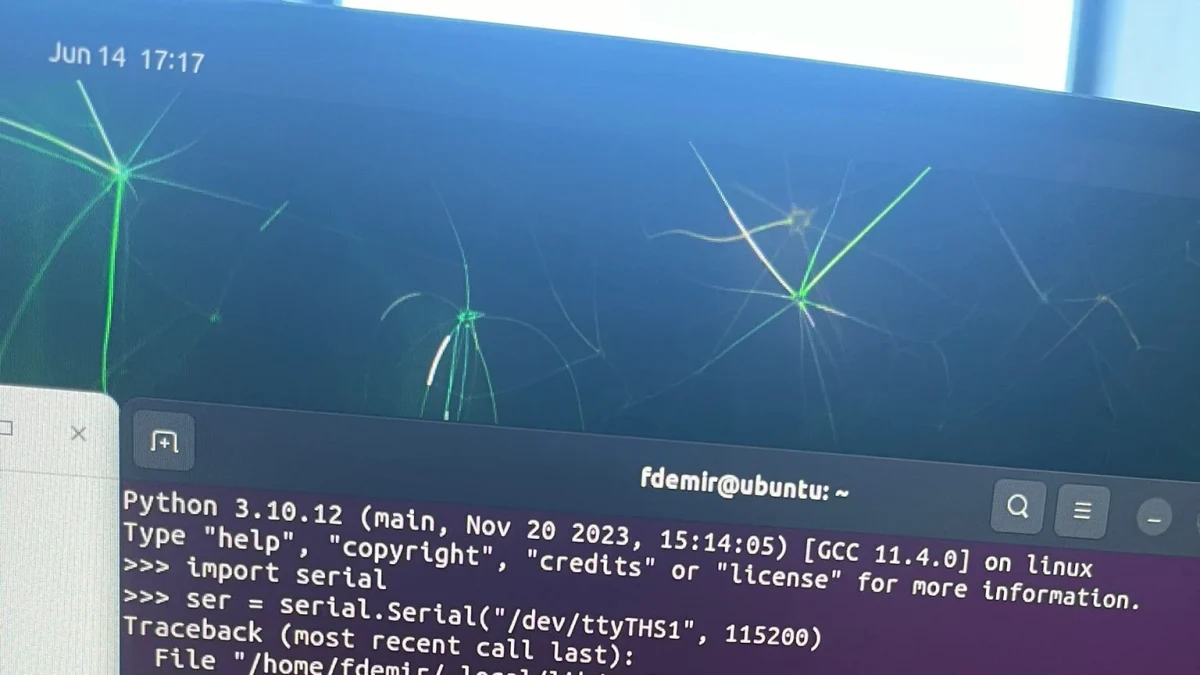
围绕 Python 串口开发在 Windows、Linux、macOS 等平台上的实际差异,对主流串口库的系统兼容性、API 特性、通信性能、异常处理与工程选型进行对比,并通过统一测试方法帮助开发者验证库的表现、规避常见兼容性问题。
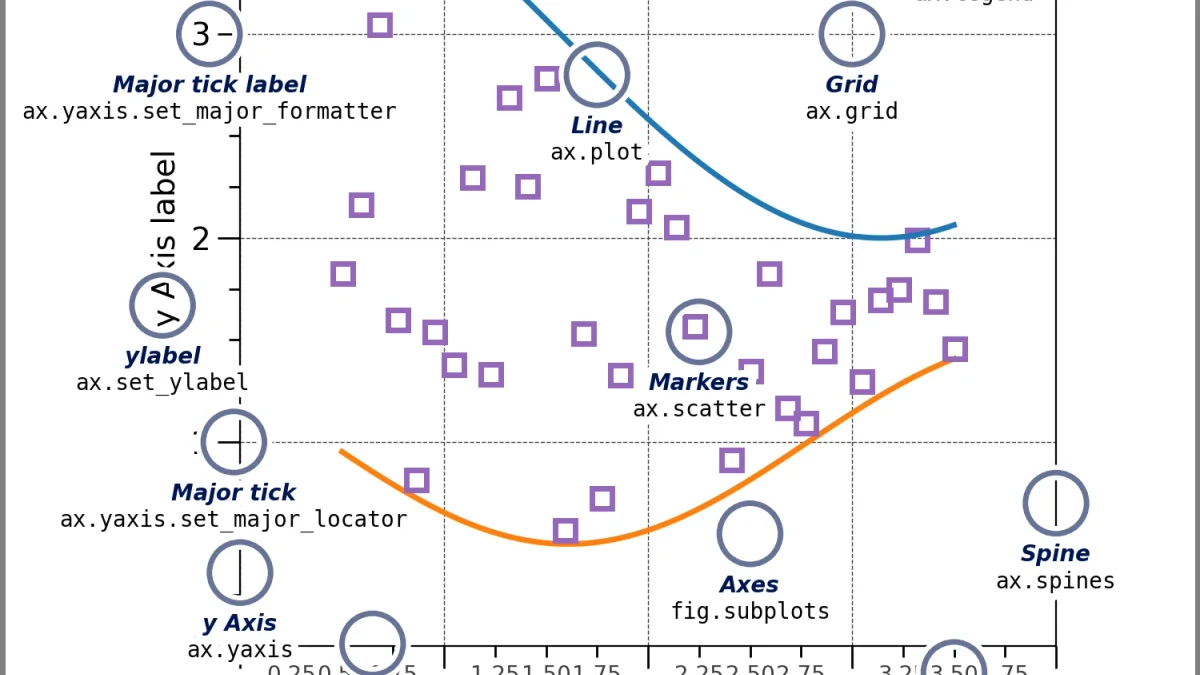
从Matplotlib与Pyplot的关系、实际绘图操作、使用场景和常见误区出发,帮助Python用户判断两者到底该如何选择,并掌握基础绘图与结果验证方法。
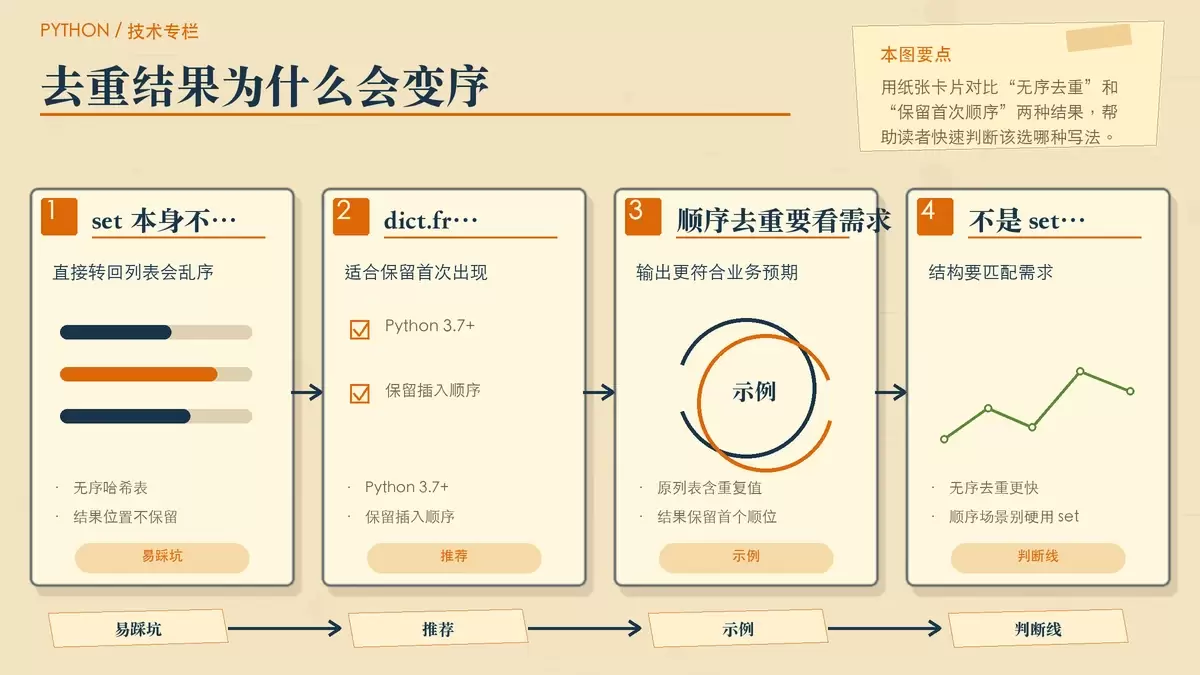
Python 里的 `set` 很适合做去重和集合运算,但它不是“列表增强版”。这篇文章把几个最容易踩坑的点拆开讲清:为什么 `set()` 去重会打乱顺序、什么时候该改用 `dict.fromkeys()`、交并差集的推荐写法,以及把列表转成 `set` 时常见的类型限制和性能判断。