

处理大规模CSV时Python数据导入的性能瓶颈分析

先定位大规模CSV导入的真正性能瓶颈
面对数GB的CSV文件,盲目优化往往事倍功半。首先需建立可复现的基准测试环境,将导入链路拆解为磁盘读取、文本解析、类型推断与内存分配四个独立环节。可使用Python内置的time模块结合tracemalloc记录各阶段耗时与内存峰值。例如,先用open(file, 'rb').read()测量纯磁盘I/O耗时,再用标准库csv.reader遍历统计解析开销,最后对比pandas.read_csv(dtype=str)与默认调用的差异。若磁盘读取耗时占比超过六成,瓶颈通常在I/O而非CPU;若解析与推断阶段耗时突增,则说明动态类型推断拖慢了速度。通过psutil监控进程RSS,可明确是否触及物理内存上限引发Swap。只有量化各环节指标,才能避免用多线程解决I/O瓶颈的无效优化。
选择合适的CSV读取方式降低解析开销
不同读取工具在速度、内存与生态上各有侧重。Python标准库csv模块内存占用极低,但缺乏向量化操作,适合流式清洗或仅需提取少量字段的场景。pandas.read_csv凭借底层C实现,在中小规模数据上兼顾速度与易用性,但默认全量加载易引发内存溢出。针对大文件,应优先使用usecols参数仅加载业务必需列,从源头削减解析负担;结合chunksize参数可将文件切分为固定行数的迭代器,实现流式处理。例如pd.read_csv('data.csv', usecols=['id', 'value'], chunksize=50000)。若追求极致吞吐,可转向polars或duckdb,它们内置多线程解析与惰性求值机制,在数十GB数据上表现显著优于pandas。选择时需权衡开发成本与运行环境,避免在简单任务中引入重型依赖。
控制内存占用:分块读取与数据类型优化
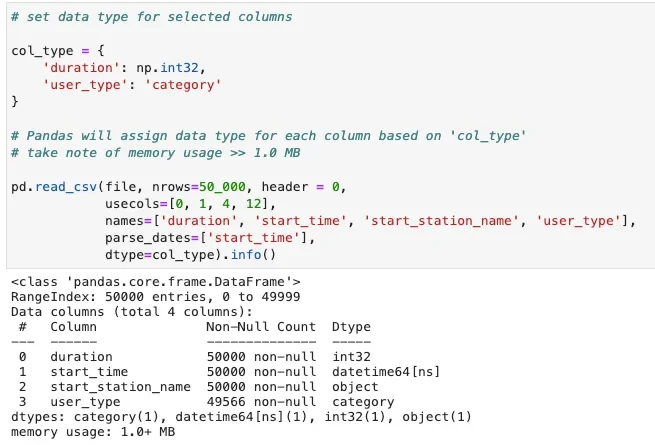
全量加载大文件极易触发OOM或频繁Swap,必须从分块与类型两方面控制内存。分块读取通过chunksize将数据分批送入内存,处理完即释放,但需注意避免在循环中频繁使用pd.concat拼接结果,应改用生成器累加或写入中间文件。数据类型优化是降内存的核心:默认情况下pandas会将整数读为int64、浮点读为float64、字符串读为object,内存开销极大。可通过dtype参数显式指定,如将float64降级为float32,将低基数字符串列转为category类型,或使用pd.to_numeric自动压缩。例如,一个包含百万行ID的列从int64转为int32可节省一半内存。同时提前过滤空列,关闭隐式类型推断,能进一步稳定内存水位。
从磁盘、解析与数据处理链路进一步优化吞吐
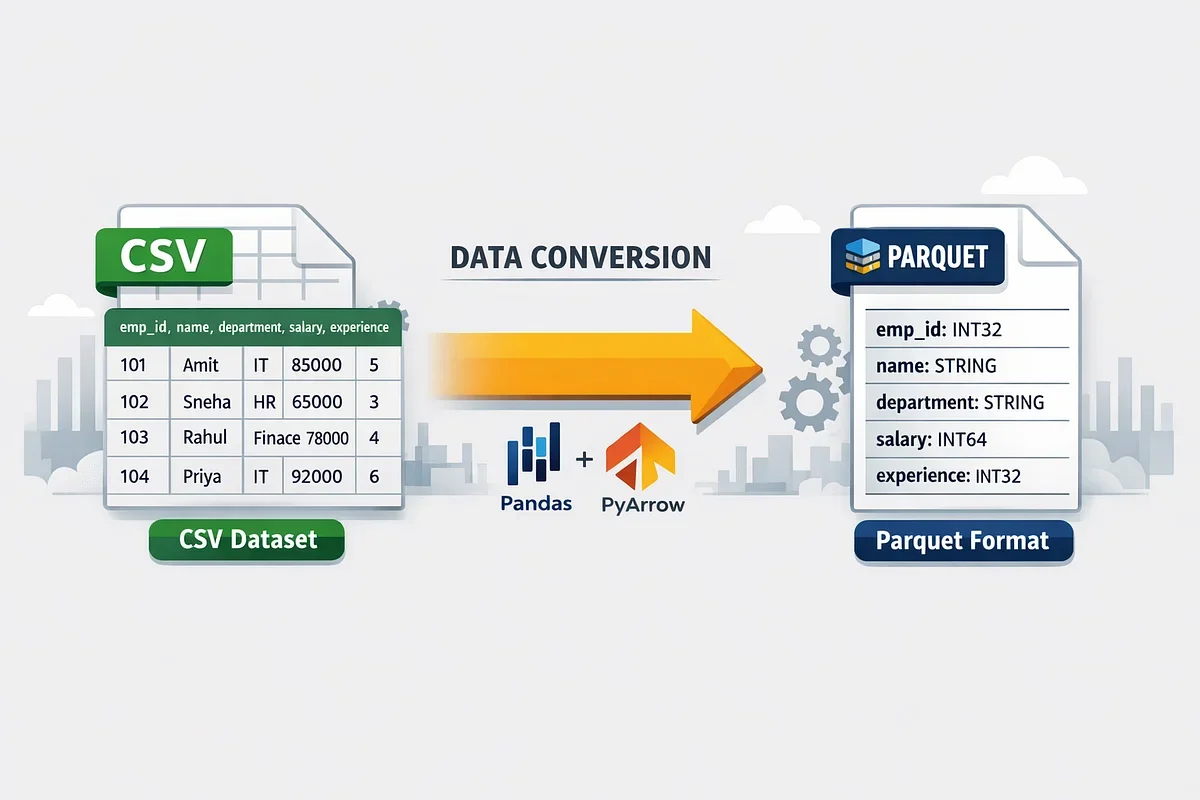
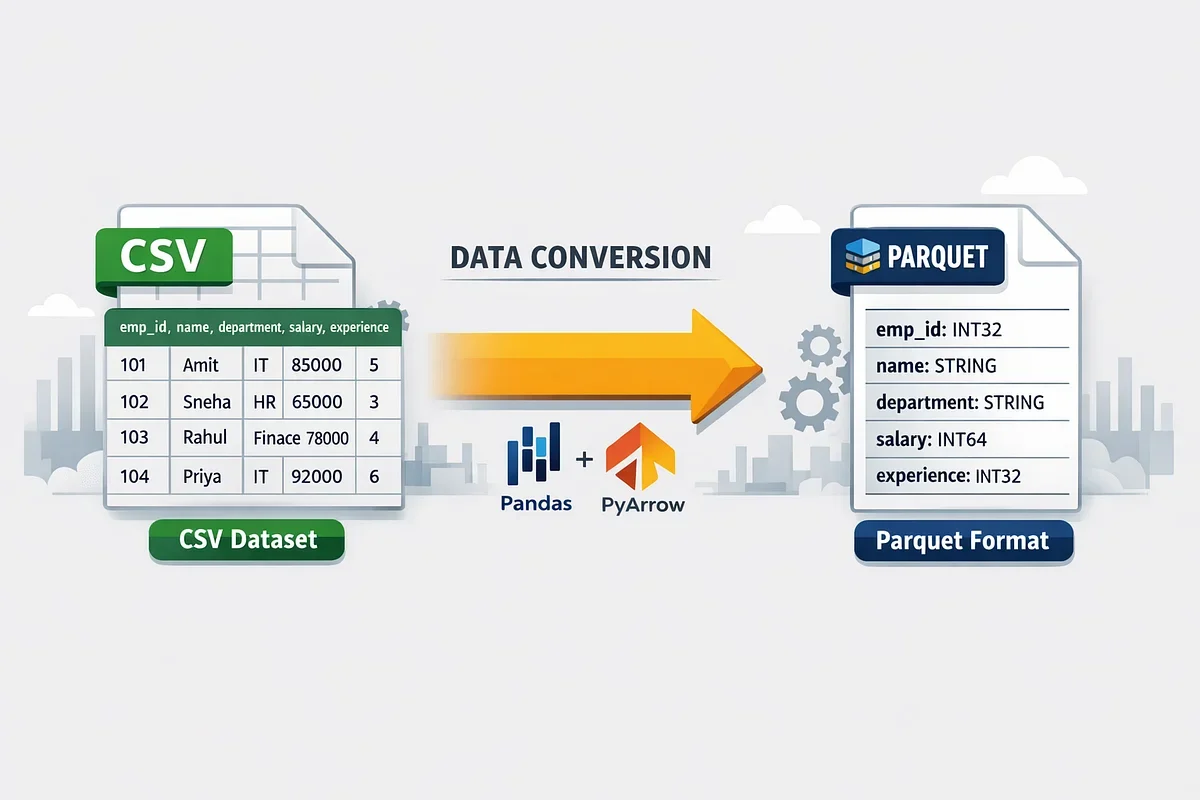
导入吞吐不仅取决于代码,更受底层硬件与数据格式制约。机械硬盘的随机读取延迟远高于SSD,若文件碎片化严重,可先进行顺序读取预热。压缩CSV能减少磁盘I/O,但解压会消耗CPU,需根据核心数与磁盘带宽权衡;zstd通常提供更高的压缩比与解压速度。在单机Python场景下,可借助multiprocessing对分块任务并行解析,但需注意进程间通信开销。当数据规模突破单机内存或需频繁查询时,应果断转向列式存储:将CSV一次性转换为Parquet或Feather格式,利用其列裁剪、谓词下推与高效压缩特性,后续读取速度可提升数倍。若涉及复杂ETL或分布式计算,DuckDB或Apache Spark是更可持续的架构选择。
用基准测试验证优化效果并规避常见误区
任何优化都必须通过严谨的基准测试验证,否则极易陷入性能陷阱。测试需固定同一份源文件、相同硬件环境与Python版本,记录优化前后的总耗时、峰值RSS、吞吐量及数据一致性。验证一致性可通过比对行数、关键列哈希值或抽样统计分布实现。常见误区包括:盲目开启多线程导致上下文切换开销大于收益;过度使用category类型反而增加字典内存;在循环中反复拼接DataFrame引发指数级内存增长;以及忽略类型推断冲突。正确的做法是先跑通单线程基准线,再逐项引入usecols、dtype、分块与格式转换,每次仅变更一个变量并记录指标。只有数据可复现、结果可校验,优化才具备工程价值。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









