


很多人第一次用 Python 做列表去重,都会顺手写出 list(set(data))。它确实快,但一旦业务要求“去重后保留原始顺序”,这个写法就会立刻出问题。下面就按实际使用场景拆开讲:先看 set 为什么会打乱顺序,再看交并差集怎么写更顺手,最后补上类型限制和性能边界,方便你判断什么时候该用、什么时候该换方案。
为什么 set() 去重会打乱原有顺序
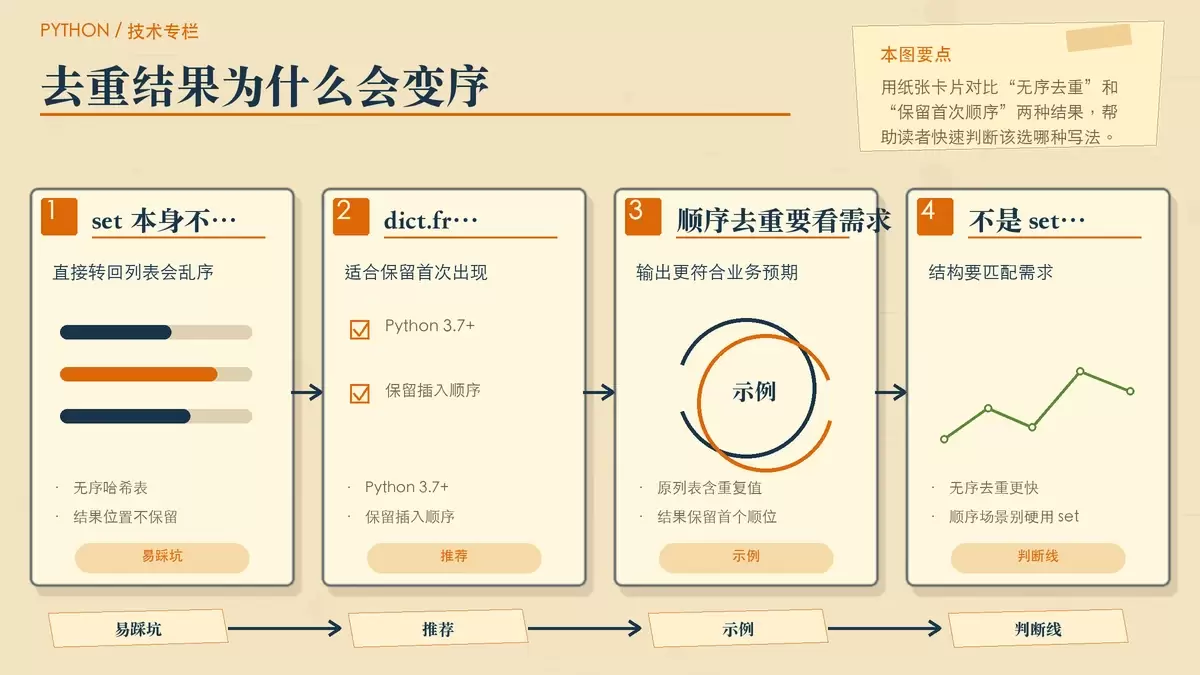
set 的本质是无序哈希表,元素放进去以后,不会按你原来列表里的位置保存。因此,直接把列表丢进 set() 再转回列表,得到的只是“去重后的某种排列”,而不是“按原顺序去重后的结果”。
例如下面这段代码:
list(set([1,2,2,3,1]))它可能返回 [2, 1, 3],也可能表现出别的顺序。重点不在于某次运行恰好是什么,而在于这个顺序本身不可控,不能拿来依赖。
如果需求是“保留第一次出现的顺序再去重”,更合适的做法是用 dict.fromkeys()。在 Python 3.7+ 中,字典会保留插入顺序,所以它正好适合这种场景:
original = [1, 2, 2, 3, 1, 4]
unique_ordered = list(dict.fromkeys(original))# [1, 2, 3, 4]
这里要分清楚:不是 set 不好用,而是它解决的是“无序去重”问题。如果你的业务要求包含顺序信息,那就不应该把纯 set 当成最终方案。
交集、并集、差集和对称差应该怎么写
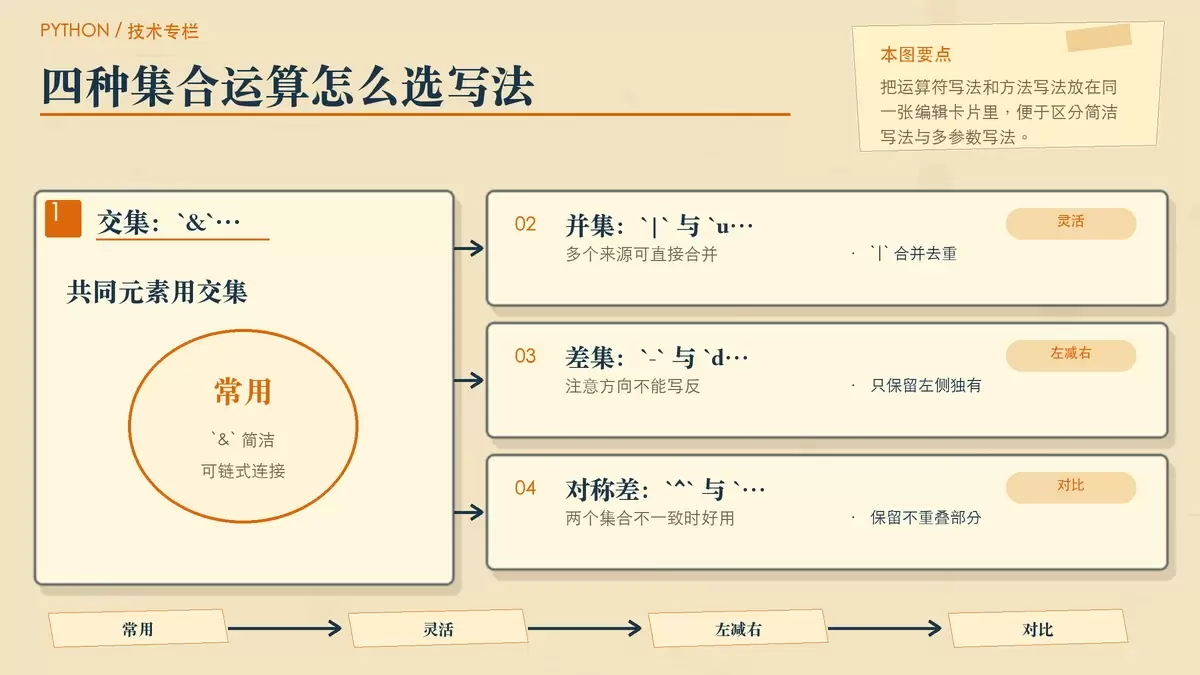
除了去重,set 更常见的价值在集合运算。Python 同时提供了运算符写法和方法写法,两套语义基本一致,但适用场景略有区别。
交集:找共同元素
交集可以用 &,也可以用 intersection():
set_a & set_bset_a.intersection(set_b)
如果只处理两个集合,运算符最直观;如果要一次处理多个集合,方法更灵活,例如:set_a.intersection(set_b, set_c)。而运算符写法只能链式写成 set_a & set_b & set_c。
并集:合并并自动去重
并集对应 | 或 union()。两者思路相同,都是把多个集合合在一起并自动去重。处理固定数量集合时,| 更短;集合数量不固定、需要动态传参时,union() 会更顺手。
差集:只保留左边独有的元素
set_a - set_b 表示“左边有、右边没有”的元素,等价于 set_a.difference(set_b)。不过方法写法还有一个优势:可以一次减多个集合,例如 set_a.difference(set_b, set_c),而 - 只能写成链式运算。
对称差:保留不重叠的部分
^ 表示对称差,也就是“属于 a 或 b,但不同时属于两边”的元素,等价于 set_a.symmetric_difference(set_b)。这个运算在比较两份数据差异时很实用,尤其适合快速找出“不一致项”。
实际开发里,可以把规则记成一句话:日常写法优先用 &、|、-、^,代码更紧凑;一旦涉及多个集合或参数来自变量列表,再换成对应的方法。
列表转 set 前,先确认元素是否可哈希
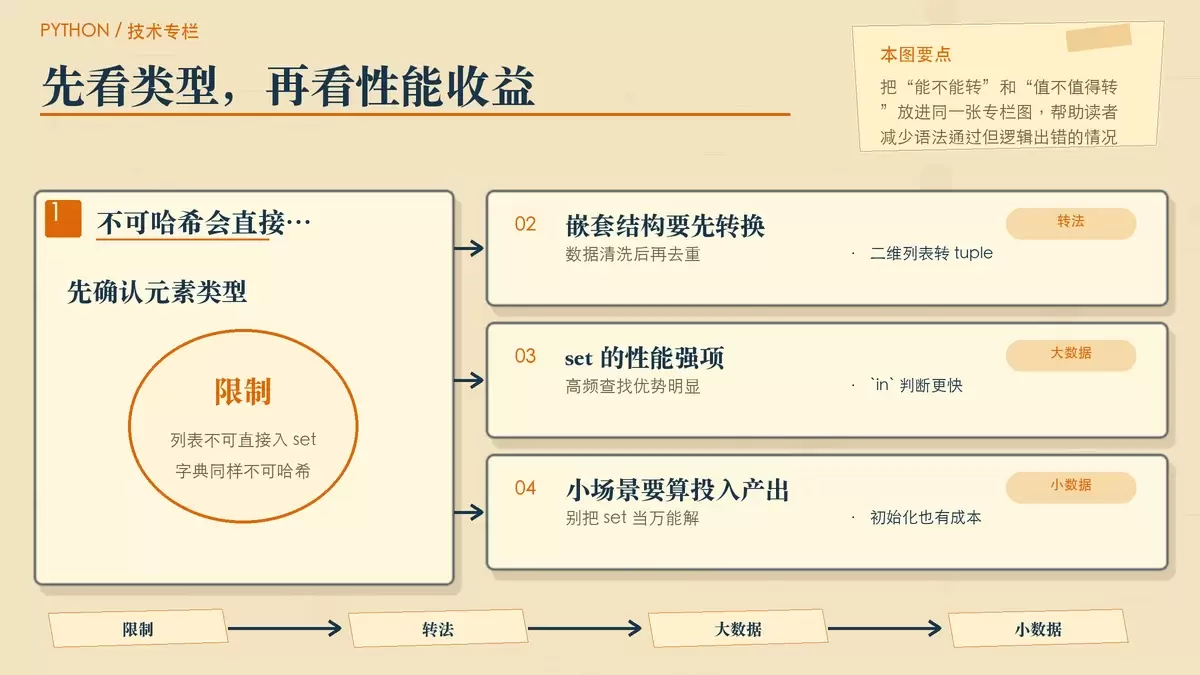
set 不是任何数据都能直接放。它要求元素必须是可哈希的,也就是能稳定参与哈希计算。像列表、字典、集合这类可变对象,默认都不能作为 set 元素。
下面这个例子会直接报错:
bad = [[1,2], [3,4]]
set(bad)# TypeError: unhashable type: 'list'
这类问题在数据清洗时很常见,尤其是列表里套列表、套字典的时候。几个高频场景可以这样处理:
- 二维数字列表去重:先把每一行转成元组,再做集合化,例如
set(map(tuple, matrix)) - 想对含字典的列表去重:先把字典转换成可哈希形式,例如转成
tuple、frozenset,或者在字段顺序可控时使用json.dumps(sorted_items)后再参与哈希 - 字符串列表通常可以直接转
set,但大小写会被视为不同值,比如set(['A', 'a'])会得到两个元素
这里最容易忽略的一点是:代码没报错,只代表类型通过了,不代表业务逻辑一定正确。尤其是做去重时,先确认“两个对象在你的业务里算不算同一个值”,往往比语法本身更关键。
性能判断:什么时候该用 set,什么时候别硬上
set 的性能优势主要体现在成员判断和大规模集合运算上,但不是所有场景都值得先转一次集合。
如果数据量很小,比如少于 100 个元素,构造 set 本身的初始化开销可能并不划算;而当数据量上升到 1000 以上,尤其需要频繁做 in 判断时,它的优势会明显放大。
适合用 set 的场景
- 大量成员判断:
if x in big_set:的平均复杂度是 O(1),通常比if x in big_list:的 O(n) 更高效 - 批量过滤:先把黑名单放进
set,再过滤数据,例如filter(lambda x: x not in black_set, data) - 多个来源 ID 合并去重:把各来源列表转成集合后再做
|运算,通常会比嵌套循环快很多
不一定要用 set 的场景
如果你只是做一次性去重,后面还要保留原顺序,甚至继续按索引访问,那么 dict.fromkeys() 往往比“先转 set、再排序、再转回列表”更直接。判断标准很简单:别为了用 set 而用 set,而是看它是否真的匹配当前的数据结构和后续操作。
一条实用判断线:先看需求,再选结构
把这篇内容压缩成可执行的判断,其实只有几条:
- 只想快速去重,不关心顺序,用
set() - 既要去重又要保留首次出现顺序,用
dict.fromkeys(),适用 Python 3.7+ - 做交集、并集、差集、对称差,优先用运算符;多集合或动态参数时再换方法
- 列表转集合前,先检查元素是否可哈希,尤其注意嵌套列表和字典
- 性能收益主要出现在大数据量和高频查找上,小数据场景别过度设计
这样处理后,set 就不只是“一个能去重的容器”,而是一个在合适场景下非常高效的数据结构工具。









