

变量名前加单下划线在Python下划线命名中含义

先理解变量名前单下划线的基本含义
在Python的命名规范中,变量名前添加单下划线(例如_internal_data)是一种广泛认可的编程约定,主要用于向其他开发者传达该变量或方法仅供内部使用、不属于公开API的意图。与普通变量名不同,单下划线前缀并不会改变Python解释器的底层访问机制,它仅仅是一种语义层面的提示。Python语言本身并没有提供类似Java或C++中严格的private访问修饰符,因此开发者依赖这种命名约定来划分模块或类的内部实现细节与对外暴露的接口。在实际编码中,当你看到_cache或_helper_func时,应当理解为这些元素是类的内部状态或辅助逻辑,外部调用者不应直接依赖它们,因为它们在后续版本中可能会被随意修改或移除,而不会遵循向后兼容原则。
验证单下划线并不会真正禁止外部访问
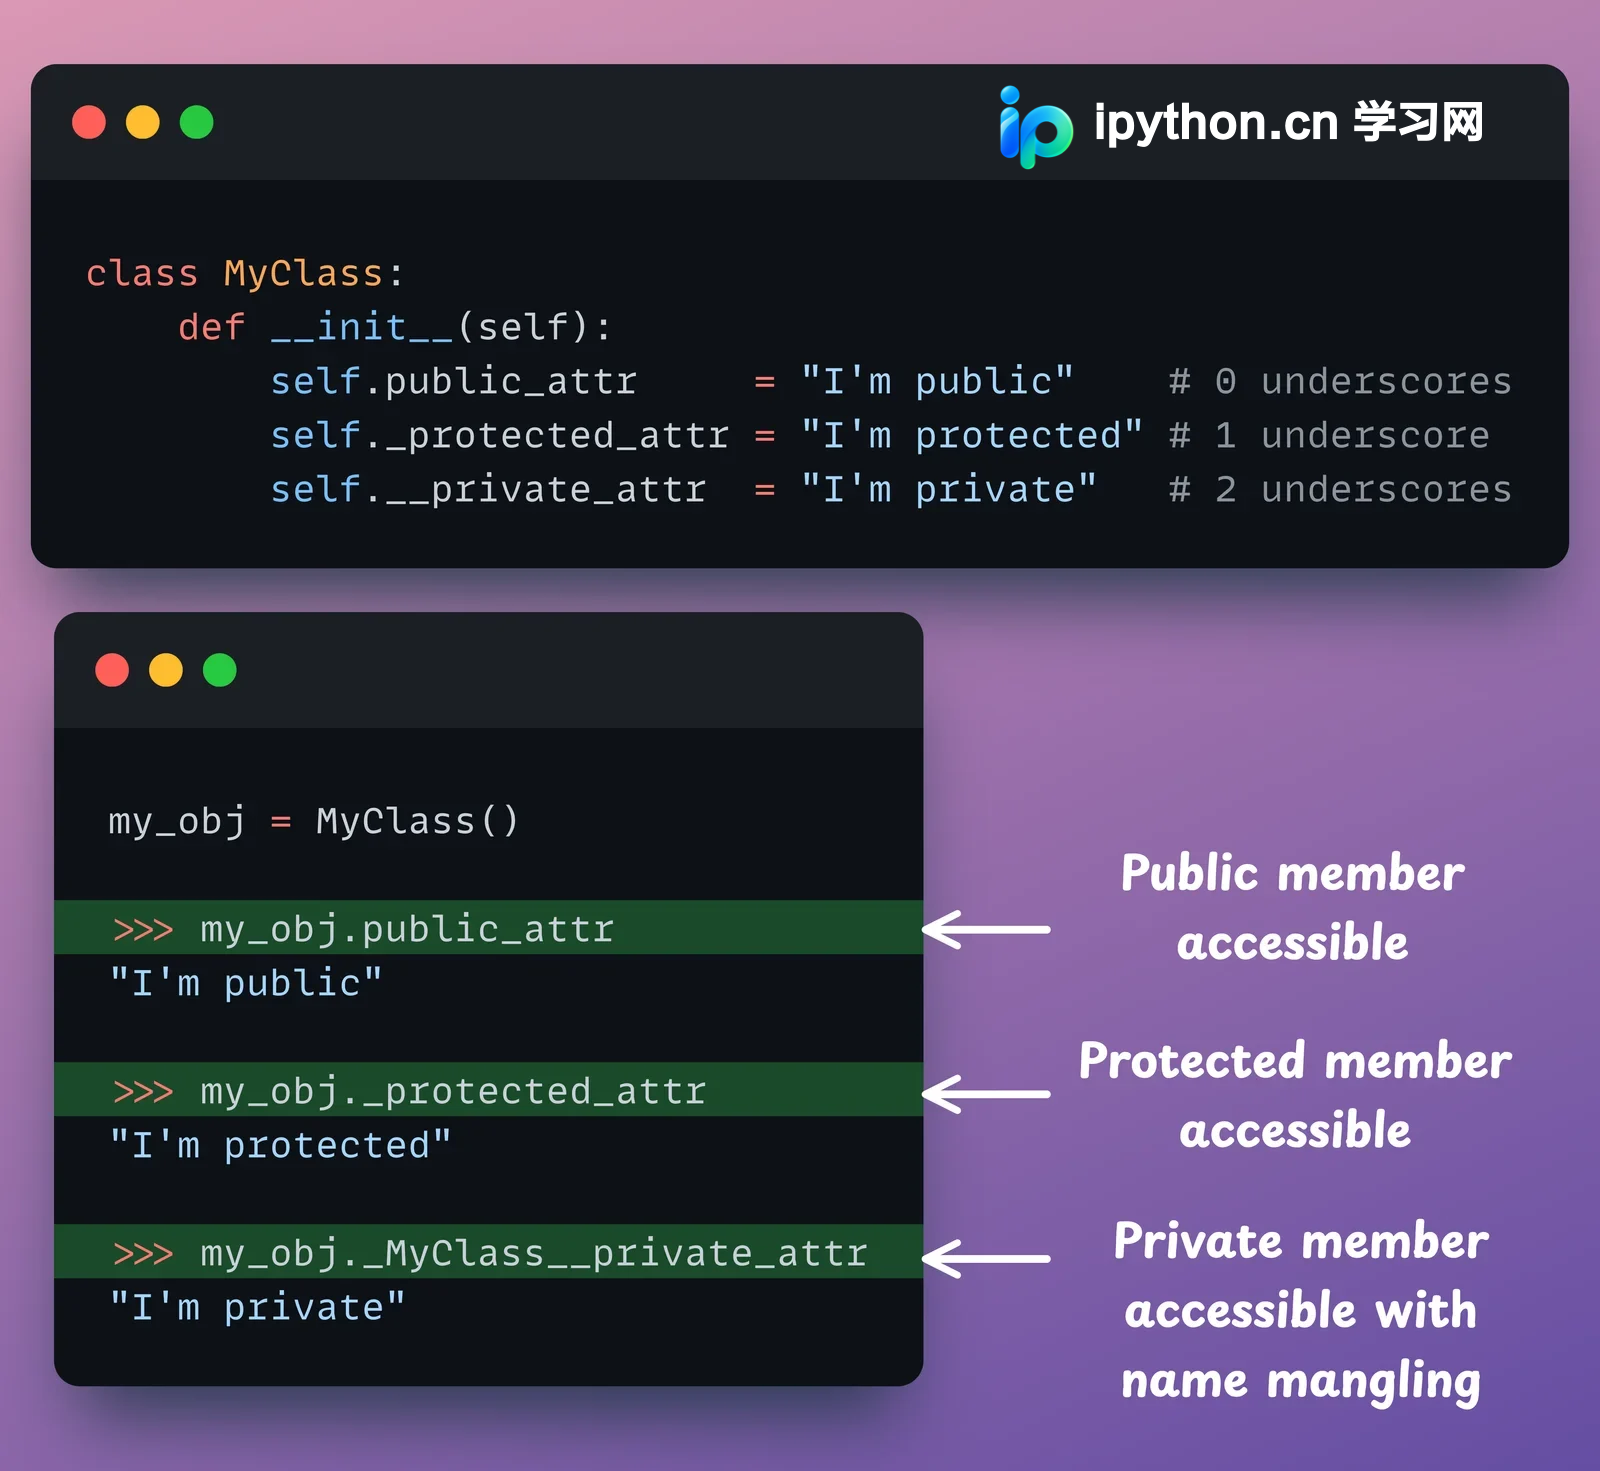
尽管单下划线前缀表达了内部使用的意图,但必须明确的是,它绝不构成真正的访问控制屏障。Python的设计哲学强调我们都是成年人,即信任开发者会遵守约定,而不是通过语法强制限制。你可以通过简单的代码验证这一点:在类外部或模块外部直接通过实例或模块名访问带单下划线的属性,解释器不会抛出任何AttributeError或权限异常。例如,定义一个包含_secret等于四十二的类Demo,实例化后执行obj点_secret依然能顺利返回四十二。这说明单下划线纯粹是开发者之间的君子协定,主要用于代码阅读、IDE静态分析提示以及团队协作时的边界划分。如果试图依赖它来保护敏感数据或实现严格的封装,将会导致严重的安全隐患或逻辑漏洞。
看懂单下划线对模块导入的特殊影响
单下划线前缀在模块级别具有一个非常具体且实用的语法特性,它会直接影响from模块import星号的导入行为。当你在一个Python模块中定义了公开变量和带单下划线的内部变量,并在另一个文件中使用星号导入时,Python解释器会自动过滤掉所有以单下划线开头的名称,仅将公开名称引入当前命名空间。这一机制有效避免了模块内部实现细节污染全局作用域,减少了命名冲突的风险。需要注意的是,这种过滤仅对星号导入生效;如果你使用显式导入语句直接指定导入带单下划线的变量,该变量依然可以被正常加载和使用。因此,在编写工具库或框架时,合理运用单下划线前缀可以显著提升模块的封装性,同时保留开发者按需导入内部组件的灵活性。
区分单下划线与双下划线,避免误解为真正私有
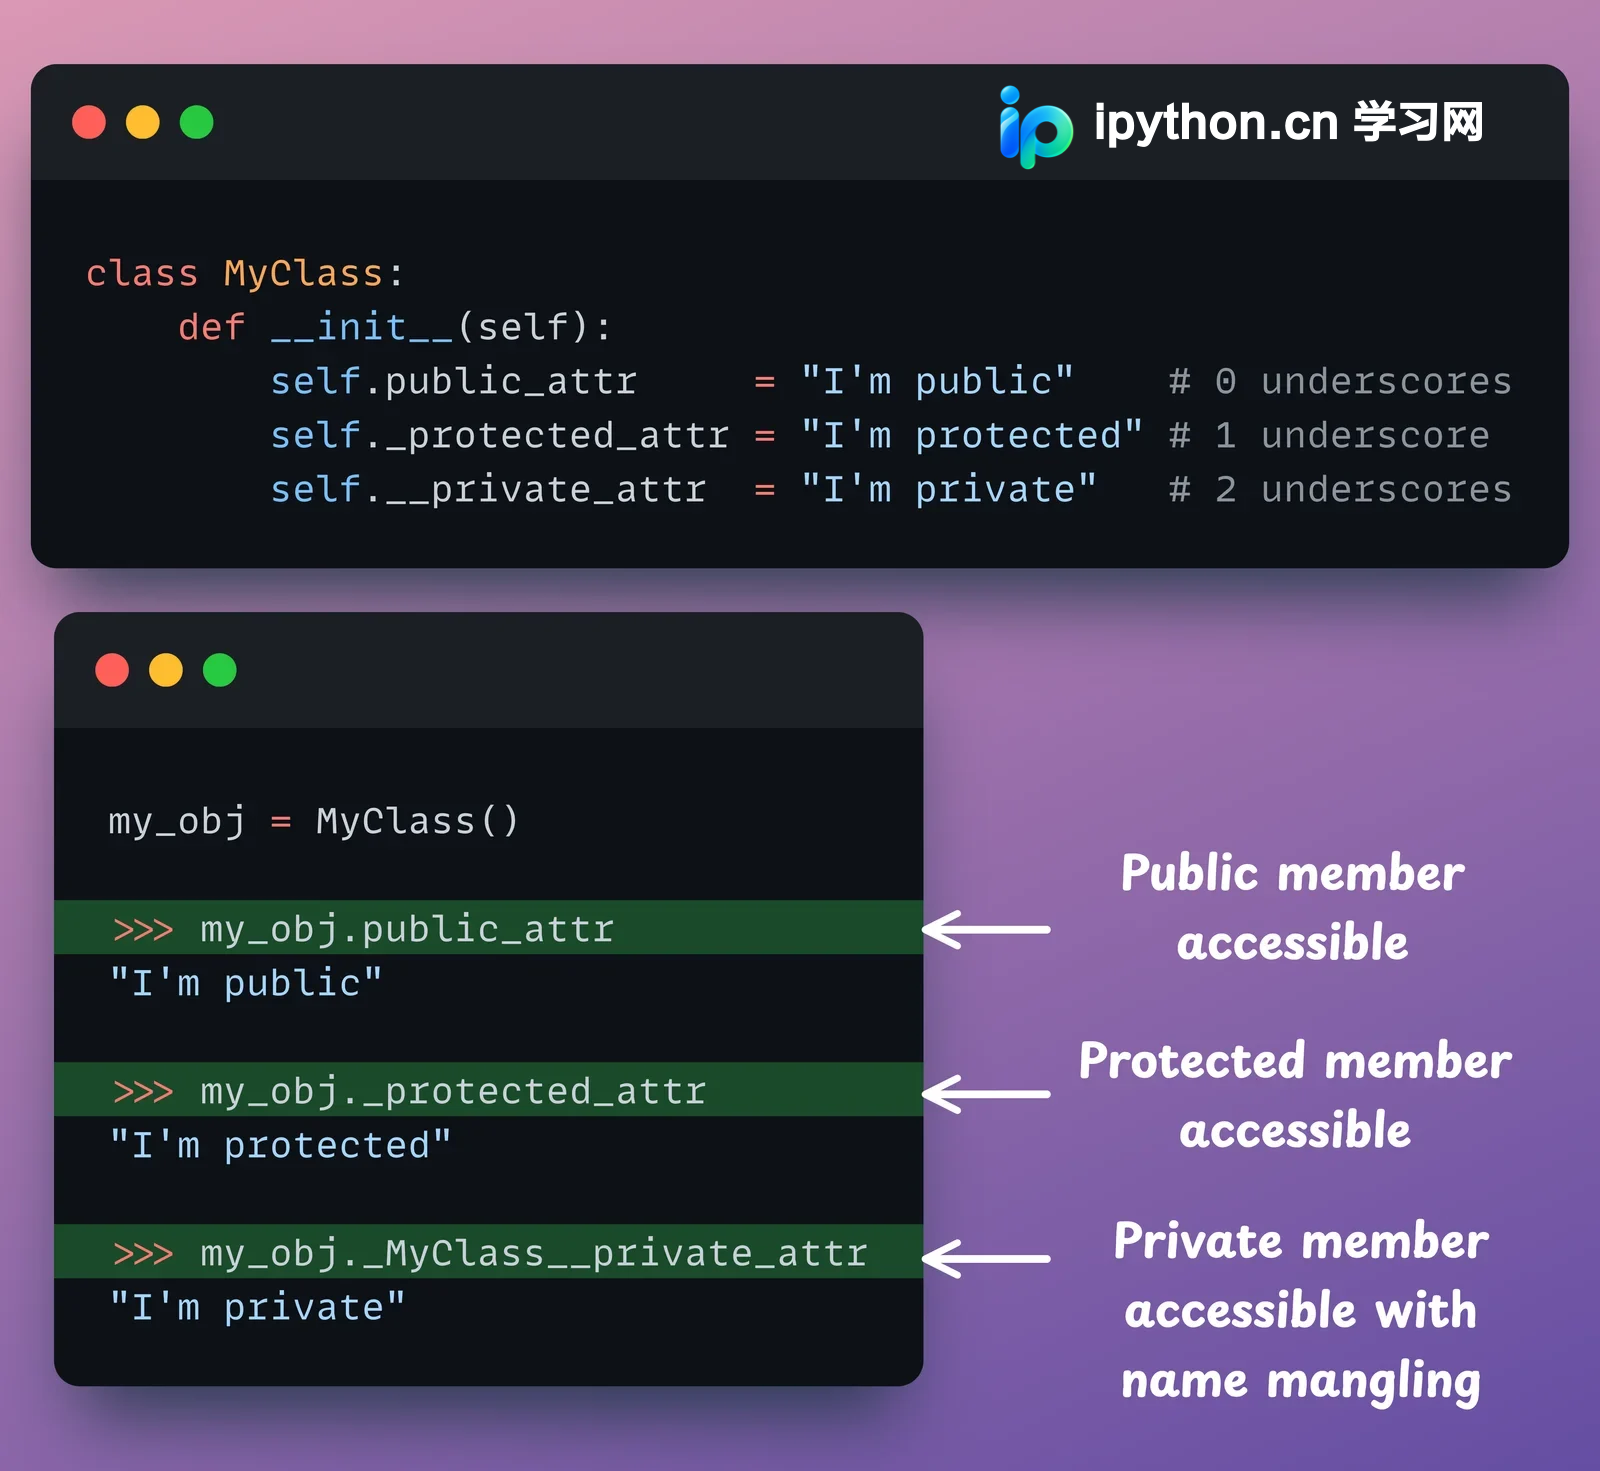
许多初学者容易将单下划线与双下划线混淆,误以为它们都代表私有。实际上,两者在Python中的行为截然不同。单下划线仅是命名约定,而双前导下划线且不以双下划线结尾会触发Python的名称改写机制。解释器在编译时会自动将双下划线开头的属性转换为下划线加类名加双下划线加原名的形式,以此大幅降低子类意外覆盖父类属性的概率。例如,在类Base中定义双下划线data等于十,外部尝试通过实例点双下划线data访问会直接报错,必须使用改写后的完整名称才能获取。这种改写是语法层面的强制行为,与单下划线的软约定有本质区别。理解这一差异至关重要:单下划线用于标记非公开API,双下划线用于避免继承冲突,而双前后下划线则是Python保留的魔术方法,三者不可混为一谈。
实际命名时的常见避坑与使用建议
在实际项目开发中,正确使用单下划线命名需要遵循明确的场景边界与团队规范。首先,它非常适合用于标记类的内部缓存变量、辅助计算方法或模块中不希望被外部直接调用的工具函数。其次,应避免将其用于需要严格保密的数据,因为它无法阻止外部访问。常见的误区包括在子类中随意重写父类的单下划线方法导致行为不一致,或过度使用单下划线导致公开API过少、模块难以复用。建议团队在代码审查中统一约定:对外暴露的接口一律不加下划线,内部实现细节统一使用单下划线前缀,并配合双下划线all列表明确控制模块导出范围。同时,利用现代IDE的静态检查工具配置规则,对违规访问内部成员的行为发出警告,从而在保持Python灵活性的同时提升代码的可维护性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









