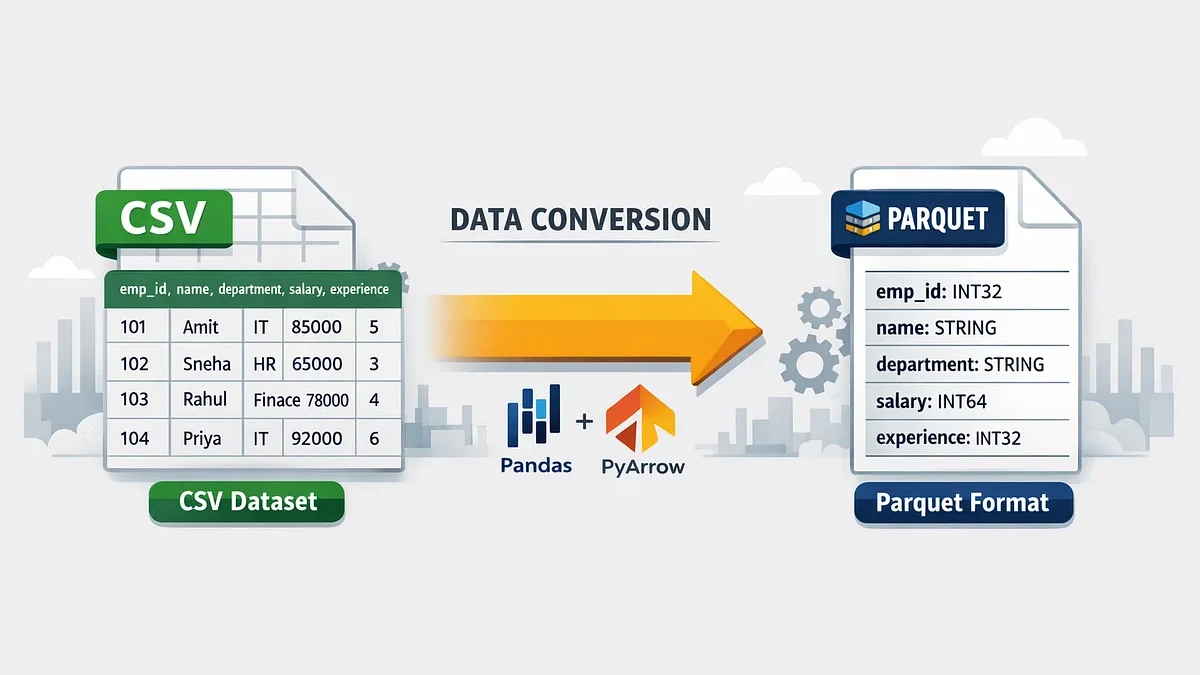
处理大规模CSV时Python数据导入的性能瓶颈分析
面对数GB甚至更大的CSV文件,Python数据导入常见瓶颈并不只来自文件读取,还涉及解析方式、内存占用、数据类型推断、磁盘与CPU吞吐等环节。本文将从性能定位、导入方式优化、内存控制和结果验证几个方面,系统分析大规模CSV导入中的常见问题与优化方法。
2026-09-08
15

面对数GB甚至更大的CSV文件,Python数据导入常见瓶颈并不只来自文件读取,还涉及解析方式、内存占用、数据类型推断、磁盘与CPU吞吐等环节。本文将从性能定位、导入方式优化、内存控制和结果验证几个方面,系统分析大规模CSV导入中的常见问题与优化方法。
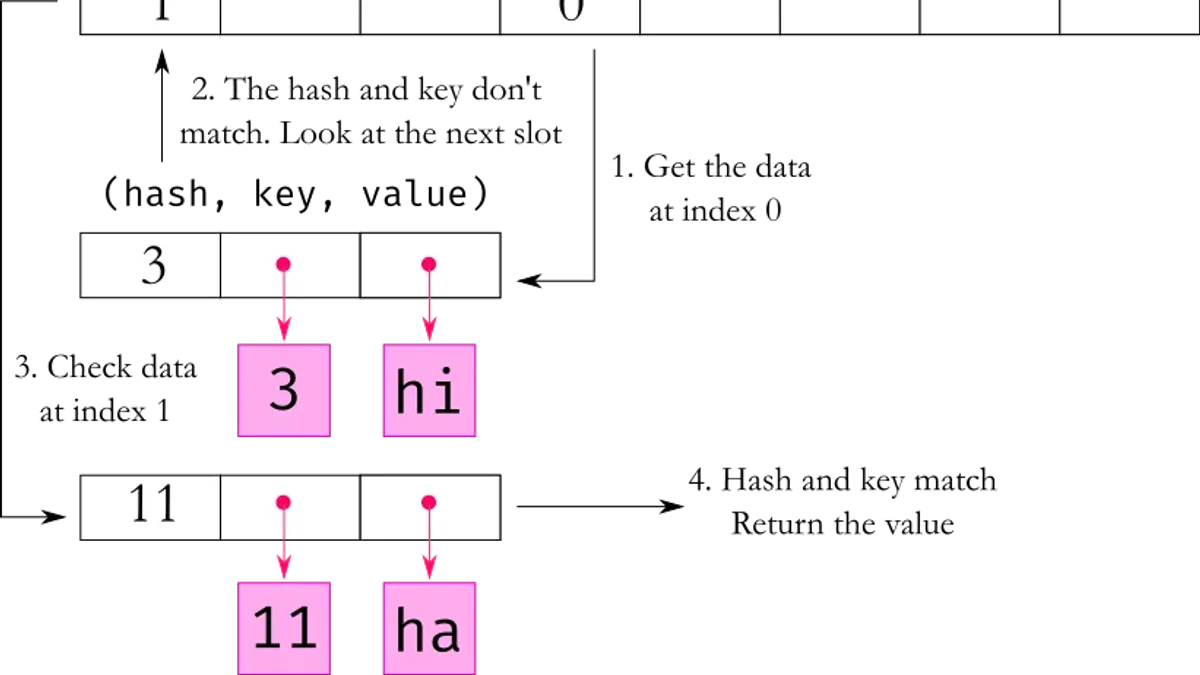
从对象内存布局、存储结构、扩容机制、哈希查找等角度拆解Python列表与字典的底层实现,并通过代码验证常见操作的性能与行为,帮助读者理解“为什么这样设计”以及实际开发中的避坑方法。
围绕 Python 串口开发在 Windows、Linux、macOS 等平台上的实际差异,对主流串口库的系统兼容性、API 特性、通信性能、异常处理与工程选型进行对比,并通过统一测试方法帮助开发者验证库的表现、规避常见兼容性问题。
从Matplotlib与Pyplot的关系、实际绘图操作、使用场景和常见误区出发,帮助Python用户判断两者到底该如何选择,并掌握基础绘图与结果验证方法。
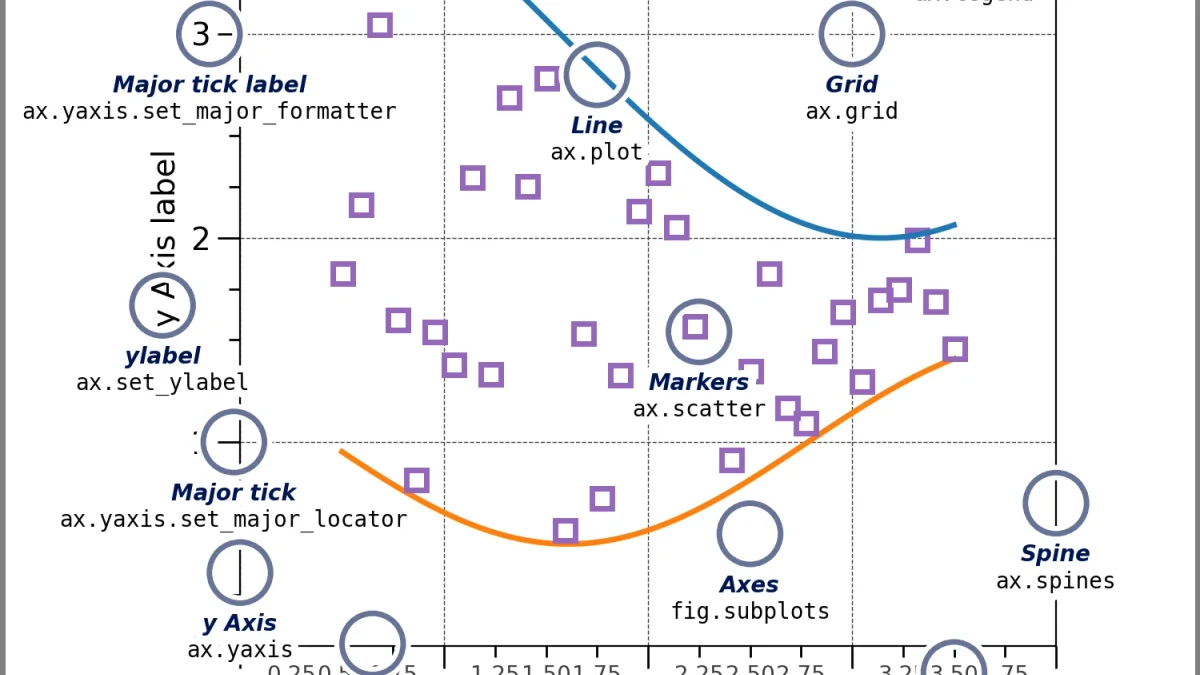
Python 里的 `set` 很适合做去重和集合运算,但它不是“列表增强版”。这篇文章把几个最容易踩坑的点拆开讲清:为什么 `set()` 去重会打乱顺序、什么时候该改用 `dict.fromkeys()`、交并差集的推荐写法,以及把列表转成 `set` 时常见的类型限制和性能判断。
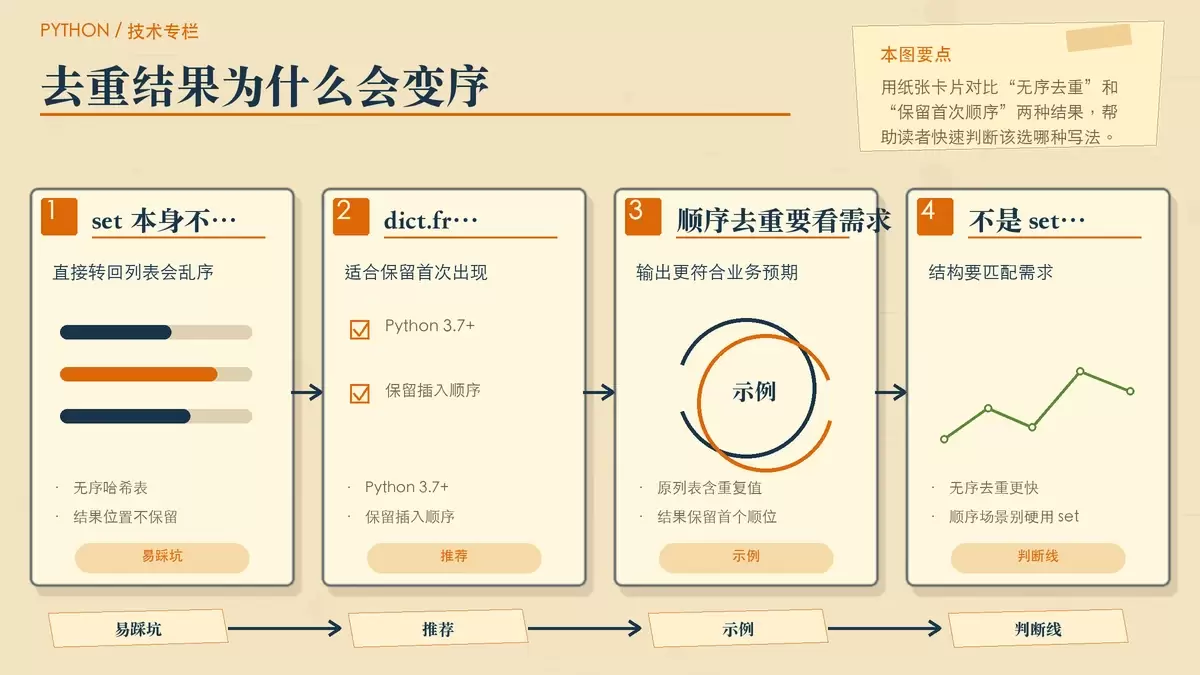
读取大日志最后 N 行时,`readlines()[-N:]` 看似直接,实际会把整份文件读入内存,面对 GB 级日志很容易卡死或触发 `MemoryError`。这篇文章把可行方案拆开讲:命令行优先用 `tail -n N`,Python 自实现则要用二进制反向扫描,同时说明边界处理和第三方库的取舍。
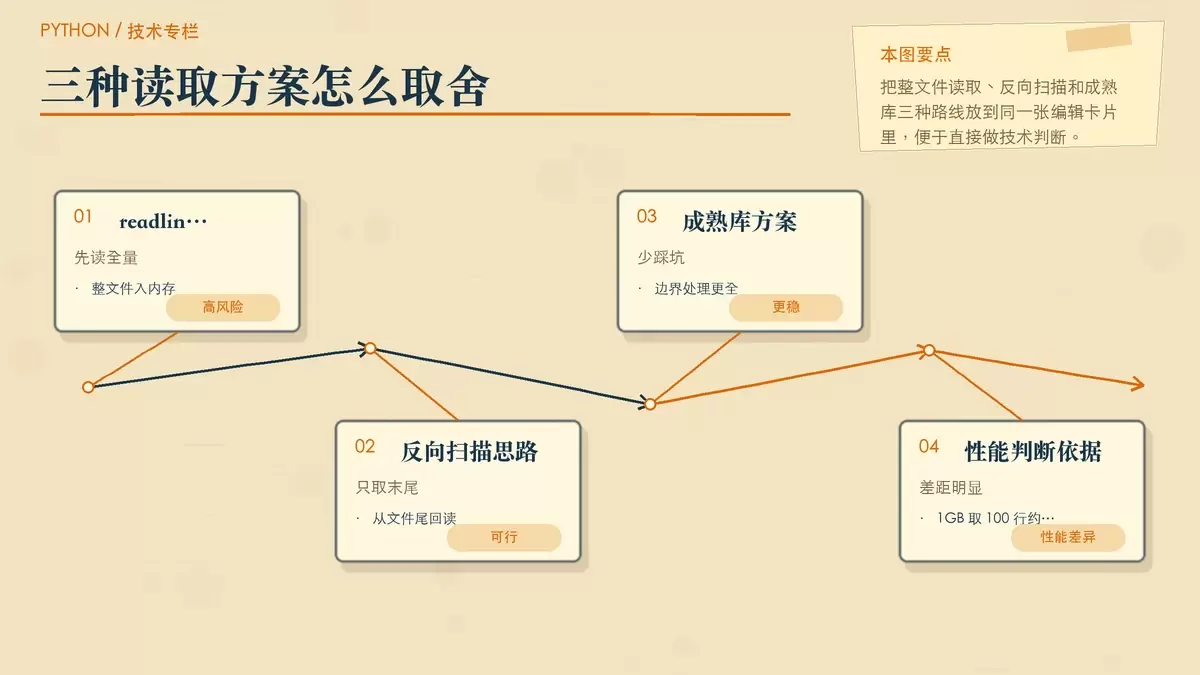
Jupyter Notebook 启动时报出“No module named”时,问题通常不在“少装了一个包”,而在环境路径、依赖版本或命令入口错位。本文围绕最常见的 `jupyter_server.contents` 报错,拆开说明触发原因、检查方法,以及一套更省时间的修复与重建环境思路。
这篇文章把一个抓取慕课网免费课程的 Scrapy 示例,整理成可直接复用的完整流程:从按课程类型翻页抓取,到进入详情页补齐难度、时长、评分,再通过接口拿到学习人数,最后异步写入 MySQL。代码事实、命令和表结构均保留,方便对照落地。
Java 严格来说并没有像部分函数式语言那样“独立存在”的匿名函数,但从 Java 8 开始,开发者已经可以用 Lambda 表达式完成绝大多数匿名函数式写法。本文从匿名内部类到 Lambda 的演进讲起,再对比 JavaScript、Python 和 Scala,帮你判断 Java 的边界与适用场景。
Go 不只适合写独立程序,在 Windows 场景里也能编译成 DLL,供 C/C++、Python、C# 等程序调用。本文从环境准备、最小可用示例到导出规则和字符串处理案例,梳理 Go 构建 Windows 动态链接库时最容易踩到的类型、内存和调用约束。
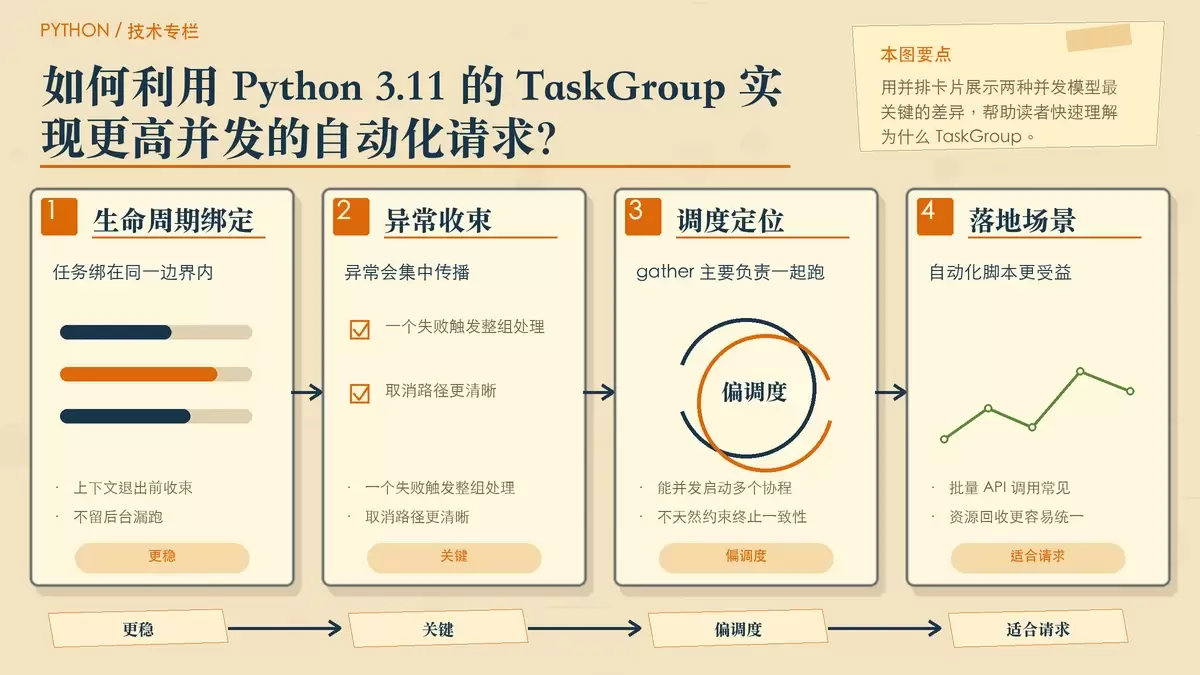
Python 3.11 的 TaskGroup 不是单纯替代 asyncio.gather 的新写法,而是把并发任务的生命周期、异常传播和取消行为收紧到同一上下文里。对于批量 API 调用、自动化抓取这类场景,它能显著减少漏取消、异常失控和资源回收混乱的问题,但并发效果仍取决于连接池、限流和超时策略。
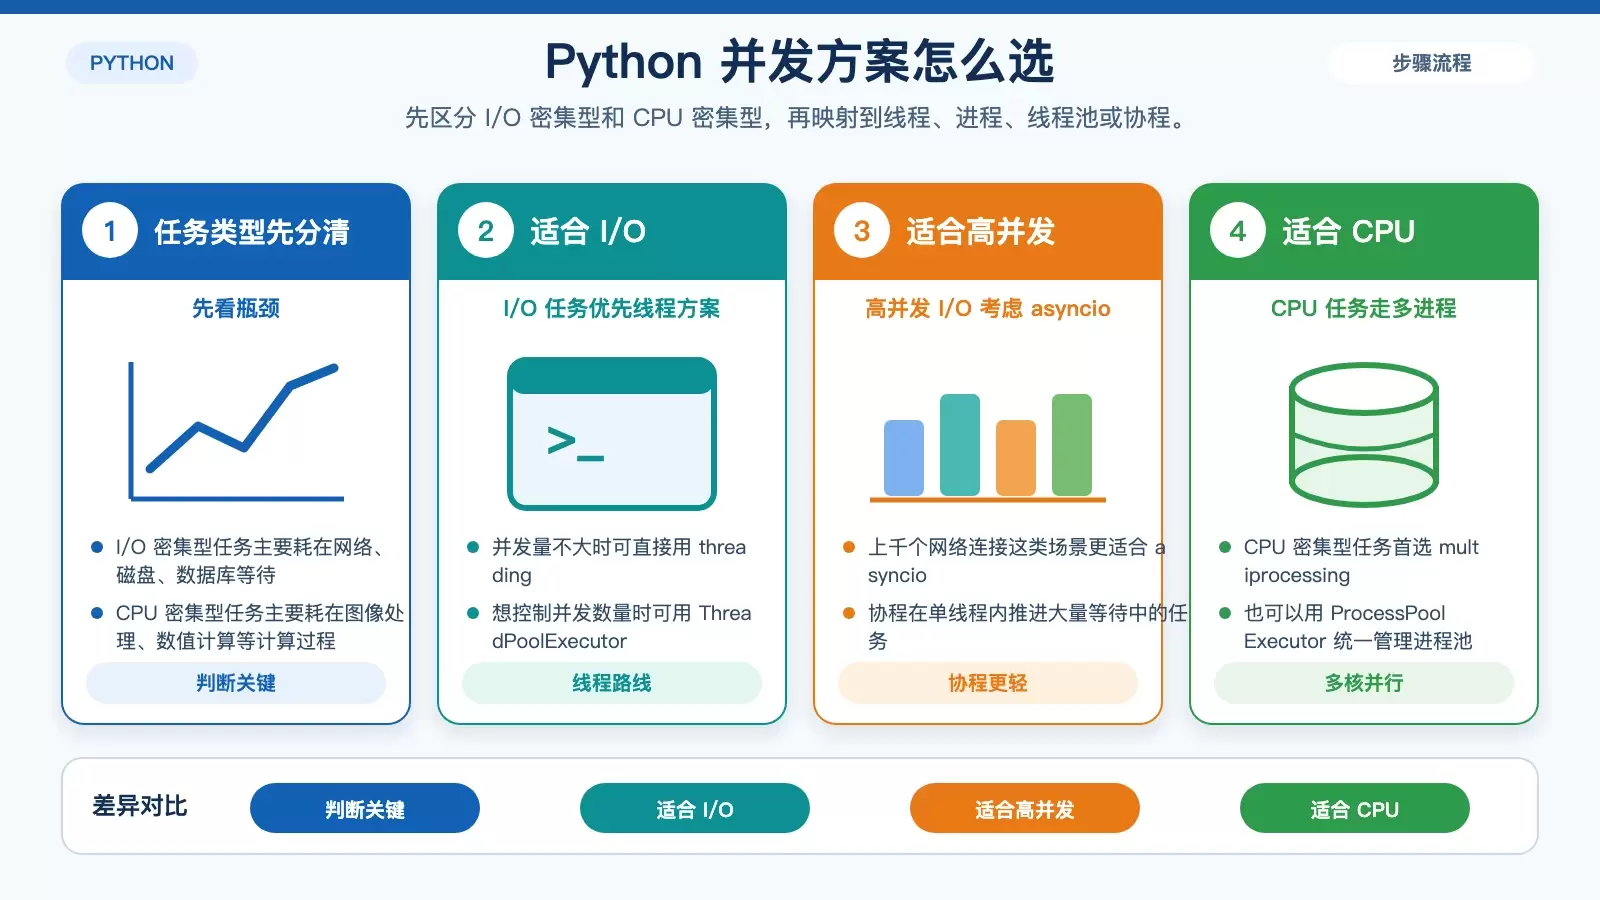
在 CentOS 上做 Python 并发,关键不在“能不能并发”,而在任务类型和工具是否匹配。本文把 `threading`、`multiprocessing`、`concurrent.futures` 与 `asyncio` 的适用场景、限制和示例代码拆开说明,帮助你快速判断该用线程、进程、线程池还是协程。 在 CentOS 上做 Python 并发,真正难的不是把任务“同时跑起来”,而是根据任务瓶颈选对模型。