


批量请求脚本常见的问题,并不只是“怎么把任务一起跑起来”,而是某个请求失败后,其余任务该不该停、超时怎么回收、异常最后由谁统一处理。Python 3.11 引入的 TaskGroup,正是为这类自动化场景补上结构化并发这一层约束。
下面从 TaskGroup 和 asyncio.gather 的差异讲起,再看一个带超时与错误收集的请求函数,最后拆解并发上不去时最常见的瓶颈,以及多层自动化脚本里该怎么嵌套使用,帮助你判断它是否适合自己的请求任务。
TaskGroup 和 asyncio.gather 到底差在哪
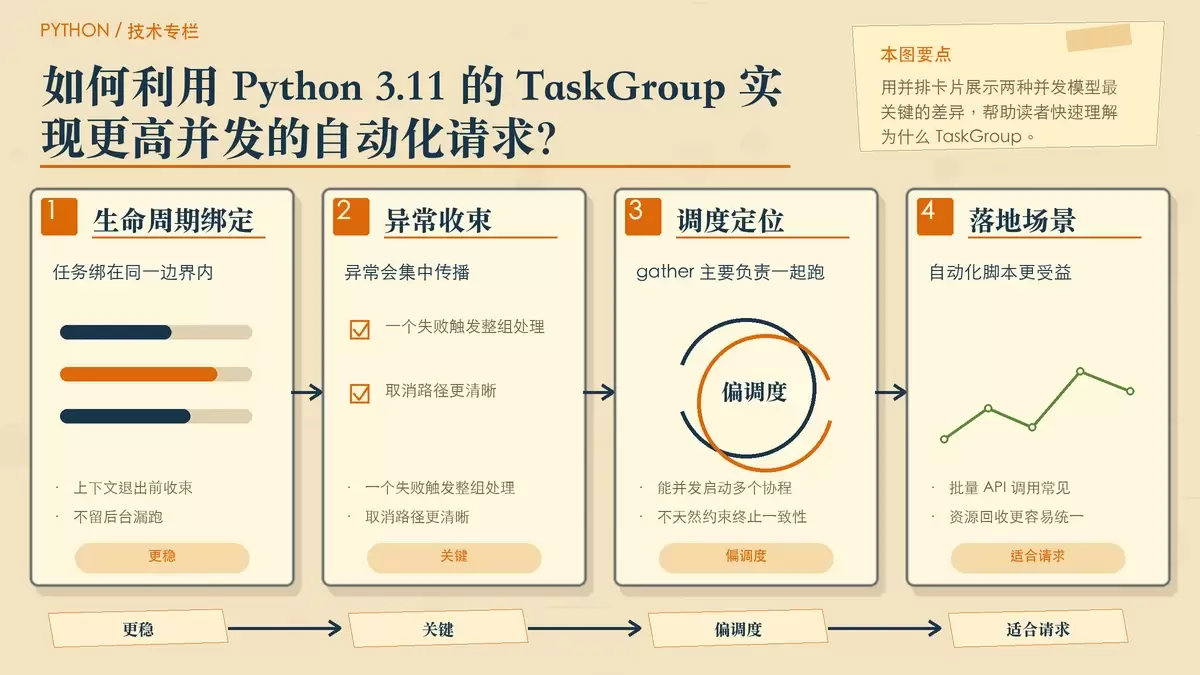
TaskGroup 是 Python 3.11 引入的结构化并发机制。它的核心不在于“让任务并发执行”,而在于把所有子任务的生命周期绑定到同一个上下文里:在 TaskGroup 退出前,这批任务要么全部完成,要么因为异常被统一取消,不会留下脱离控制的后台任务。
相比之下,asyncio.gather 更接近一个并发调度工具。它可以把多个协程一起提交执行,但不会像 TaskGroup 那样天然约束任务边界。某个任务抛出未处理异常后,其他任务是否继续运行、何时结束、异常如何回传,往往需要调用方自己额外兜底。
这也是两者最本质的区别:
TaskGroup强调任务必须在同一并发边界内收束,异常与取消行为更集中。asyncio.gather侧重“同时跑起来”,但对任务终止一致性和错误传播的约束更弱。
如果你的脚本需要批量调用第三方 API,并且很在意超时、失败、限流后的收尾是否干净,TaskGroup 往往更合适。它不能直接提升网络速度,但能让并发请求在出错时更可控,减少资源清理和状态残留问题。
如何写一个带超时和错误聚合的并发请求函数
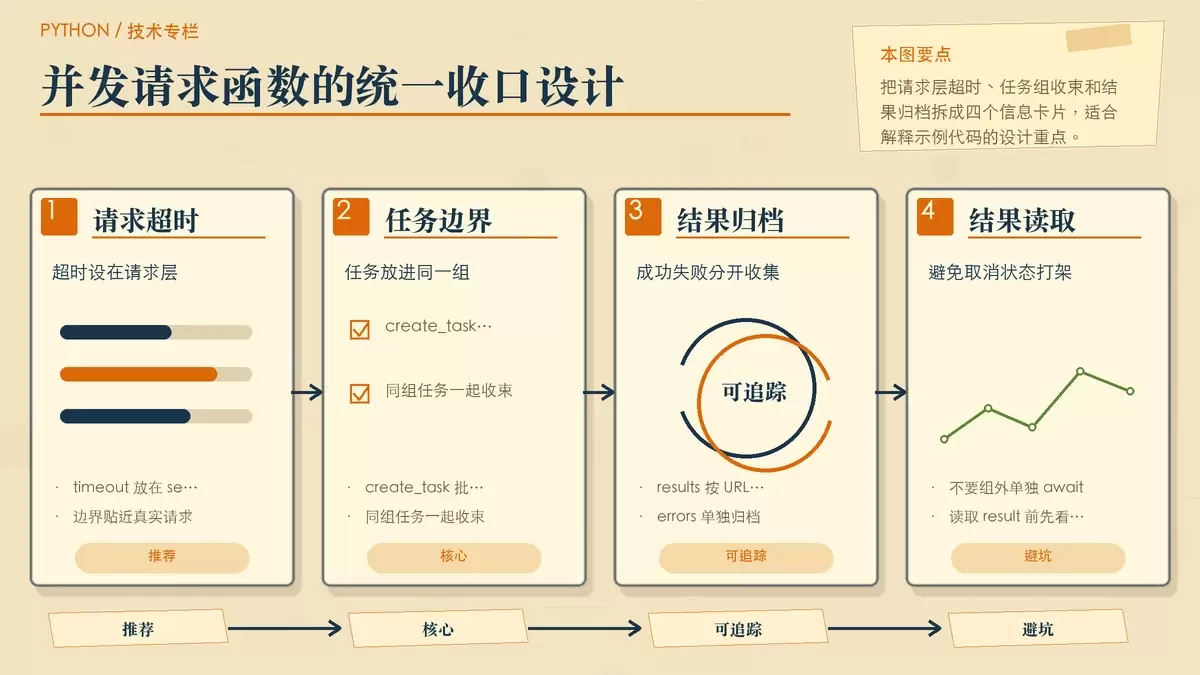
并发请求的关键从来不是“任务越多越好”,而是每个请求都要有独立超时、可区分的异常类型,以及一处统一收口的结果处理逻辑。下面这个例子保留了原始思路:用 aiohttp 发请求,用 TaskGroup 管理这一批任务的生命周期。
import asyncio
import aiohttp

async def fetch_with_timeout(session, url, timeout=5):
    try:
        async with session.get(url, timeout=timeout) as resp:
            return await resp.text()
    except asyncio.TimeoutError:
        raise TimeoutError(f"Request to {url} timed out")
    except aiohttp.ClientError as e:
        raise ConnectionError(f"Network error for {url}: {e}")

async def batch_fetch(urls):
    async with aiohttp.ClientSession() as session:
        results = {}
        errors = {}

        async with asyncio.TaskGroup() as tg:
            tasks = {
                url: tg.create_task(fetch_with_timeout(session, url))
                for url in urls
            }

        # 所有任务已结束,逐个取结果或异常
        for url, task in tasks.items():
            if task.done() and not task.cancelled():
                try:
                    results[url] = task.result()
                except Exception as e:
                    errors[url] = e

        return results, errors
这段写法里,真正值得注意的是下面三点。
1. 任一未处理异常会影响整组任务
只要 TaskGroup 内某个任务因为未处理异常退出,任务组会立即取消其余仍在运行的任务。对于“要么这一批都成功,要么尽快停止”的自动化请求,这是很实用的默认行为,因为你不需要再手工追踪还有哪些请求留在半路。
2. 不要把单个 task 拿到组外再单独 await
离开 TaskGroup 上下文后,任务的最终状态可能已经是完成、失败或被取消。此时如果还在组外单独等待某个 task,很容易和整体取消逻辑打架;直接读取 task.result() 时,也可能遇到 CancelledError。更稳妥的做法,是像示例这样,在任务组收束后统一遍历结果。
3. 超时最好放在请求层,而不是包住整个 create_task
示例把 timeout=timeout 放在 session.get() 这一层,而不是使用 asyncio.wait_for 去包裹整个 create_task。这样做的好处是超时边界更贴近网络请求本身,取消也更干净,不容易留下难处理的半开状态。
对于批量请求脚本,这种结构的价值在于:你不只是“发出一批请求”,而是同时拿到了统一的任务边界、清晰的错误分类,以及可回收的结果容器。后续无论要补重试、记录失败日志,还是按 URL 归档返回值,扩展都比较顺手。
并发数提不上去,问题通常不在 TaskGroup
很多人换上 TaskGroup 后,期待并发能力会明显上升;实际效果不明显时,往往会误以为是这个机制本身有性能问题。真实情况通常相反:大多数并发瓶颈都在网络层、连接池或系统限制,和 TaskGroup 本身关系不大。
原文提到的几个高频卡点,基本覆盖了日常自动化请求里最容易踩的地方。
连接池配置限制了单域名并发
aiohttp.ClientSession 虽然默认连接池上限是 100,但单域名默认只开 10 个并发连接。如果你的批量请求几乎都打到同一个域名,那么脚本里看起来已经创建了很多任务,真正同时出去的连接却可能只有 10 个。
这时要显式调整连接器配置,例如:
connector=aiohttp.TCPConnector(limit_per_host=50)这个参数不会让服务端一定更快响应,但至少能避免客户端自己先把并发掐死。
服务端限流会让“加并发”失去意义
如果目标接口本身有限流规则,比如 GitHub API 每小时 5000 次,那么本地并发再高,最后拿到的也可能只是更多的 429。这类场景里,真正该补的是退避、重试和节流策略,而不是继续把任务数量往上堆。
本地文件描述符不足会直接报错
在 Linux 环境里,文件描述符默认值经常只有 1024。并发 socket 太多时,脚本可能直接抛出 OSError: [Errno 24] Too many open files。这不是异步框架的问题,而是系统资源已经到顶。
处理方式通常有两类:一是提高 ulimit,二是尽量复用同一个 session,不要在高频请求中反复创建和销毁连接。
事件循环调度开销通常不是第一瓶颈
TaskGroup 自身并不限制并发数量。Python 事件循环的调度开销,往往要到几千个 task 的量级才会开始明显放大。对大多数日常脚本来说,优先排查连接、限流和系统资源,比急着把任务拆成更多批次更有效。
换句话说,TaskGroup 解决的是“这一批任务如何有边界地运行”,不是“为什么目标接口响应慢”。如果没有把底层约束理顺,换任何并发写法都不会有本质改善。
真实自动化脚本里,TaskGroup 该怎么嵌套
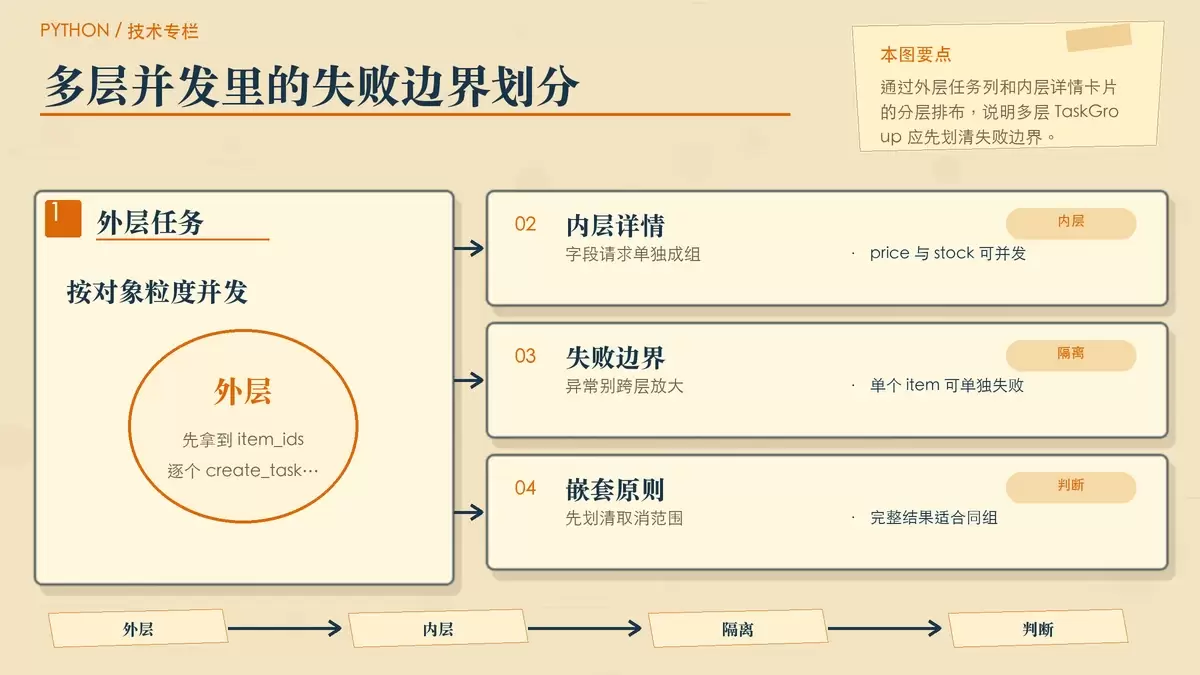
实际脚本很少只有一层并发。更常见的是两级甚至多级流程:先并发拿到一批 ID,再针对每个 ID 并发请求多个详情接口。看起来最直接的写法,是在外层 TaskGroup 里再套一层 TaskGroup;但真正的问题是,内外层的失败边界通常并不相同。
例如,外层负责调度所有 item_id,内层负责获取某个 item_id 的多个字段。此时你往往希望“单个 item 失败不拖垮整批 item”,而不是内层一个接口异常就把外层所有任务一起取消。
更稳妥的方式,是把内层并发封装成独立协程,让外层只负责创建任务,内层则自行处理本 item 范围内的异常:
async def fetch_item_details(item_id):
    async with aiohttp.ClientSession() as session:
        async with asyncio.TaskGroup() as tg:
            # 这里并发拉取该 item 的多个字段接口
            tg.create_task(session.get(f"/api/items/{item_id}/price"))
            tg.create_task(session.get(f"/api/items/{item_id}/stock"))
            # ... 其他子请求
    # 内层 TaskGroup 的异常在此处被捕获,不影响外层

async def main():
    item_ids = await fetch_all_ids()  # 第一层并发
    async with asyncio.TaskGroup() as tg:
        for item_id in item_ids:
            tg.create_task(fetch_item_details(item_id))  # 每个 item 独立生命周期
这里的核心思路不是“永远多套一层”,而是先划清哪一层应该共享失败命运,哪一层应该各自隔离。只要这个边界没想清楚,TaskGroup 套得再规范,也可能把取消范围放大到不符合业务预期。
在自动化脚本里,比较实用的判断方式是:
- 如果一组请求共同组成一个完整结果,那么适合放进同一个
TaskGroup,让失败统一收束。 - 如果每个对象彼此独立,单个失败不应影响全局,就把它们封装成独立协程,在更外层按对象粒度创建任务。
TaskGroup 适合解决什么问题
TaskGroup 不等于自动提速,也不是把 gather 替换掉就能立刻改善吞吐。它真正带来的,是更明确的并发边界:子任务必须在上下文内结束,异常会沿着任务组集中传播,取消行为也更容易推断。
对于自动化请求脚本,这种能力尤其有价值,因为批量任务最怕的不是单次请求慢,而是某个请求失败后,其余任务还在继续跑、连接没收干净、错误分散在不同地方。使用 TaskGroup 后,这些问题至少有了统一收口点。
但最终能不能把脚本跑稳、跑快,仍然取决于几个老问题:连接池怎么配、超时设在哪一层、服务端有没有限流、本地文件描述符是否够用、失败后要不要退避重试。把这些基础项补齐,再让 TaskGroup 管住并发生命周期,才是更接近生产环境的写法。









