


想快速查看大文件末尾几行日志,最省事的办法其实不是自己写脚本,而是直接交给系统工具处理。下面按“什么时候直接用命令、什么时候才需要 Python、自己实现会踩哪些坑”的顺序梳理,方便你根据文件大小、运行环境和稳定性要求做判断。
命令行场景下,优先直接用 tail -n N
如果目标只是“拿到最后 N 行”,而且运行环境就是 Linux、macOS 或带有同类工具的终端环境,最快的方式仍然是:
tail -n N filename这类工具本来就是为日志场景设计的,处理大文件时通常比临时写一段 Python 更稳,也更快。对于单次排查、线上日志查看、脚本拼接等场景,直接调用系统命令往往就是最佳解。
换句话说,只有在你必须把“取最后 N 行”嵌进 Python 逻辑里,比如后续还要做解析、过滤、告警或 API 返回时,才值得继续考虑 Python 方案。
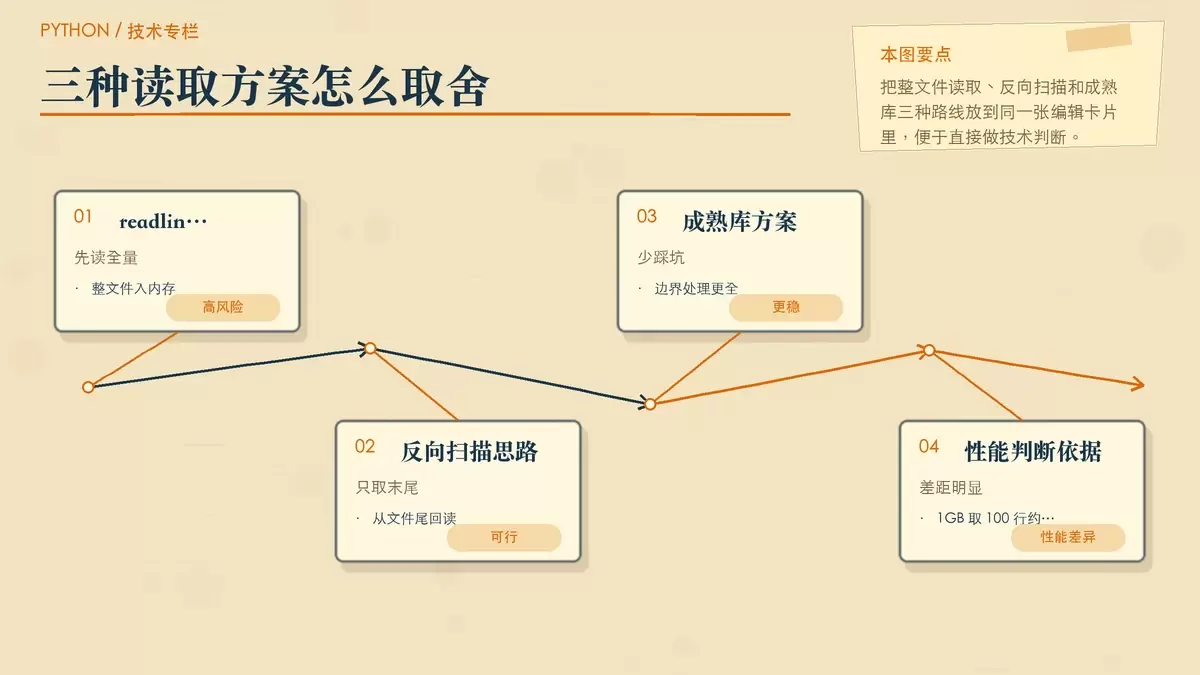
为什么不建议用 readlines()[-N:]
很多人第一反应会写成 readlines()[-N:],问题在于它会先把整个文件完整读进内存,再做切片。文件一旦上到 GB 级,这个写法的风险就非常明显了。
典型问题包括:
- 一个 10GB 日志文件,可能直接触发
MemoryError - 即使机器内存勉强装得下,也要完整遍历全部内容,I/O 和 CPU 都会被白白消耗
- 你真正只关心最后 N 行,但执行成本却和整个文件大小绑定,时间复杂度接近 O(file_size)
这种写法只适合非常小的文件,例如文件小于 1MB,且只是偶尔读几行。可一旦场景已经变成“大文件日志”,它基本就不属于“快速读取”的范畴了。
必须用 Python 时,做法是从文件末尾反向读取
要避免把整份文件搬进内存,核心思路很简单:从文件尾部开始按字节往前找换行符,凑够 N 行就停止。这样读到哪里停到哪里,内存只保留最后几行内容,不需要扫描完整文件。
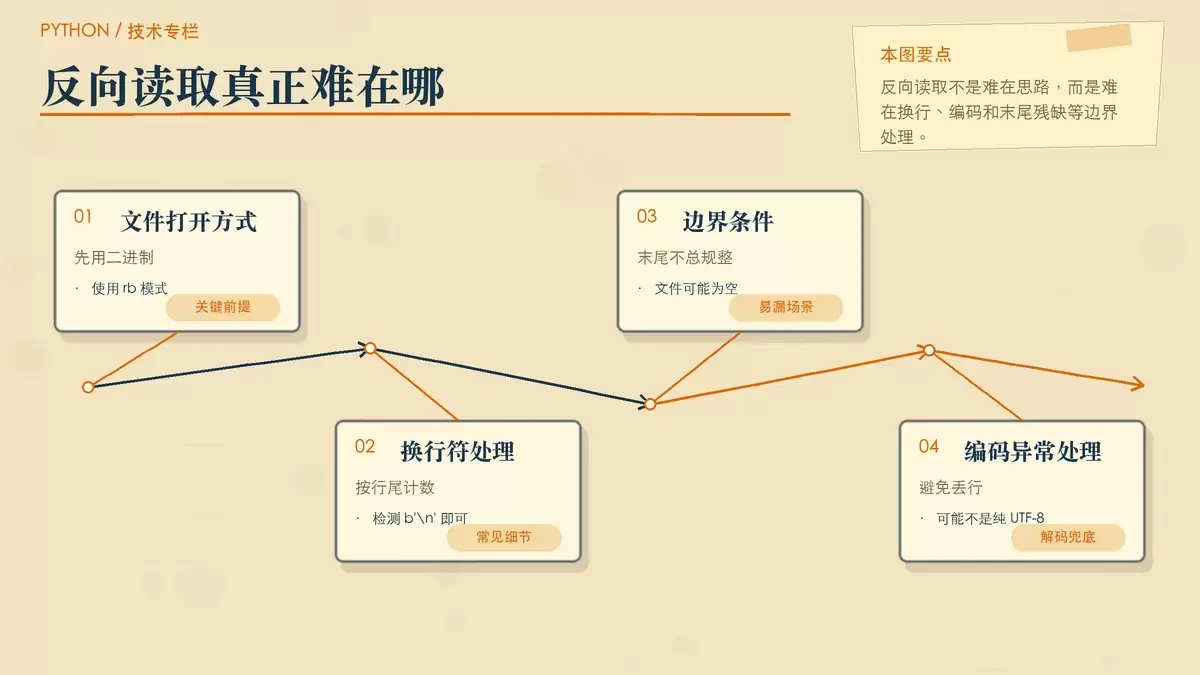
实现时有几个关键前提:
- 要使用
os.open()或open(..., 'rb')这样的二进制模式,才能按字节精确定位偏移 - 换行判断通常检测
b'\n'即可,因为 Windows 的\r\n结尾里同样包含\n - 空文件、最后一行没有换行符、N 大于总行数这些情况,都需要额外处理
下面这段示例代码展示了基本思路:
def tail(filename, n=10):
with open(filename, 'rb') as f:
f.seek(0, 2)
file_size = f.tell()
lines = []
buffer = b''
offset = 1
while len(lines) < n and file_size - offset >= 0:
f.seek(file_size - offset)
char = f.read(1)
if char == b'n':
if buffer:
lines.append(buffer[::-1].decode('utf-8', errors='replace'))
buffer = b''
else:
buffer += char
offset += 1
if buffer and len(lines) < n:
lines.append(buffer[::-1].decode('utf-8', errors='replace'))
return lines[::-1]
这类方案的优点是明确:不依赖行长、不加载全文,内存占用基本恒定,只跟要返回的 N 行有关。
反向扫描看起来简单,细节却不少
真正难的地方不在“从后往前读”这个动作本身,而在日志文件现实中并不总是规整。比如:
- 编码可能不是纯 UTF-8,解码时要考虑
errors='replace'之类的兜底 - 不同系统或工具产出的换行符可能混用,
\r\n、\n甚至异常截断都可能出现 - 最后一行未换行、空行连续出现、超长行、BOM、字符被截断等边界情况,都会影响结果是否丢行
因此,自己手写这段逻辑更适合“明确知道日志编码和换行约定”的场景。如果文件来源复杂,或者这段逻辑要进入生产环境,稳定性通常比“能跑通一次”更重要。
更稳妥的办法:直接用成熟库
如果你不是为了学习底层实现,而是为了在项目里稳定读取日志末尾内容,用现成库通常更划算。它们已经替你处理了不少边界 case,维护成本也低很多。
文中提到的两个方向分别是:
filetail:功能更完整,支持指定编码、最大行长限制logtail:更轻量,但只支持 UTF-8,对\r\n混合情况处理有限
安装与调用方式例如:
pip install filetailfrom filetail import tail兼容性方面,给出的结论是 Python 3.6+ 可用,Windows 下测试过 filetail 行为一致,macOS 和 Linux 没有明显差异。
性能对比也很直接:1GB 日志读取最后 100 行时,filetail 耗时约 0.02s,而 readlines() 超过 30s,并伴随明显内存上涨。对大文件来说,这个差距已经足够决定技术选型。
怎么选,取决于你是临时排查还是要进生产
如果只是临时查看日志末尾内容,直接用 tail -n N 最省事,通常也最快。要把功能集成进 Python 程序里,就应避免 readlines()[-N:] 这类整文件读取方式,改用二进制反向扫描。
但只要场景进入生产环境,尤其日志来源多、编码不统一、系统平台不固定时,优先考虑 filetail 这类经过验证的实现会更稳。简单说:
- 命令行能解决时,用
tail -n N - Python 内部少量定制、文件规则明确时,可以手写反向扫描
- 生产环境或复杂日志格式,优先成熟库,而不是临时拼一段看似能跑的代码









