

Python pandas DataFrame排除特定行的实现方法
本文介绍在Python pandas中如何排除DataFrame中的特定行。虽然pandas提供了[[wp:a0]]方法用于筛选包含特定值的行,但缺乏直接排除的API。文章通过示例演示了将列值转为列表、移除不需要的元素后再次使用[[wp:a5]]来实现反向筛选的技巧,帮助开发者解决复杂的数据过滤需求。
2026-10-13
6

本文介绍在Python pandas中如何排除DataFrame中的特定行。虽然pandas提供了[[wp:a0]]方法用于筛选包含特定值的行,但缺乏直接排除的API。文章通过示例演示了将列值转为列表、移除不需要的元素后再次使用[[wp:a5]]来实现反向筛选的技巧,帮助开发者解决复杂的数据过滤需求。
本文深入解析Python标准库json模块,详细阐述JSON格式与Python数据类型的对应关系,包括字典、列表、字符串等类型的转换规则。同时对比分析dump、dumps、load、loads四个核心函数的适用场景,帮助开发者掌握数据序列化与反序列化的最佳实践。
本文详解Python标准库string模块中的字符串常量,并深入剖析Template类的用法。通过对比Template、%格式化及format()方法,展示Template类的优势。重点讲解如何通过继承Template类并重写delimiter和idpattern属性,利用正则表达式自定义变量名匹配规则,实现更灵活的字符串模板替换。
本文详细介绍在 Python 中使用 Pandas 库对 DataFrame 进行行与列求和,并将结果作为新列或新行添加至数据框末尾的具体操作方法。通过导入模块、生成随机数据及应用 apply 函数,实现数据的汇总与扩展,为数据分析提供基础支持。
本文详解Python爬虫中常见的403禁止访问错误原因,介绍通过urllib2模块添加User-Agent、Host和Referer等请求头来伪装浏览器访问的方法,并提供封装好的随机User-Agent选择函数代码,帮助开发者绕过基础反爬限制。
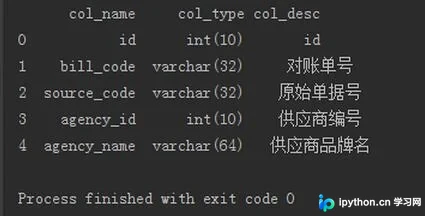
本文详解Python 3环境下使用PyMySQL连接MySQL数据库的完整流程。涵盖数据库创建、表结构查看、数据插入与查询操作,重点解析事务回滚机制对自增ID的影响,以及利用executemany实现高效批量数据插入的实战技巧。
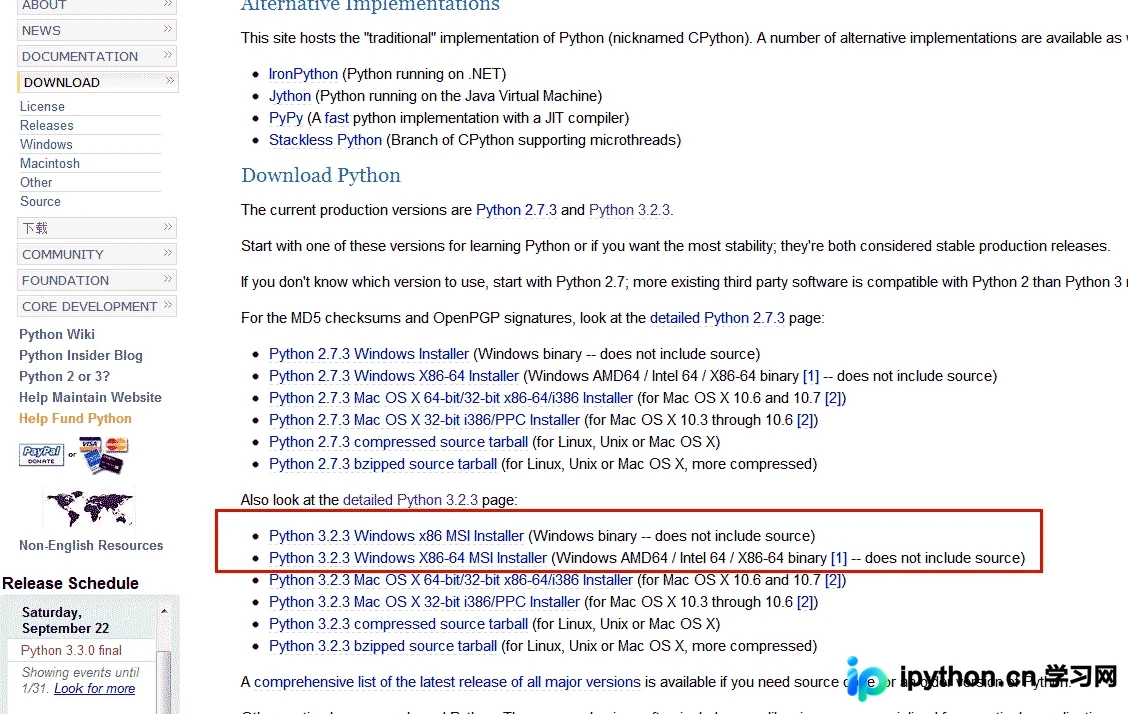
本文详细介绍在Windows系统中安装Python 3.2版本并配置Aptana Studio集成开发环境的全过程。内容涵盖从官网下载、环境变量设置到命令行验证,以及通过PyDev插件实现Python项目创建、解释器配置及Hello World程序运行的完整步骤,帮助开发者快速上手Python开发。
本文详细介绍Python标准库中的atexit模块,重点讲解register函数如何注册解释器正常终止时自动执行的清理函数。内容涵盖注册顺序(后进先出)、异常处理机制、装饰器与非装饰器两种注册方式,以及unregister函数的使用,帮助开发者在程序退出时可靠地释放资源。
本文介绍在 Python 3.6 和 Windows 64位环境下,利用 pymysql 建立数据库连接并配置字符集,结合 pandas 模块执行 SQL 查询语句以读取 MySQL 数据库表数据的具体实现方法。
本文介绍如何利用Python和PHP脚本将大型文本文件按固定行数分割为多个小文件。通过示例演示了从21行数据分割为5个文件的过程,重点解析Python实现逻辑及PHP替代方案,帮助用户高效处理海量数据分割任务。
本文介绍Python客户端与Java服务端通过Socket进行通信并传输文件的核心实现。Java服务端监听端口接收连接,Python客户端发送文件名及二进制数据流。代码展示了多线程处理并发连接及文件分块发送机制,适用于需要跨语言交互的场景。
本文详细记录在 CentOS 6.4 系统中通过源码编译安装 Python 2.7.3 的全过程。内容涵盖编译前依赖库(zlib、openssl、bzip2)的安装、Configure 配置修改、编译安装步骤,以及因 Python 版本更替导致 yum 失效后的修复方法。最后介绍了 setuptools 和 pip 1.3.1 的安装与软链接配置,适用于需要特定旧版 Python 环境的服务器场景。