

Python Pandas数据清洗实战:合并、转换、过滤与排序详解
本文深入讲解Python Pandas库在数据清洗中的核心操作。涵盖merge函数的多种连接方式(inner, outer, left, right)及列名指定;介绍combine_first处理重叠数据的方法;详解数据重塑与轴向旋转;演示删除重复行、替换值及分段统计(cut/qcut);最后解析随机排列与采样技巧,助力高效数据预处理。
2026-10-13
9

本文深入讲解Python Pandas库在数据清洗中的核心操作。涵盖merge函数的多种连接方式(inner, outer, left, right)及列名指定;介绍combine_first处理重叠数据的方法;详解数据重塑与轴向旋转;演示删除重复行、替换值及分段统计(cut/qcut);最后解析随机排列与采样技巧,助力高效数据预处理。
本文详解Python中SyntaxError: non-keyword arg after keyword arg错误的成因,指出在函数定义中*arg与**kwargs的顺序至关重要。正确做法是将*arg置于**kwargs之前,否则触发语法报错。文章提供代码示例及修正方案,帮助开发者快速定位并解决此类参数传递问题。
本文介绍在 Python 3 中解决 MySQLdb 不支持的问题。由于 MySQLdb 仅支持 Python 2.x,Python 3 环境下推荐使用 pymysql 作为替代。针对 Django 默认调用 MySQLdb 导致的 ImportError,通过在 __init__.py 中添加 pymysql.install_as_MySQLdb() 实现兼容,确保项目正常运行。
本文对比了Python中生成Word和PDF的几种主流方案。针对Word导出,分析了unoconv对静态HTML的支持及其对异步数据和JS图表的局限,以及python-docx在格式控制上的不足。针对PDF导出,重点介绍了基于WebKit内核的pdfkit,指出其高保真度优势及对JS生成图表支持的缺失,并简要提及weasyprint等替代方案。
本文详细介绍Python中NumPy库的基础用法,涵盖数组创建、维度与数据类型查看、基础加减乘除运算、索引切片、布尔索引、ufunc函数(如meshgrid和where)、数学统计、矩阵乘法及随机数生成。通过具体代码示例,帮助开发者掌握高效数据处理的核心技能。
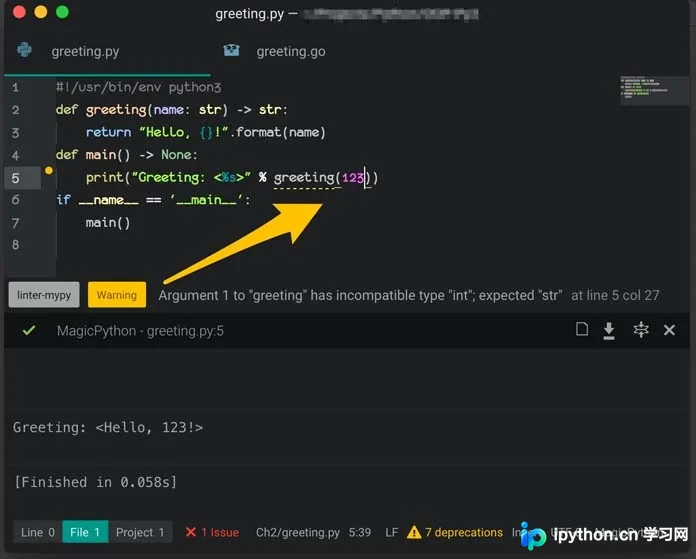
本文介绍Python 3.5+引入的类型提示(Type Hints)机制,涵盖PEP 484与PEP 526语法规范。详细讲解如何使用官方推荐工具Mypy进行静态类型检查,包括IDE集成配置及Python 2.x兼容方案。通过对比C、Go等语言,分析动态类型与静态类型的优劣,帮助开发者在保持Python灵活性的同时提升代码可维护性。
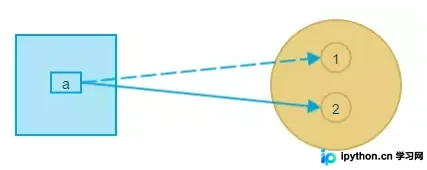
本文深入解析Python中i += x与i = i + x的等价性问题。通过对比整数与列表的操作结果,揭示两者在调用__iadd__与__add__方法时的本质差异。重点阐述可变对象与不可变对象的内存行为,指出对列表使用+=可能引发的潜在Bug,帮助开发者避免常见的引用错误。
本文详解在Windows系统中同时安装Python 2.7与Python 3的方法。通过利用系统自带的py启动器,无需重命名主程序即可指定版本运行脚本。文章介绍了在脚本首行指定版本、命令行使用py命令以及pip模块调用的具体操作,确保双版本环境下的开发效率。
本文详细介绍在Ubuntu系统中使用virtualenv和Virtualenvwrapper创建及管理独立Python虚拟环境的全过程。涵盖从安装工具、创建名为myvenv的环境,到激活、退出及常用命令操作,帮助开发者实现项目依赖隔离,避免系统Python版本冲突,提升开发效率。
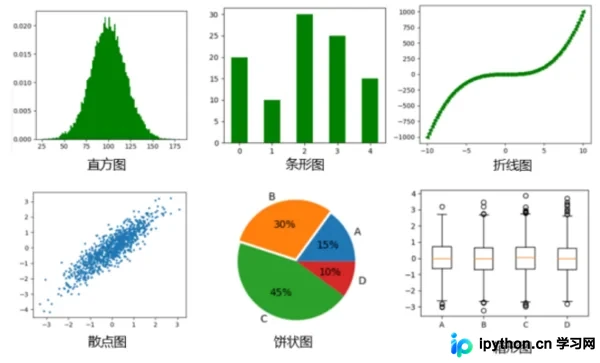
本文系统介绍Python中Matplotlib库的绘图方法,涵盖直方图、条形图、折线图、散点图、饼图及箱形图的实现代码。同时详解23种点形状、8种内置颜色、4种线性样式,以及子图布局、网格生成和图例添加等图像调整技巧,帮助开发者快速掌握数据可视化核心技能。
本文系统介绍Python中的五种核心数据类型:整数支持任意大小及十六进制表示;浮点数涵盖科学计数法及精度特性;字符串由单双引号定义;布尔值包含True/False及逻辑运算;空值None表示特殊无意义状态。掌握这些基础类型是Python编程的关键。
本文详细解析在Python中实现守护进程(Daemon)的方法。通过两次fork机制、setsid会话创建及文件描述符重定向等技术,使程序脱离终端控制并常驻后台。文章提供了完整的Python代码实现,并深入解释了fork原理、umask权限掩码、进程组与会话组的区别,以及守护进程与后台进程的核心差异,帮助开发者掌握Linux环境下的服务常驻技巧。