

Python爬虫效率优化:单线程、多线程、多进程与协程性能对比
本文通过实测对比单线程、多线程、多进程及aiohttp协程四种方式在Python爬虫中的表现。结果显示,处理十万级页面时,aiohttp协程方案比单线程快90倍,多线程提升68倍,多进程提升7倍。文章提供了各方案的代码实现与耗时数据,为提升爬虫并发效率提供实用参考。
2026-10-14
6

本文通过实测对比单线程、多线程、多进程及aiohttp协程四种方式在Python爬虫中的表现。结果显示,处理十万级页面时,aiohttp协程方案比单线程快90倍,多线程提升68倍,多进程提升7倍。文章提供了各方案的代码实现与耗时数据,为提升爬虫并发效率提供实用参考。
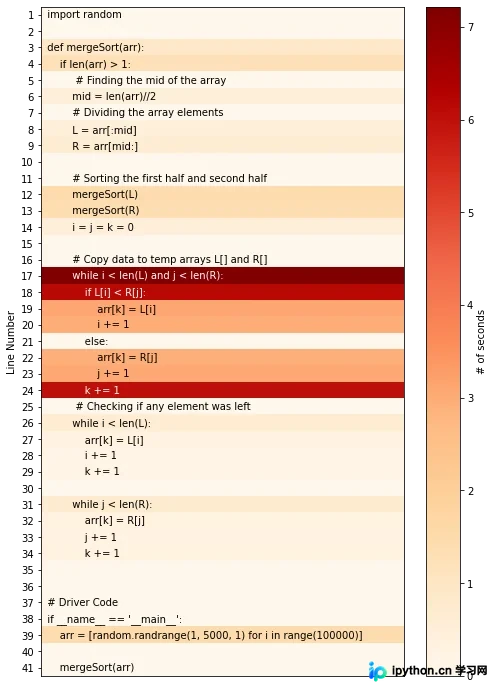
本文介绍了三个用于Python代码性能可视化的开源库:Pyheat、Heartrate和Snoop。Pyheat通过热图展示逐行执行时间,帮助定位耗时代码;Heartrate提供浏览器端的实时执行可视化,显示每行代码的执行次数;Snoop则利用装饰器追踪局部变量和执行流程,辅助调试。这些工具仅需少量代码即可深入分析性能瓶颈。
本文深入探讨Python3中读取文件指定行的三种主流方案。针对大文件场景,对比了基于readline的逐行遍历、linecache模块以及调用系统sed命令的执行效率。测试显示,读取5000万行时,sed方案耗时仅约2.5秒,显著优于纯Python实现的10秒以上耗时,为高性能数据处理提供了实用参考。
本文详细介绍Python中两种核心性能分析工具:内置的cProfile和第三方的line_profiler。通过具体代码示例,演示如何定位函数级耗时瓶颈及逐行分析执行时间,帮助开发者从宏观到微观优化Python代码性能。
本文整理了编写Python程序的90条核心建议,涵盖从理解Pythonic概念、基础语法陷阱、标准库使用到高级内部机制及性能优化的全方位内容。文章详细讲解了变量命名、函数设计、异常处理、模块导入、数据结构选择、并发编程及调试工具的使用,旨在帮助开发者写出更优雅、高效且易于维护的Python代码。
本文深入解析 Python 全局解释器锁(GIL)的起源、历史移除尝试及当前现状。从单核时代的引用计数机制到多核时代的性能瓶颈,探讨了为何 GIL 难以移除。分析了 Greg Stein 等早期尝试失败的原因,以及 Python 3.2 对 GIL 的优化。结论指出,鉴于庞大的 C 扩展生态和单线程性能考量,Python 移除 GIL 的可能性极低,开发者应通过多进程或异步编程规避其限制。
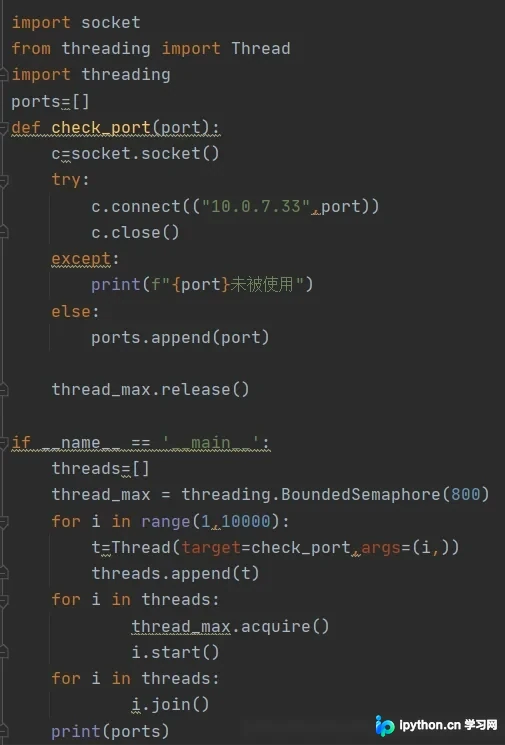
本文介绍使用Python对局域网IP进行端口扫描的实现方法。针对高并发场景下线程数超过800时系统报错的问题,通过限制单次并发线程数量,成功解决了“cannot start new thread”错误。优化后的脚本在不到1分钟内完成了1至10000端口的全量扫描,兼顾了稳定性与执行效率。
本文详解如何在 Python3 环境中利用 pybind11 调用 C++ 的 Eigen 库以解决循环计算性能瓶颈。内容涵盖从虚拟环境配置、依赖库安装到 C++ 代码编写、Python 接口定义及编译测试的全流程步骤,提供具体的代码示例与操作命令,帮助开发者实现高效的矩阵运算加速。
本文深入解析Python中字符串拼接的两种主要方式:使用加号(+)和使用join方法。由于Python字符串是不可变对象,+操作在多次拼接时会频繁申请新内存,导致效率低下;而join方法预先计算总长度,仅需一次内存分配,性能显著提升。文章通过原理分析与时间对比示例,说明在大量字符串拼接场景下,join是更优的选择,帮助开发者在实际编码中进行性能优化。
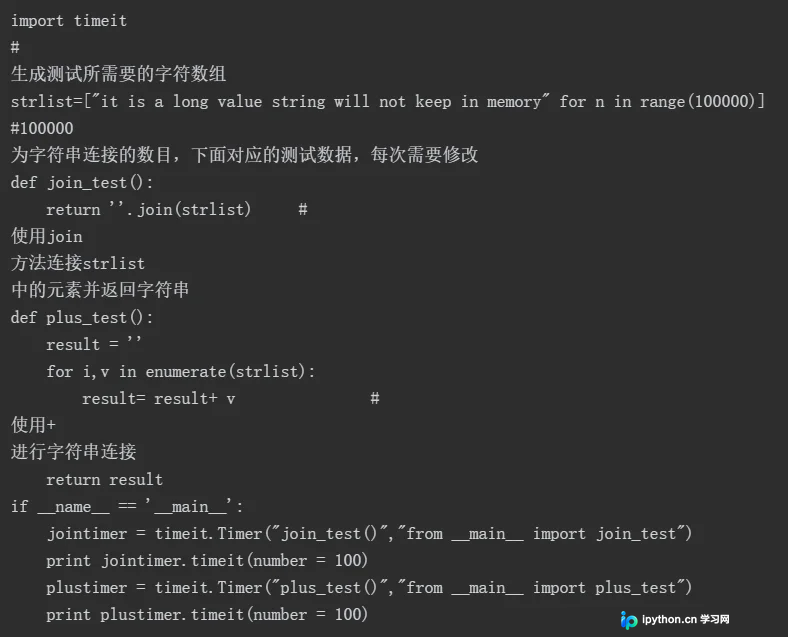
本文系统梳理Python Scrapy框架在爬虫开发中的关键注意事项。涵盖利用Redis实现分布式去重与存储、通过Middleware处理代理IP与Headers、合理配置Settings文件、使用FormRequest提交表单数据,以及结合PhantomJS处理动态渲染页面的技术方案。旨在帮助开发者提升爬取效率与稳定性,解决常见技术痛点。
本文澄清高并发与多线程的关系:高并发是系统面临大量请求的状态,多线程仅是解决手段之一。实现高并发需综合架构、网络、代码、JVM、数据库及硬件等多维度优化,单靠多线程无法解决所有瓶颈。
本文介绍如何使用 Python 的 grequests 库实现高效的并发 HTTP 请求。通过对比 requests 串行与 grequests 并发的性能差异,展示其在批量请求场景下的显著优势。内容涵盖安装配置、基本用法、性能测试数据及自定义异常处理机制,帮助开发者提升接口测试效率。