

Python利用memory_profiler查看内存占用情况
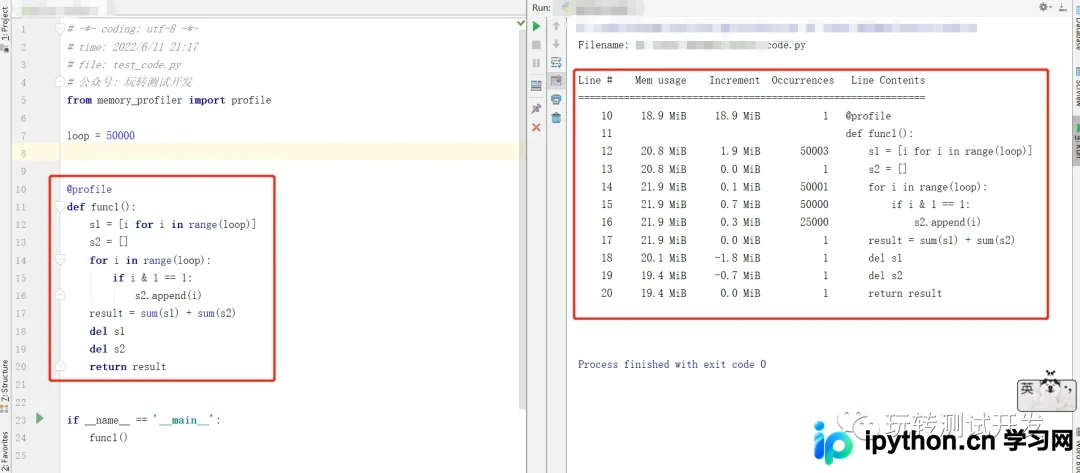
本文介绍Python第三方库memory_profiler的使用方法,用于监视进程内存消耗及逐行分析。通过装饰器@profile和命令行模式两种方式进行内存检测,支持终端直接打印或输出至文件并自定义精度,帮助开发者定位内存占用高的代码段。
2026-10-15
6

本文介绍Python第三方库memory_profiler的使用方法,用于监视进程内存消耗及逐行分析。通过装饰器@profile和命令行模式两种方式进行内存检测,支持终端直接打印或输出至文件并自定义精度,帮助开发者定位内存占用高的代码段。
本文深入剖析Python标准库中random.randint()函数运行缓慢的根本原因。通过对比random()与randint()的源码实现,揭示了参数校验、类型转换及位运算带来的额外开销。文章提供了三种更快的生成随机整数方法:利用random()缩放、直接调用getrandbits()以及使用Numpy批量生成,并附带具体性能测试数据,帮助开发者在大量随机数生成场景下做出最优选择。
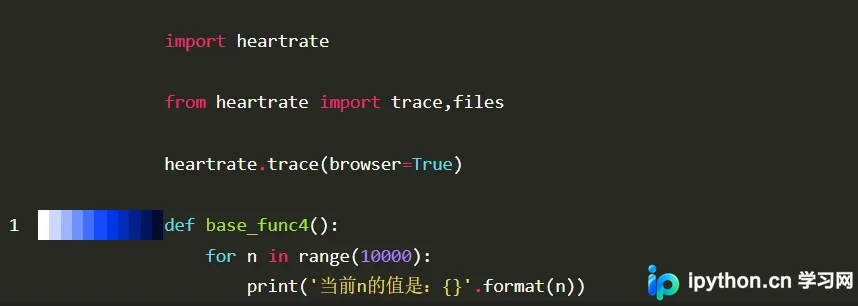
本文汇总了五款实用的Python性能检测工具,涵盖内存占用、运行耗时及代码行级分析。通过memory_profiler、timeit、line_profiler及heartrate等工具,结合具体代码示例,展示如何精准定位程序瓶颈,帮助开发者优化Python应用效率。
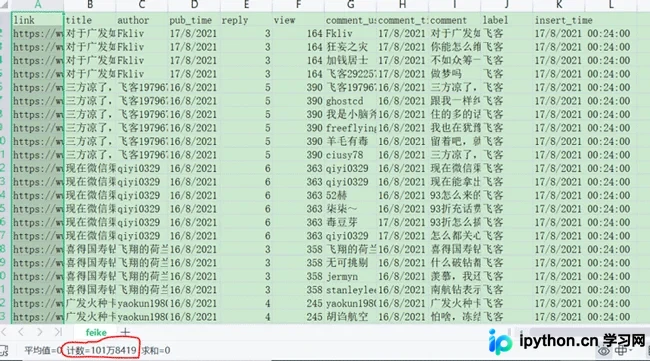
本文介绍如何使用pandarallel库实现Pandas数据的多进程并行处理,以显著提升数据清洗速度。通过对比单进程与多进程在处理100万条数据时的耗时,展示pandarallel在apply、map等操作中的加速效果,并附带完整代码示例。
本文通过实测对比Python中Numpy二维数组的两种遍历方式:双层循环与切片后一维遍历,并引入Numba JIT加速。结果显示,切片遍历通常更快,但Numba首次调用存在编译开销。文章详细解析了不同数据规模下的耗时差异及底层内存引用机制,为高性能计算提供实践参考。
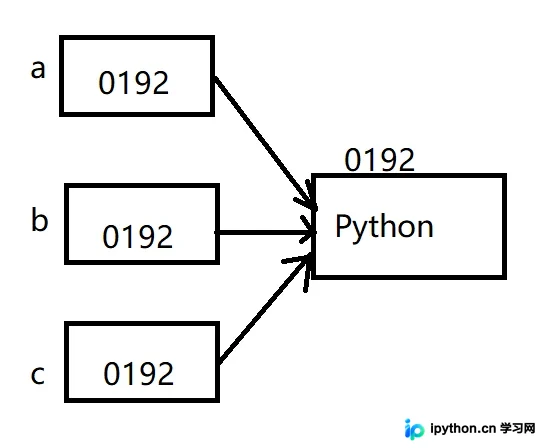
本文深入解析Python中字符串的不可变特性及驻留机制(String Interning)。详细阐述驻留机制在短字符串、标识符、编译期处理及[-5, 256]整数范围内的具体应用规则,并对比分析字符串拼接的性能差异。通过sys模块的intern方法实现强制驻留,建议在实际开发中优先使用join方法优化长字符串拼接,从而提升程序效率并节约内存资源。
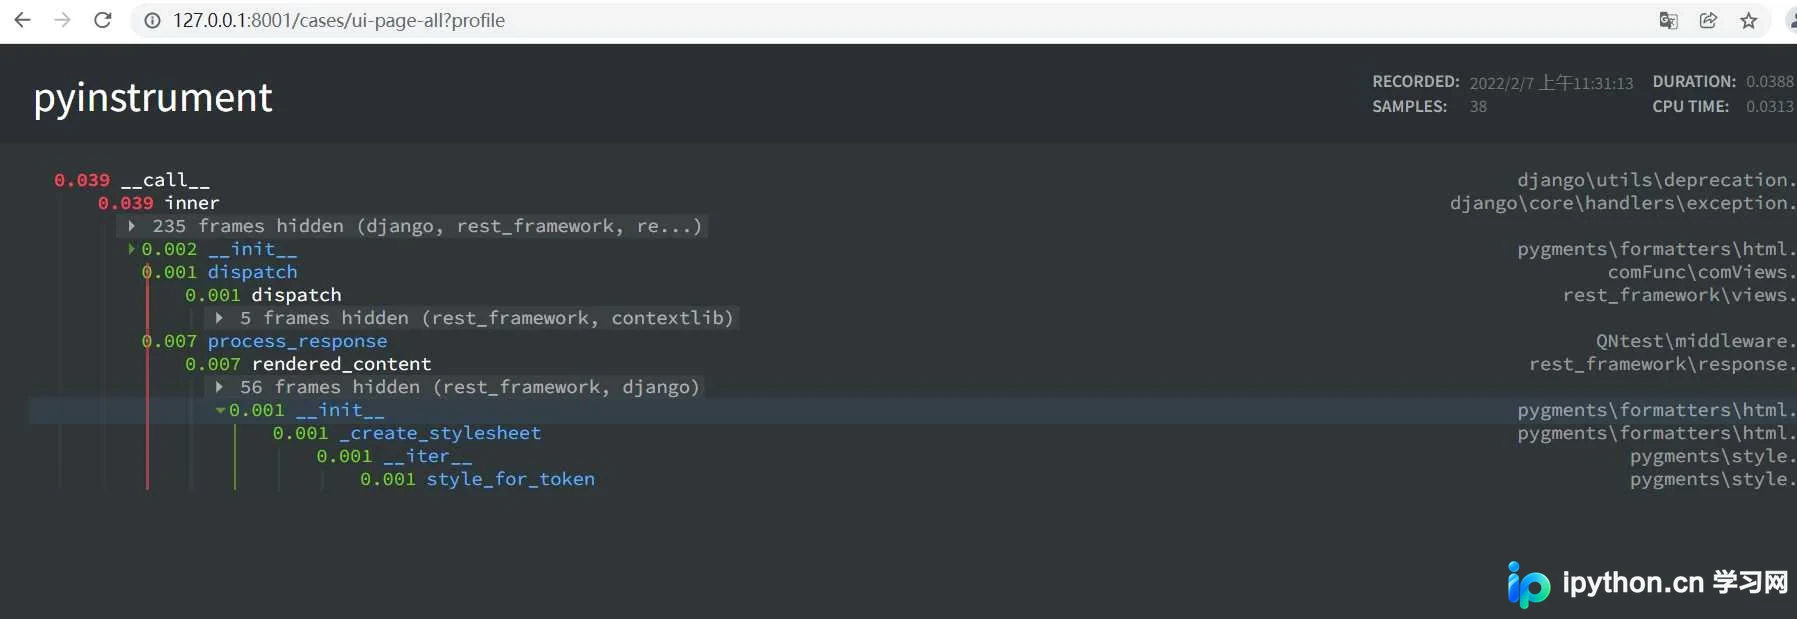
本文详细介绍Python性能分析库pyinstrument的安装与基础用法,展示如何通过可视化报告定位代码瓶颈。教程涵盖Django框架中的中间件集成方法及异步代码支持,并对比了pyinstrument与内置cProfile在系统开销上的差异,帮助开发者高效优化Python应用性能。
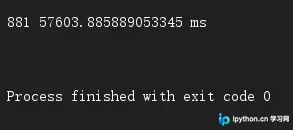
本文介绍如何利用Cython将Python代码编译为C语言以提升运行速度。通过一个寻找1000以内勾股数的示例,对比纯Python、Cython编译后以及Java实现的执行时间。结果显示,经过类型声明并编译为C后,耗时从57603毫秒降至35毫秒左右,性能提升超过1600倍,展示了Cython在高性能计算场景下的优势。
本文对比了Python中 not not x 与 bool(x) 两种布尔转换方式。通过百万次测试发现,not not x 执行更快,因其仅涉及单条指令,而 bool(x) 涉及函数调用开销。尽管 not not x 性能更优,但出于代码可读性考虑,仍推荐日常使用 bool(x)。
本文通过实测对比单线程、多线程、多进程及aiohttp协程四种方式在Python爬虫中的表现。结果显示,处理十万级页面时,aiohttp协程方案比单线程快90倍,多线程提升68倍,多进程提升7倍。文章提供了各方案的代码实现与耗时数据,为提升爬虫并发效率提供实用参考。
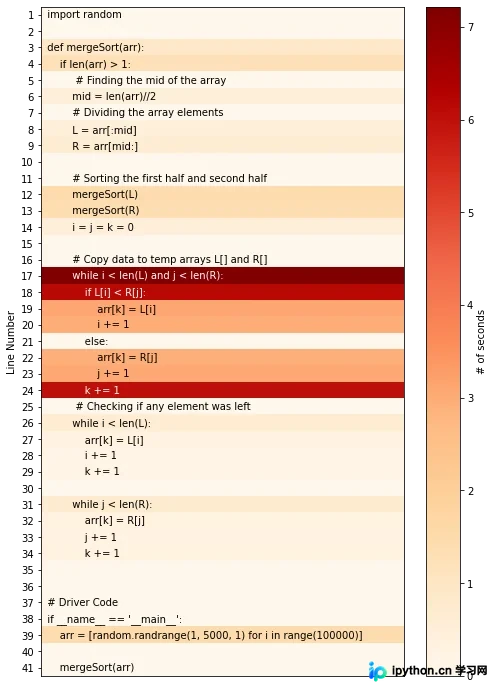
本文介绍了三个用于Python代码性能可视化的开源库:Pyheat、Heartrate和Snoop。Pyheat通过热图展示逐行执行时间,帮助定位耗时代码;Heartrate提供浏览器端的实时执行可视化,显示每行代码的执行次数;Snoop则利用装饰器追踪局部变量和执行流程,辅助调试。这些工具仅需少量代码即可深入分析性能瓶颈。
本文深入探讨Python3中读取文件指定行的三种主流方案。针对大文件场景,对比了基于readline的逐行遍历、linecache模块以及调用系统sed命令的执行效率。测试显示,读取5000万行时,sed方案耗时仅约2.5秒,显著优于纯Python实现的10秒以上耗时,为高性能数据处理提供了实用参考。