Python Pandas Dataframe条件筛选与遍历方法详解
本文详细介绍Python中Pandas库对Dataframe进行条件筛选与遍历的常用方法。涵盖单条件、多条件(逻辑与或)及取反筛选,以及iteritems、iterrows和itertuples三种遍历方式,帮助开发者高效处理数据。
2026-10-15
6

本文详细介绍Python中Pandas库对Dataframe进行条件筛选与遍历的常用方法。涵盖单条件、多条件(逻辑与或)及取反筛选,以及iteritems、iterrows和itertuples三种遍历方式,帮助开发者高效处理数据。
本文详细介绍 Python Pandas 库中 DataFrame 的核心操作。涵盖通过 index 和 columns 获取索引,利用 []、loc、iloc、at、iat 进行元素查询;使用 rename 修改行列索引,通过指定位置赋值修改元素值;以及利用 drop 方法按标签或轴删除行与列,并解析各方法的参数与注意事项。
本文详细介绍Python3中Pandas库处理DataFrame缺失值(NaN/None)的四种核心方法。涵盖使用isnull和notnull进行判断,通过布尔索引过滤含缺失值数据,利用fillna方法按指定策略(如ffill/bfill)或数值填充,以及使用dropna按行或列删除缺失数据。文章包含具体参数说明与代码示例,帮助开发者高效完成数据清洗工作。
本文介绍如何使用Python将本地CSV数据通过pandas写入OpenGauss数据库,并解决中文列名查询时的语法问题。重点讲解了利用sqlalchemy进行数据追加写入,以及使用psycopg2连接数据库时,通过单引号包裹SQL语句、双引号包裹中文列名来正确执行查询的方法,确保数据交互的准确性。
本文深入解析Python Pandas库中DataFrame的stack()、unstack()和pivot()三个核心数据重塑方法。通过具体代码示例,展示如何将列索引转换为行索引(stack),实现逆操作(unstack),以及利用pivot进行灵活的数据透视表构建。文章涵盖多重索引处理、Series对象转换及参数设置,帮助开发者高效处理结构化数据。
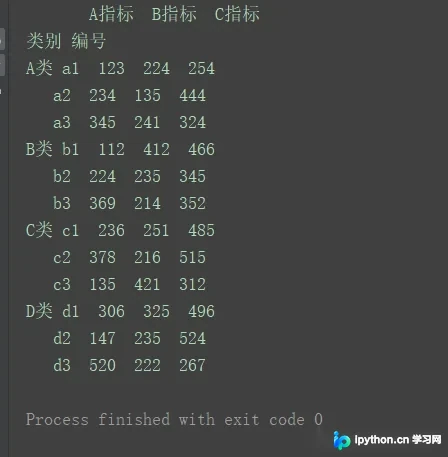
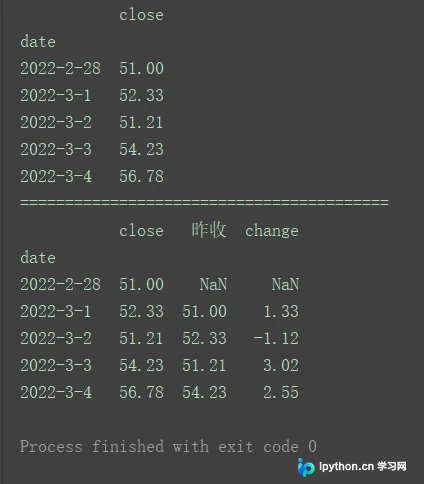
本文详细介绍Python中Pandas库DataFrame对象的shift()方法。通过解析periods、freq和axis三个核心参数,结合正负周期与时间频率的多种组合示例,展示数据前滞与后滞的具体操作。适用于需要处理时间序列数据偏移、计算涨跌幅或进行数据对齐的场景。
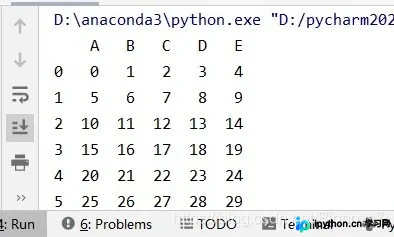
本文详细解析Pandas库中loc和iloc两种核心数据提取方法。loc基于标签索引,支持通过行列名、条件筛选及区域切片获取数据;iloc基于整数位置索引,适用于按物理位置精确提取。文章通过具体代码示例演示了单行、单列、区域及条件读取的操作,并强调切片时左闭右开的区间特性,帮助开发者高效处理DataFrame数据。
本文介绍利用Python将大型CSV数据文件高效写入MySQL数据库的方法。重点解析pd.io.sql.to_sql()函数的使用,包括create_engine连接参数配置及if_exists选项(append、fail、replace)的区别。通过上海公交卡数据实例,展示如何避免内存拥堵并实现数据持久化存储。

本文详解Pandas中DataFrame的数据删除操作,重点讲解drop和del两种方法。通过默认索引和自定义索引两种场景,演示单行、多行及连续列的删除代码与结果,帮助开发者掌握高效的数据清洗技巧。
本文详细介绍Pandas中DataFrame的行列数据提取方法,涵盖按行、按列、按位置及按索引的多种操作。重点解析df.iloc()、df.loc()、df.iat()和df.at()函数的具体用法与区别,通过实例演示如何高效获取连续或不连续的数据块,帮助开发者掌握灵活的数据筛选技巧。
本文详细介绍Pandas中read_sql函数的用法,涵盖将SQL查询或数据库表读取为DataFrame的基本操作。重点解析params参数的两种传递方式:列表与字典,并结合SQLAlchemy连接PostgreSQL数据库,通过具体代码示例展示如何安全高效地传递查询参数,避免SQL注入风险。
本文详细介绍pandas中DataFrame检测重复值的方法,包括duplicated函数的subset、keep参数用法及示例,以及如何通过布尔索引查询和统计重复记录个数。