

Python连接HDFS并返回Dataframe完整教程
本文详细介绍如何在Python环境中连接HDFS,实现文件的读取与写入。通过安装pyhdfs模块,演示了从HDFS读取二进制数据流并转换为CSV,以及利用Pandas将文本文件处理为Dataframe并导出为CSV的具体代码。涵盖Python 3.6与Hadoop 2.9环境下的实际操作步骤,包括本地文件上传至HDFS的方法,为大数据处理提供基础支持。
2026-10-14
6

本文详细介绍如何在Python环境中连接HDFS,实现文件的读取与写入。通过安装pyhdfs模块,演示了从HDFS读取二进制数据流并转换为CSV,以及利用Pandas将文本文件处理为Dataframe并导出为CSV的具体代码。涵盖Python 3.6与Hadoop 2.9环境下的实际操作步骤,包括本地文件上传至HDFS的方法,为大数据处理提供基础支持。
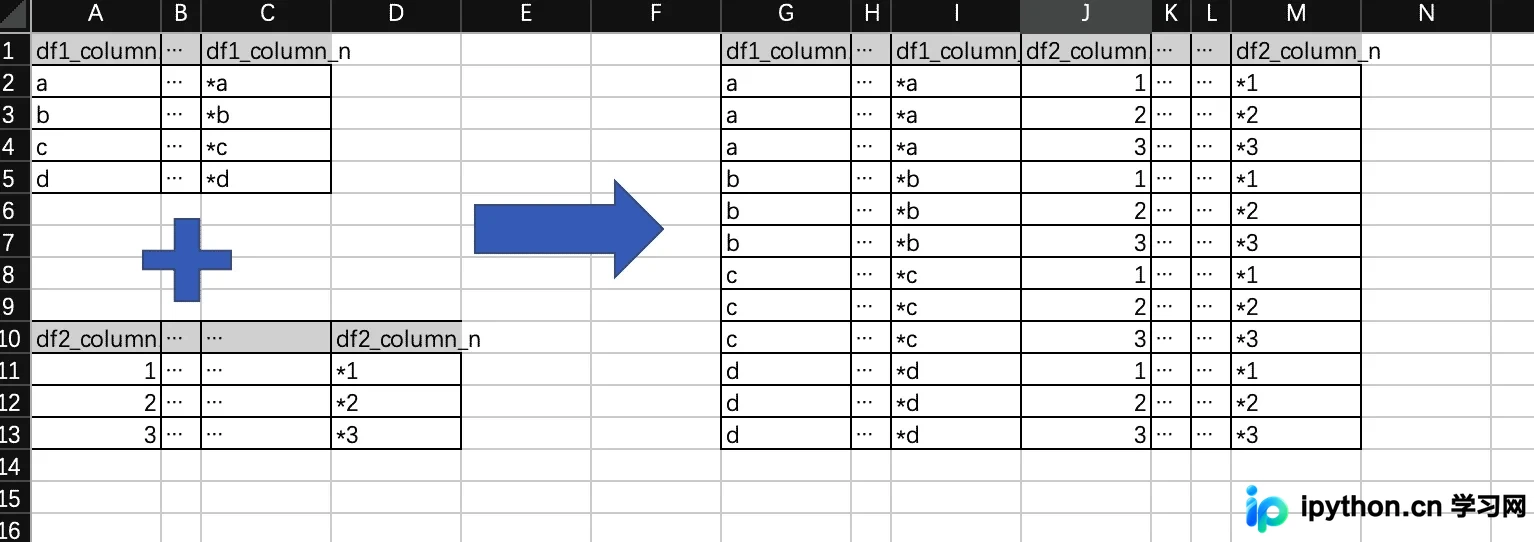
本文介绍如何在Python中高效计算两个Dataframe的笛卡尔积。通过对比双重循环法与基于Merge的优化法,展示了利用Pandas内置功能将时间复杂度从O(m*n)降低至O(n)的技巧,并提供了具体的代码实现与性能测试数据,帮助开发者解决大数据量下的合并性能瓶颈。
本文详解Pandas中将列表转换为数据框的两种场景:多列表合并与嵌套列表转换。通过字典映射和转置操作,展示如何将普通列表或包含子列表的结构高效转化为标准DataFrame格式,适用于数据清洗与预处理环节。
本文详解 pandas DataFrame 的数据选取与切片操作。重点介绍 loc、iloc、ix 及直接索引四种方式的区别与用法,对比布尔索引在 loc 与 iloc 中的表现差异,并指出 ix 已弃用及 chained indexing 风险,帮助开发者高效处理数据。
本文介绍在Jupyter Notebook中解决DataFrame显示过长自动换行或省略的方法。通过调整pd.set_option参数,可自定义整体宽度、高度、最大行列数及单元格内容长度,实现数据表的完整展示与格式化输出,提升数据分析体验。
本文主要介绍如何解决Python中DataFrame打印结果自动换行的问题,通过设置pd.set_option('display.width', 5000)调整显示宽度。同时补充了Python2.7中实现字符不换行打印的三种方法:使用print后加逗号、引用__future__模块自定义end参数以及调用sys模块直接输出,帮助开发者灵活控制输出格式。
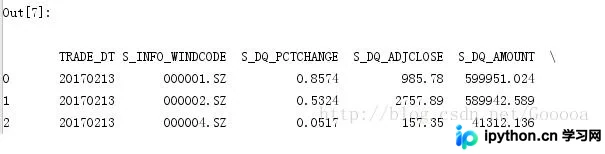
本文介绍Pandas库中DataFrame.rename函数的使用方法,用于重命名数据框的行索引或列名。详细解析了mapper、index、columns、axis等关键参数,对比了两种调用约定,并通过代码示例演示了字典映射与函数转换的实际效果,帮助开发者高效进行数据预处理。
本文介绍如何在pandas中从包含字符串的单元格内提取特定子串。以titanic数据集为例,演示使用str.extract方法配合正则表达式从Name列提取Title并生成新列的操作流程,帮助读者掌握基础的数据清洗技巧。
本文详细解析Python中pandas模块的核心用法,涵盖Series与DataFrame的创建、属性获取及多种索引方式。通过实例演示字典、数组等数据源的转换,深入讲解loc、iloc等高级索引技巧,并指出ix方法的弃用情况,帮助开发者掌握高效的数据处理技能。
本文详细介绍使用Python Pandas库读写CSV文件的各种方法。涵盖基础导入、两种读取方式、按条件读取、正则分隔符处理、行选择、缺失值处理、逐行读取及写入DataFrame等核心操作,并提供完整代码示例,帮助开发者高效处理结构化数据。
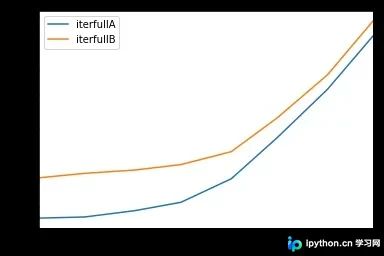
本文详细解析在 Pandas 中遍历 DataFrame 行的多种方法。重点对比了 iterrows()、itertuples()、apply() 以及 iloc 的性能差异与适用场景。文章指出 itertuples() 通常比 iterrows() 更快,并强调避免在迭代中修改数据的重要性,同时提供自定义 namedtuple 迭代器以进一步提升处理效率。
本文介绍在Python Pandas中处理包含Tuple元素的DataFrame的高效方法。针对Word2vec输出的相似度数据,通过applymap结合lambda函数提取元组首个元素,并利用reset_index和rename重构数据结构,实现从索引提取关键词及过滤相似度值,提供比常规循环更优的性能方案。