

Python DataFrame中stack()、unstack()与pivot()方法详解

本文深入解析Python Pandas库中DataFrame的stack()、unstack()和pivot()三个核心数据重塑方法。通过具体代码示例,展示如何将列索引转换为行索引(stack),实现逆操作(unstack),以及利用pivot进行灵活的数据透视表构建。文章涵盖多重索引处理、Series对象转换及参数设置,帮助开发者高效处理结构化数据。
1. stack()方法
stack()函数的主要作用是将列索引(columns)转换为最内层的行索引(rows)。这种描述可能较为抽象,通过以下示例可以直观理解其工作原理:
首先准备一组基础数据,并为其设置双重索引(MultiIndex)。
import pandas as pd
data = [['A类', 'a1', 123, 224, 254], ['A类', 'a2', 234, 135, 444], ['A类', 'a3', 345, 241, 324],
        ['B类', 'b1', 112, 412, 466], ['B类', 'b2', 224, 235, 345], ['B类', 'b3', 369, 214, 352],
        ['C类', 'c1', 236, 251, 485], ['C类', 'c2', 378, 216, 515], ['C类', 'c3', 135, 421, 312],
        ['D类', 'd1', 306, 325, 496], ['D类', 'd2', 147, 235, 524], ['D类', 'd3', 520, 222, 267]]
df = pd.DataFrame(data=data, columns=['类别', '编号', 'A指标', 'B指标', 'C指标'])
df = df.set_index(['类别', '编号'])
print(df)
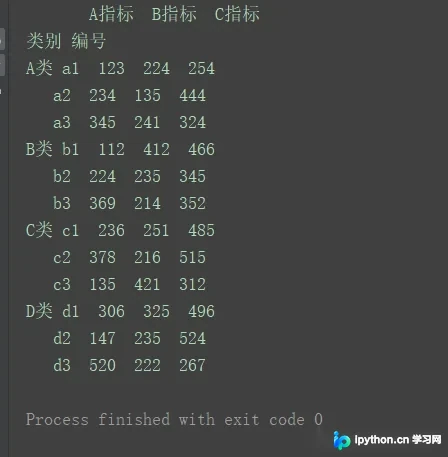
df = df.stack()
print(df)
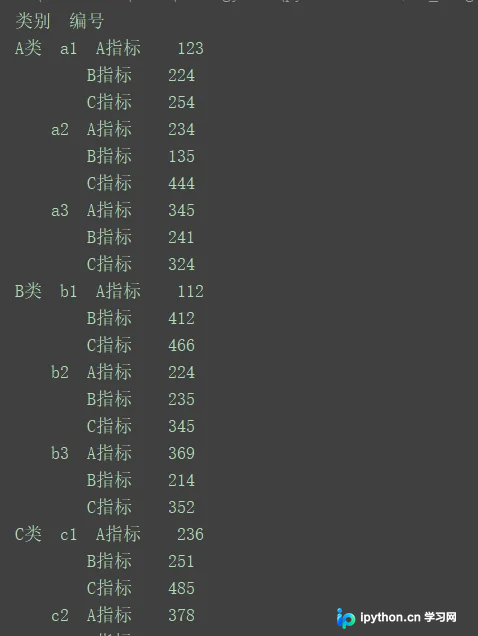
如图所示,经过stack()处理后,原本作为列的A指标、B指标和C指标被堆叠到了同一列中,实现了从宽表到长表的转换。
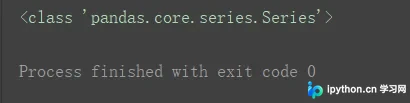
执行stack()后,原DataFrame对象转换为Series对象:
print(type(df))
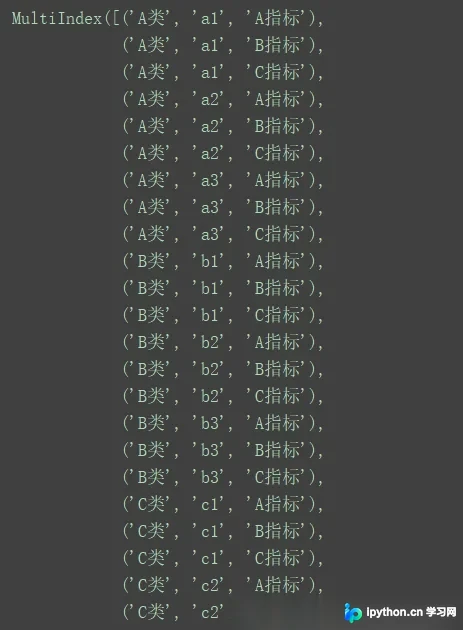
新生成的Series的index结构与原DataFrame不同,它在原有索引的基础上,合并了原列名作为新的层级索引:
print(df.index)
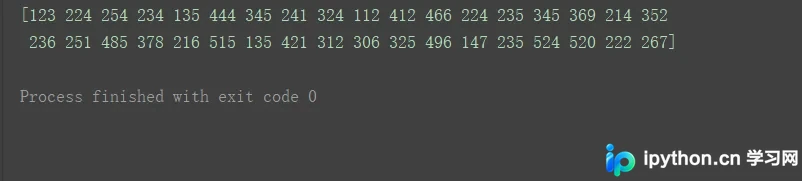
此时的values数组内容如下:
print(df.values)
2. unstack()方法
unstack()是stack()的逆向操作,用于将堆叠后的索引重新展开为列。
基于上述stack()处理后的结果,继续调用unstack()方法:
df1 = df.unstack()
print(df1)
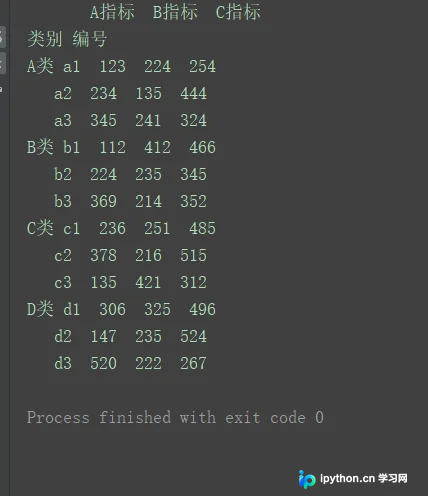
可以看到,数据恢复到了最初的DataFrame形态。
3. pivot()方法
针对上述示例数据稍作调整,演示pivot()的用法:
此处不设置多重索引,直接使用原始数据。
import pandas as pd
data = [['A类', '1', 123, 224, 254], ['A类', '2', 234, 135, 444], ['A类', '3', 345, 241, 324],
        ['B类', '1', 112, 412, 466], ['B类', '2', 224, 235, 345], ['B类', '3', 369, 214, 352],
        ['C类', '1', 236, 251, 485], ['C类', '2', 378, 216, 515], ['C类', '3', 135, 421, 312],
        ['D类', '1', 306, 325, 496], ['D类', '2', 147, 235, 524], ['D类', '3', 520, 222, 267]]
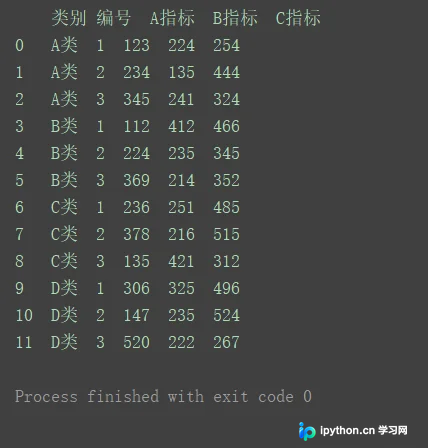
df = pd.DataFrame(data=data, columns=['类别', '编号', 'A指标', 'B指标', 'C指标'])
print(df)
df2 = df.pivot(index='编号', columns='类别', values='A指标')
print(df2)
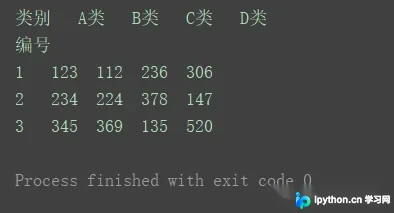
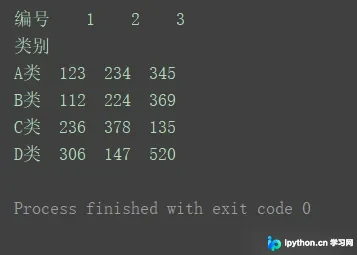
在pivot()函数中,index参数指定哪一列的值作为新DataFrame的行索引,columns参数指定哪一列的值作为列索引,而values参数则指定表格中需要展示的数值指标。
df3 = df.pivot(index='类别', columns='编号', values='A指标')
print(df3)
总结
本文介绍了Python DataFrame中stack()、unstack()和pivot()三个方法的基本用法与区别。如需了解更多关于DataFrame数据重塑的内容,可参考本站相关文章或继续浏览后续内容,感谢支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









